換了模型,agent 的記憶還在嗎:LinkedIn 的受控實驗說平均沒差是假的,拆開方向是 +9.91 和 −13.28,而且八成的損失在寫入時就發生
同一份 agent 記憶,Qwen 寫的筆記給 Llama 讀,比 Llama 自己寫的高 9.91 個百分點。反過來,Llama 寫的筆記給 Qwen 讀,比 Qwen 自己寫的低 13.28 個百分點。
兩個方向平均起來,−1.47。如果你只看平均,結論是「換模型沒差」。
這是 9 月 4 日掛上 arXiv 的 Does Your Agent’s Memory Survive a Model Upgrade? 的核心數字。兩位作者都用 LinkedIn 的信箱署名,首頁沒掛學校或實驗室。論文問的問題很工程:模型幾個月換一次,記憶庫是累積好幾個月的東西,換了模型之後,舊記憶還能不能用、掉多少、能不能修。
這個月剛好是最需要問這個問題的時候。Fable 5.1 和 GPT-6 Astra 接連發布,很多人的 agent 已經換了底層模型,記憶還是舊模型寫的。
30 秒定位
| 項目 | 內容 |
|---|---|
| 論文 | Does Your Agent’s Memory Survive a Model Upgrade? A Controlled Study of Memory Portability,arXiv 2609.05339 |
| 作者 | Ankit Goyal、Jaideep Ray,LinkedIn 信箱 |
| 模型 | Llama-3.1-8B-Instruct 和 Qwen2.5-7B-Instruct-1M,本機固定版本,互為寫手與讀者 |
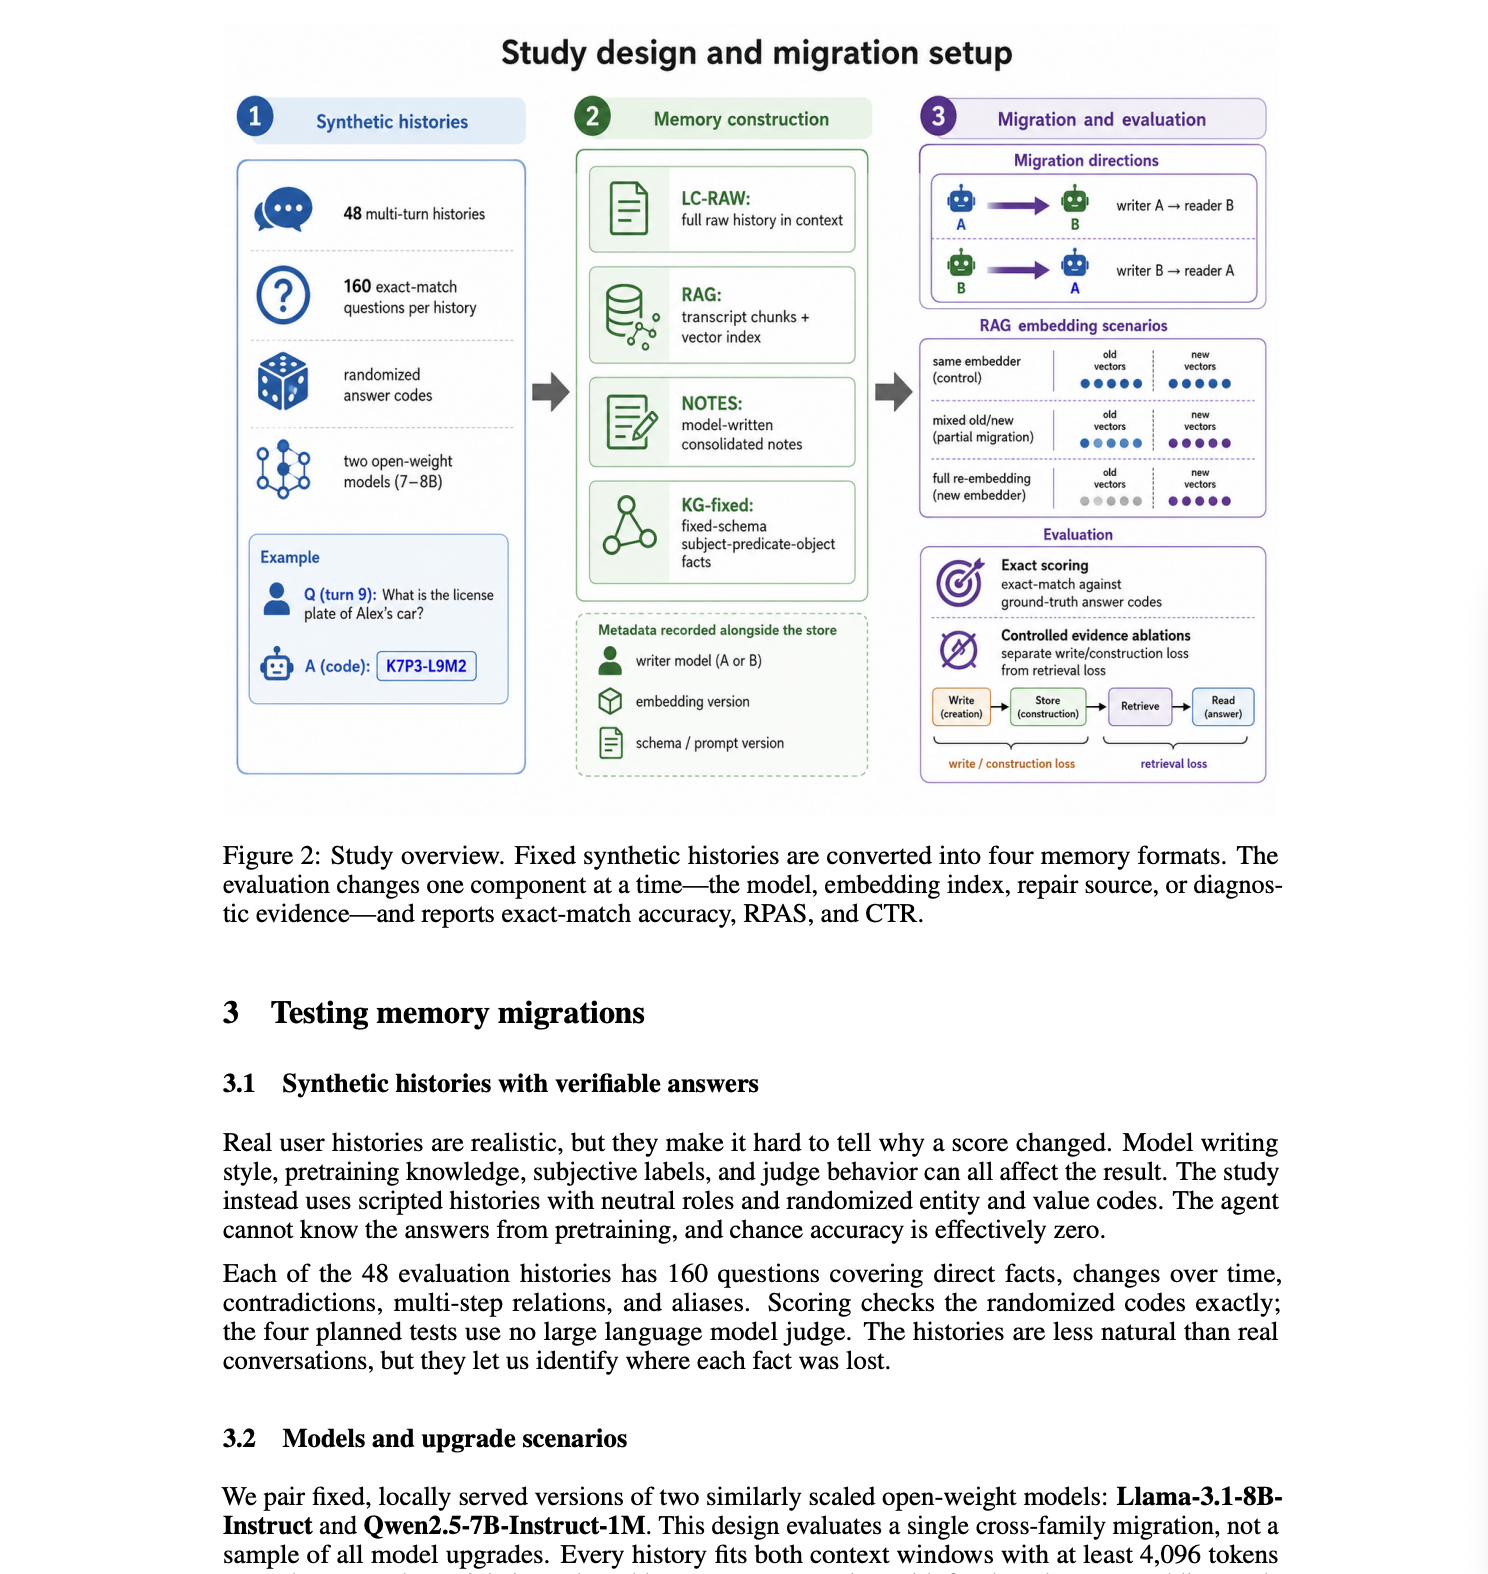
| 資料 | 48 條合成歷史、每條 160 題、答案是隨機代碼、精確比對計分,不用 LLM judge |
| 四種記憶格式 | LC-RAW(整段原始歷史)、RAG(切塊向量檢索)、NOTES(模型壓縮的自然語言筆記,128 KiB 上限)、KG-fixed(固定 schema 的主詞-關係-受詞三元組) |
| Embedding 遷移 | bge-large-en 從 v1.0 換到 v1.5,兩個版本都是 1024 維,混在同一個索引不會報錯 |
| 規模 | 整個研究約 2,900 筆模型回應,修復實驗 1,440 次評估花了 98.2 GPU 小時、約 221 美元 |
| 程式碼 | 要寫信索取,沒有公開 repo |
論文把 agent 記憶拆成四個角色:產生經驗的 actor、把經驗存成記憶的 writer、之後拿記憶回答問題的 reader、負責向量檢索的 embedder。升級可能換掉其中任何一個。實驗設計是一次只換一個,其他全部固定。
傳統做法 vs 這篇的做法
過去的 memory 測評,LoCoMo、LongMemEval、BEAM,測的都是同一個系統「記不記得」。測評羅生門那篇拆過這三件套的盲區。它們有一個共同的隱藏假設:寫記憶的模型和讀記憶的模型是同一顆。
這篇換了問法。它固定歷史不動,換底下的模型:Llama 寫的記憶給 Qwen 讀,跟 Qwen 讀自己寫的記憶比,差多少。這個差值論文叫 Retained Performance After Swap,讀者固定、只有寫手變,所以量到的是遷移損失,不是讀者本身的能力差。
另一個設計選擇是合成資料。48 條歷史全部是腳本生成的,人物和數值都是隨機代碼,模型不可能從預訓練裡知道答案,chance 接近零。代價是它不像真實對話。好處是每一分的損失都能追到是哪個環節丟的。
還有一件在 agent 論文裡少見的事:跑主實驗前,用有數位簽章的 git tag 把四個假設、5 個百分點的門檻、多重檢定校正全部鎖死。四個假設裡兩個沒過門檻,論文照登。
先建立直覺:交接文件是誰寫的
想像你接手一個離職同事的專案。他留下兩種東西:一份他自己整理的「重點筆記」,和完整的 Slack 對話與 commit log。
筆記好不好用,取決於他寫的時候留了什麼。他覺得不重要而沒寫的那個 API 限制,你讀十遍筆記也讀不出來。你用自己的話把筆記重新整理一遍,也不會把那條限制變出來。唯一的辦法是回去翻原始對話。
如果他留的不是筆記,是一張填好的表格,欄位是專案事先定好的:負責人、期限、依賴、狀態。你接手時不用猜他的寫作習慣,因為欄位固定,他只是填值。
論文的四種格式對應這三樣東西。NOTES 是筆記,LC-RAW 和 RAG 是原始對話,KG-fixed 是填好的表格。實驗量的是:換一個人來讀,哪一種掉最多。
第一張表:平均沒差,是兩個大效應互相抵銷
| 格式 | 讀者 | 讀自己寫的 | 讀對方寫的 | 差值(pp) |
|---|---|---|---|---|
| NOTES | Llama | 0.3762 | 0.4753 | +9.91 |
| NOTES | Qwen | 0.4719 | 0.3391 | −13.28 |
| KG-fixed | Llama | 0.8456 | 0.8445 | −0.11 |
| KG-fixed | Qwen | 0.9878 | 0.9880 | +0.02 |
固定 schema 換寫手只動 +0.0004,兩個讀者都一樣。自然語言筆記則看方向:Qwen 寫的筆記給 Llama 讀,比 Llama 自己寫的高 9.91 個百分點;Llama 寫的筆記給 Qwen 讀,比 Qwen 自己寫的低 13.28 個百分點。
論文對這一點的措辭很直接:
“Do not average away the migration direction.”
平均值 −1.47 不是「兩份筆記可以互換」,是兩個方向相反的大效應剛好抵銷。這也是預先登記的假設 H1 沒過門檻的原因:H1 測的是對稱平均的懲罰,估計值 −1.47,離 5 個百分點的門檻很遠。如果作者只報預先登記的結果,這篇論文的頭條會是「筆記可攜」。他們把方向拆開,才看到問題。
為什麼是這個方向?校準階段有一個數字:同樣的預算上限,Qwen 寫的筆記保留 85.6% 的必要證據,Llama 只保留 64.5%,而且 Llama 用掉的空間還比較多。寫手決定什麼進筆記、什麼不進。一個保留率低的寫手留下的筆記,換誰來讀都補不回來。論文的實務規則:
“The practical rule is to test each writer→reader direction and treat the note-writing model’s quality as an inseparable part of the memory design.”
寫筆記的那顆模型是記憶設計的一部分,換寫手等於換記憶。
第二張表:損失發生在哪一段
論文做了一個診斷實驗:先正常讀,再直接把含答案的儲存項目餵給讀者,再直接把原始事件餵給讀者。三個分數的差,就是三段各自丟了多少。
| 格式 | 總損失 | 寫入時丟的 | 檢索時丟的 | 讀者殘差 |
|---|---|---|---|---|
| NOTES | 0.584 | 0.467(80%) | 0.036(6%) | 0.081(14%) |
| RAG | 0.450 | 0.005(1%) | 0.364(81%) | 0.081(18%) |
兩種格式的損失分布完全相反。筆記格式掉的分數,80% 在寫入時就丟了,讀者這端只佔 14%。RAG 的損失 81% 在檢索,儲存的 chunk 本身幾乎沒丟東西:把正確的 chunk 直接餵給讀者,準確率從 0.53 到 0.56 跳到 0.88 到 0.95。
這張表給了一個排錯順序。換模型後 agent 開始「忘記」,工程師的直覺是怪新模型。論文說先別動讀者:筆記格式先量寫入時的證據覆蓋率,RAG 先量檢索的 recall。讀者拿不到的證據,再強的讀者也答不出來。
論文還測了一個很多人會想到的修法:讓新模型把舊筆記照自己的風格改寫一遍。準確率反而掉 0.012 到 0.042。因為問題不是風格看不慣,是內容本來就沒寫進去。
第三張表:embedding 半換半不換是最差的選擇
| 索引 | 準確率 | 相對舊索引(pp) |
|---|---|---|
| 舊 embedding(v1.0) | 0.4257 | — |
| 全部重新 embedding(v1.5) | 0.5447 | +11.90 |
| 一半舊一半新混合 | 0.4753 | +4.96 |
| 理想路由(知道答案在哪個索引) | 0.5960 | +17.03 |
全部重新 embedding 多 11.90 個百分點;一半舊一半新的混合索引只多 4.96,丟掉將近六成的升級收益。這是預先登記的假設 H2,估計值 +6.95,通過。
危險的地方在於它不會報錯。v1.0 和 v1.5 都輸出 1024 維向量,塞進同一個索引,資料庫照常回傳結果,只是舊向量和新向量住在不同的空間,相似度排序整個歪掉。論文的建議是建一個全新的索引、測完再切換;真的要漸進遷移,兩個向量空間要隔開,查詢按索引版本路由。
順帶一提,這個 RAG 設定在換 embedding 之前就有問題:檢索器只有六成的時候撈到正確證據,跟哪個讀者無關。論文明說這是刻意用最陽春的單階段 dense retriever、沒有 reranker,不代表 RAG 的天花板。
第四張表:只靠筆記修不回來,原始資料才是第二次機會
| 修復方式 | 達到 90% 的案例數 | 每案中位成本 |
|---|---|---|
| NOTES,只用既有筆記重寫 | 0 / 48(兩個方向都是) | — |
| NOTES,保留原始歷史重建,Qwen 修 | 34 / 48 | $0.76 |
| NOTES,保留原始歷史重建,Llama 修 | 0 / 48 | — |
| RAG 重新 embedding | 48 / 48 | $0.013 |
| KG-fixed 依 schema 重建 | 91 到 96 / 96 | 接近零 |
只靠既有筆記重寫,48 條歷史沒有一條達到 90% 的恢復目標,兩個方向、三個門檻全部失敗。筆記已經丟掉的證據,再改寫一百次也不會回來。
保留原始歷史再重建,Qwen 當修復模型時 48 條裡 34 條回到 90%,中位成本 0.76 美元;換 Llama 當修復模型,一條都沒救回來,全部撞到輸出長度上限。所以原始歷史是必要條件,不是充分條件:修復模型也要能在它的 context 和輸出限制內把重建做完。
結構化的東西修起來便宜得多。RAG 重新 embedding 48 條全救回,每條約 0.013 美元;固定 schema 重建 96 個案例救回 91 到 96 個,成本接近零。
“Do not discard raw history just because a compact store exists.”
論文也沒迴避代價:留原始歷史有隱私、安全、保存期限的義務。它的建議是加密、限制存取、明確的刪除排程。
跟本 blog 之前幾篇的關係
這是記憶系列的第四篇。羅生門講標準測評測的是「記不記得」;MemHarness講用的時候要重構;LifeMem講存的時候要分群。這篇補的一格是「換模型後還記不記得」,而且它跟 MemHarness 有一個直接的張力:MemHarness 的重構是在讀的時候判斷哪些記憶還適用,但這篇說筆記格式八成的損失在寫入時就發生。讀的時候再聰明,也重構不出當初沒寫進去的東西。兩篇合起來的順序是:先保證寫入時證據有留,讀的時候的重構才有材料。
還有一個看起來不相關的呼應。NVIDIA 跨模型 KV cache 那篇處理的是同一類問題的另一層:KV cache 是模型自己的表徵,換模型就作廢,NVIDIA 用一條線性映射把 KV cache 轉過去,保留 73 到 98% 的準確度。那是「表徵不相容」,可以用映射解。這篇的 NOTES 問題不是表徵不相容,論文測過改寫風格沒用,是內容在寫入時就被丟掉了。同樣是「跟模型綁死」,KV cache 那種可以轉換,筆記那種只能重建。分清楚是哪一種,決定你該找映射還是該留原始資料。
這改變了誰的什麼決策
先講我自己的。我維護 blog 知識庫的 llm-wiki,結構是 173 篇原文 markdown 加上 263 頁機器生成的摘要、26 頁概念、14 頁實體。查了一下 frontmatter,263 頁摘要裡,沒有一頁記錄它是哪個模型寫的。這些摘要的建立日期從 7 月中到 9 月中,期間我用的模型換過,但哪一頁是哪一顆寫的沒有紀錄。
對照這篇論文,摘要頁正是它說最不可攜的 NOTES 格式,而且我連「哪一頁是哪個寫手寫的」都不知道,遷移方向根本無從測起。好消息是原文我有留,每一頁的 sources 欄位都指回 raw 目錄,所以第四張表的修復路徑對我是開著的。
之前的做法是:模型換了,摘要照用,反正讀得懂。看完這篇,四件要改的事:
- 摘要頁加一個 writer 欄位。 論文的 playbook 第四條就是記錄 provenance:模型、prompt、schema、embedding、切塊設定。這是最便宜的一步,而且不做的話後面三步做不了。
- 換模型時抽測,而且分方向。 論文附錄有一個 20 題快篩,跟完整評估的相關係數 0.860,但誤差約 0.10,只能用來擋明顯壞的遷移,不能當驗收。對我來說,換模型後隨機抽二十頁摘要,拿原文出題問新模型,就是這個快篩的手工版。
- 原文永遠不刪。 這條我本來就在做,但原因變了。以前是留著方便查,現在是它是唯一的修復路徑。
- 升級模型後,從原文重新生成摘要。 論文的損失拆解顯示 NOTES 格式 80% 的損失在寫入時發生,瓶頸是寫手不是讀者。舊模型壓縮時丟掉的資訊,新模型再強也讀不回來。所以摘要要當快取處理:raw/articles/ 是資產,wiki/summaries/ 是快取,模型升級就從原文重跑一次,讓新模型用自己的壓縮邏輯重新整理。這比「讓新模型讀舊摘要」或「改寫舊摘要的風格」都有效——第四張表裡,只靠筆記改寫 48 條全部失敗,從原始歷史重建才救回 34 條。
對做企業 agent 平台的人,同樣的邏輯換一個位置。Claude 的 memory 匯出入、Pinecone 和 Weaviate 的索引遷移文件都有,缺的是掉多少分的量測。換模型前先跑一次「新模型讀舊記憶」對「新模型讀自己寫的記憶」,兩個方向各跑一次;換 embedding 就全部重建,不要漸進混用;記憶格式選型時,能填固定欄位的資訊就不要用自由文字存。
反方:這篇證明的可能比看起來少
最強的反駁是規模。Llama-3.1-8B 和 Qwen2.5-7B 是 2026 年沒人拿來當 agent 主力的量級。非對稱效應的來源是 Llama 寫筆記時證據保留率只有 64.5%,一顆 frontier 模型寫筆記的保留率可能接近滿分,那 +9.91 和 −13.28 的差距可能整個消失。論文自己在限制段承認:更大的模型、主觀的真實對話、放不進 context 的長歷史,都可能有不同的可攜性問題。
第二,合成歷史的答案是隨機代碼,考的是精確識別碼有沒有留下來。真實 agent 記憶的價值常在模糊的偏好和脈絡,這種東西的「丟失」很難用精確比對量。
第三,固定 schema 的穩定性是在作者自己為這個合成任務設計的 schema 上測的。論文明說這不代表知識圖普遍可攜。真實世界裡 schema 該長什麼樣本身就是難題,而且 KG-fixed 在診斷實驗裡被排除了,因為單獨餵它的項目反而比正常讀取差。
第四,四個預先登記的假設有兩個沒過。頭條的「非對稱」是事後拆開方向看到的,不在預先鎖定的檢定裡。
我對這幾點的回應:第一點是真的限制,所以這篇文章不引用 +9.91 和 −13.28 當普遍規律,引用的是「方向要分開測」這個方法。這個方法不依賴模型大小。第二、三點縮小的是結論的適用範圍,不是方向。第四點反而是這篇的優點:他們鎖了假設、沒過的照登、事後分析標明是事後分析。這比大多數 agent 論文誠實。
坦白說
這是一篇 7B 級模型上的 48 條合成歷史實驗,兩位作者、一個跨家族方向、程式碼要寫信索取。它的每一個數字都只在它的設定裡成立。
RAG 那段的 40% 檢索失誤率,是刻意用最陽春的設定量出來的,換一個有 reranker 的 pipeline,混合索引的懲罰會不會還有六成,論文沒測。原始歷史修復只在一個方向成功,Llama 當修復模型全軍覆沒,所以「留原始資料」的價值也要看你手上的修復模型做不做得完。
我自己的部分也要講清楚:llm-wiki 那四個改法是從論文推出來的,我還沒做。263 頁摘要沒記錄寫手是查出來的事實,但這些摘要換模型後到底掉了多少分,我沒有數據。等做完抽測再補。
但它做對了一件事。它把「換模型」從一個部署動作變成一個可以量的遷移,而且把損失拆到寫入、檢索、讀取三段。這比又一個宣稱自己在 LoCoMo 上多兩分的 memory 框架有用得多,因為那些分數全部假設模型不會換。
關鍵洞察
模型升級是一次記憶遷移,不是換零件。 論文結論的第一句話就是這個。換模型前先跑「新模型讀舊記憶」對「新模型讀自己寫的記憶」,兩個方向各跑一次,只看平均會漏掉方向相反的大效應。
筆記格式的損失八成在寫入時發生,先量寫手的證據保留率。 換模型後 agent 開始忘事,先別動讀者。筆記格式查寫入時留了多少證據,RAG 查檢索 recall。讓新模型改寫舊筆記的風格,實測沒用。
Embedding 換版本就全部重建,不要混用。 半換半不換丟掉近六成的升級收益,而且不會報錯。要漸進就隔開兩個索引、按版本路由。
原始資料是唯一的修復路徑,但要先確認修復模型做得完。 只靠筆記重寫 48 條全失敗,留原始歷史救回 34 條,換一顆修復模型就一條都救不回。留原始資料的同時,把刪除排程和存取控制寫進設計。
摘要是快取,不是資產。 損失八成在寫入時發生,寫的模型比讀的模型重要。模型升級後,從原始素材讓新模型重新生成摘要,不要讓新模型去讀舊摘要。原文才是資產,摘要隨時可以從原文重建。
記錄 provenance 是最便宜的一步。 每一份記憶是哪個模型、哪個 prompt、哪個 embedding 寫的,現在就記。不記的話,上面五條都做不了。
常見問題 Q&A
Q: 這篇論文在測什麼?
它測的是 agent 的記憶可攜性(Memory Portability):底層模型換了之後,舊模型寫的記憶給新模型讀,掉多少分、能不能修。方法是固定 48 條合成歷史,把記憶拆成寫手(writer)、讀者(reader)、embedding 三個角色,一次只換一個。四種記憶格式對比:整段原始歷史、切塊向量檢索(RAG)、模型壓縮的自然語言筆記、固定 schema 的知識圖。模型是 Llama-3.1-8B-Instruct 和 Qwen2.5-7B-Instruct-1M 互換。
Q: 換模型後記憶「平均沒差」,為什麼論文說這是假象?
自然語言筆記換寫手後的平均變化是 −1.47 個百分點,但拆開方向是 Qwen 寫給 Llama 讀 +9.91、Llama 寫給 Qwen 讀 −13.28,兩個大效應互相抵銷。原因是寫手保留證據的能力不同:同樣的預算,Qwen 的筆記保留 85.6% 的必要證據,Llama 只保留 64.5%。所以遷移要分方向測,不能只看平均。
Q: 換了 embedding 模型,舊向量和新向量混在同一個索引可以嗎?
論文實測不行。bge-large-en 從 v1.0 換到 v1.5,全部重新 embedding 準確率多 11.90 個百分點,一半舊一半新的混合索引只多 4.96,丟掉近六成的升級收益。因為兩個版本都是 1024 維,混在一起不會報錯,但向量住在不同空間,相似度排序歪掉。建議建全新索引、測完再切換;要漸進遷移就隔開兩個索引、按版本路由查詢。
Q: 記憶損失了,讓新模型把舊筆記重寫一遍能救回來嗎?
不能。論文的診斷實驗顯示自然語言筆記(NOTES)格式的損失 80% 在寫入時就發生,讀者端只佔 14%。讓新模型照自己風格改寫舊筆記,準確率反而掉 0.012 到 0.042。只用既有筆記修復,48 條歷史沒有一條達到 90% 的恢復目標。保留原始歷史重建才有機會,Qwen 當修復模型救回 34 條,中位成本 0.76 美元。
Q: 這個結論在大模型上也成立嗎?
不知道。論文只測了 7B 和 8B 兩顆模型、48 條合成歷史、一個跨家族方向,作者自己在限制段說更大的模型和真實對話可能有不同的可攜性問題。非對稱效應的來源是弱寫手保留證據的比例低,frontier 模型可能沒有這個問題。能帶走的是方法:分方向測、拆寫入/檢索/讀取三段找損失、記錄每份記憶的寫手,這些不依賴模型大小。
來源
- 論文:Does Your Agent’s Memory Survive a Model Upgrade? A Controlled Study of Memory Portability,arXiv 2609.05339,2026-09-04
- 本 blog 相關文章:Agent Memory 測評羅生門、MemHarness 記憶重構、LifeMem 先分群再蒸餾、NVIDIA 跨模型 KV cache 映射