Jev 的原理是讓大模型不寫字、直接讀 logit:開源 Laya 零樣本輸它,180 筆 RCA 合成資料微調後 0.496 變 0.921
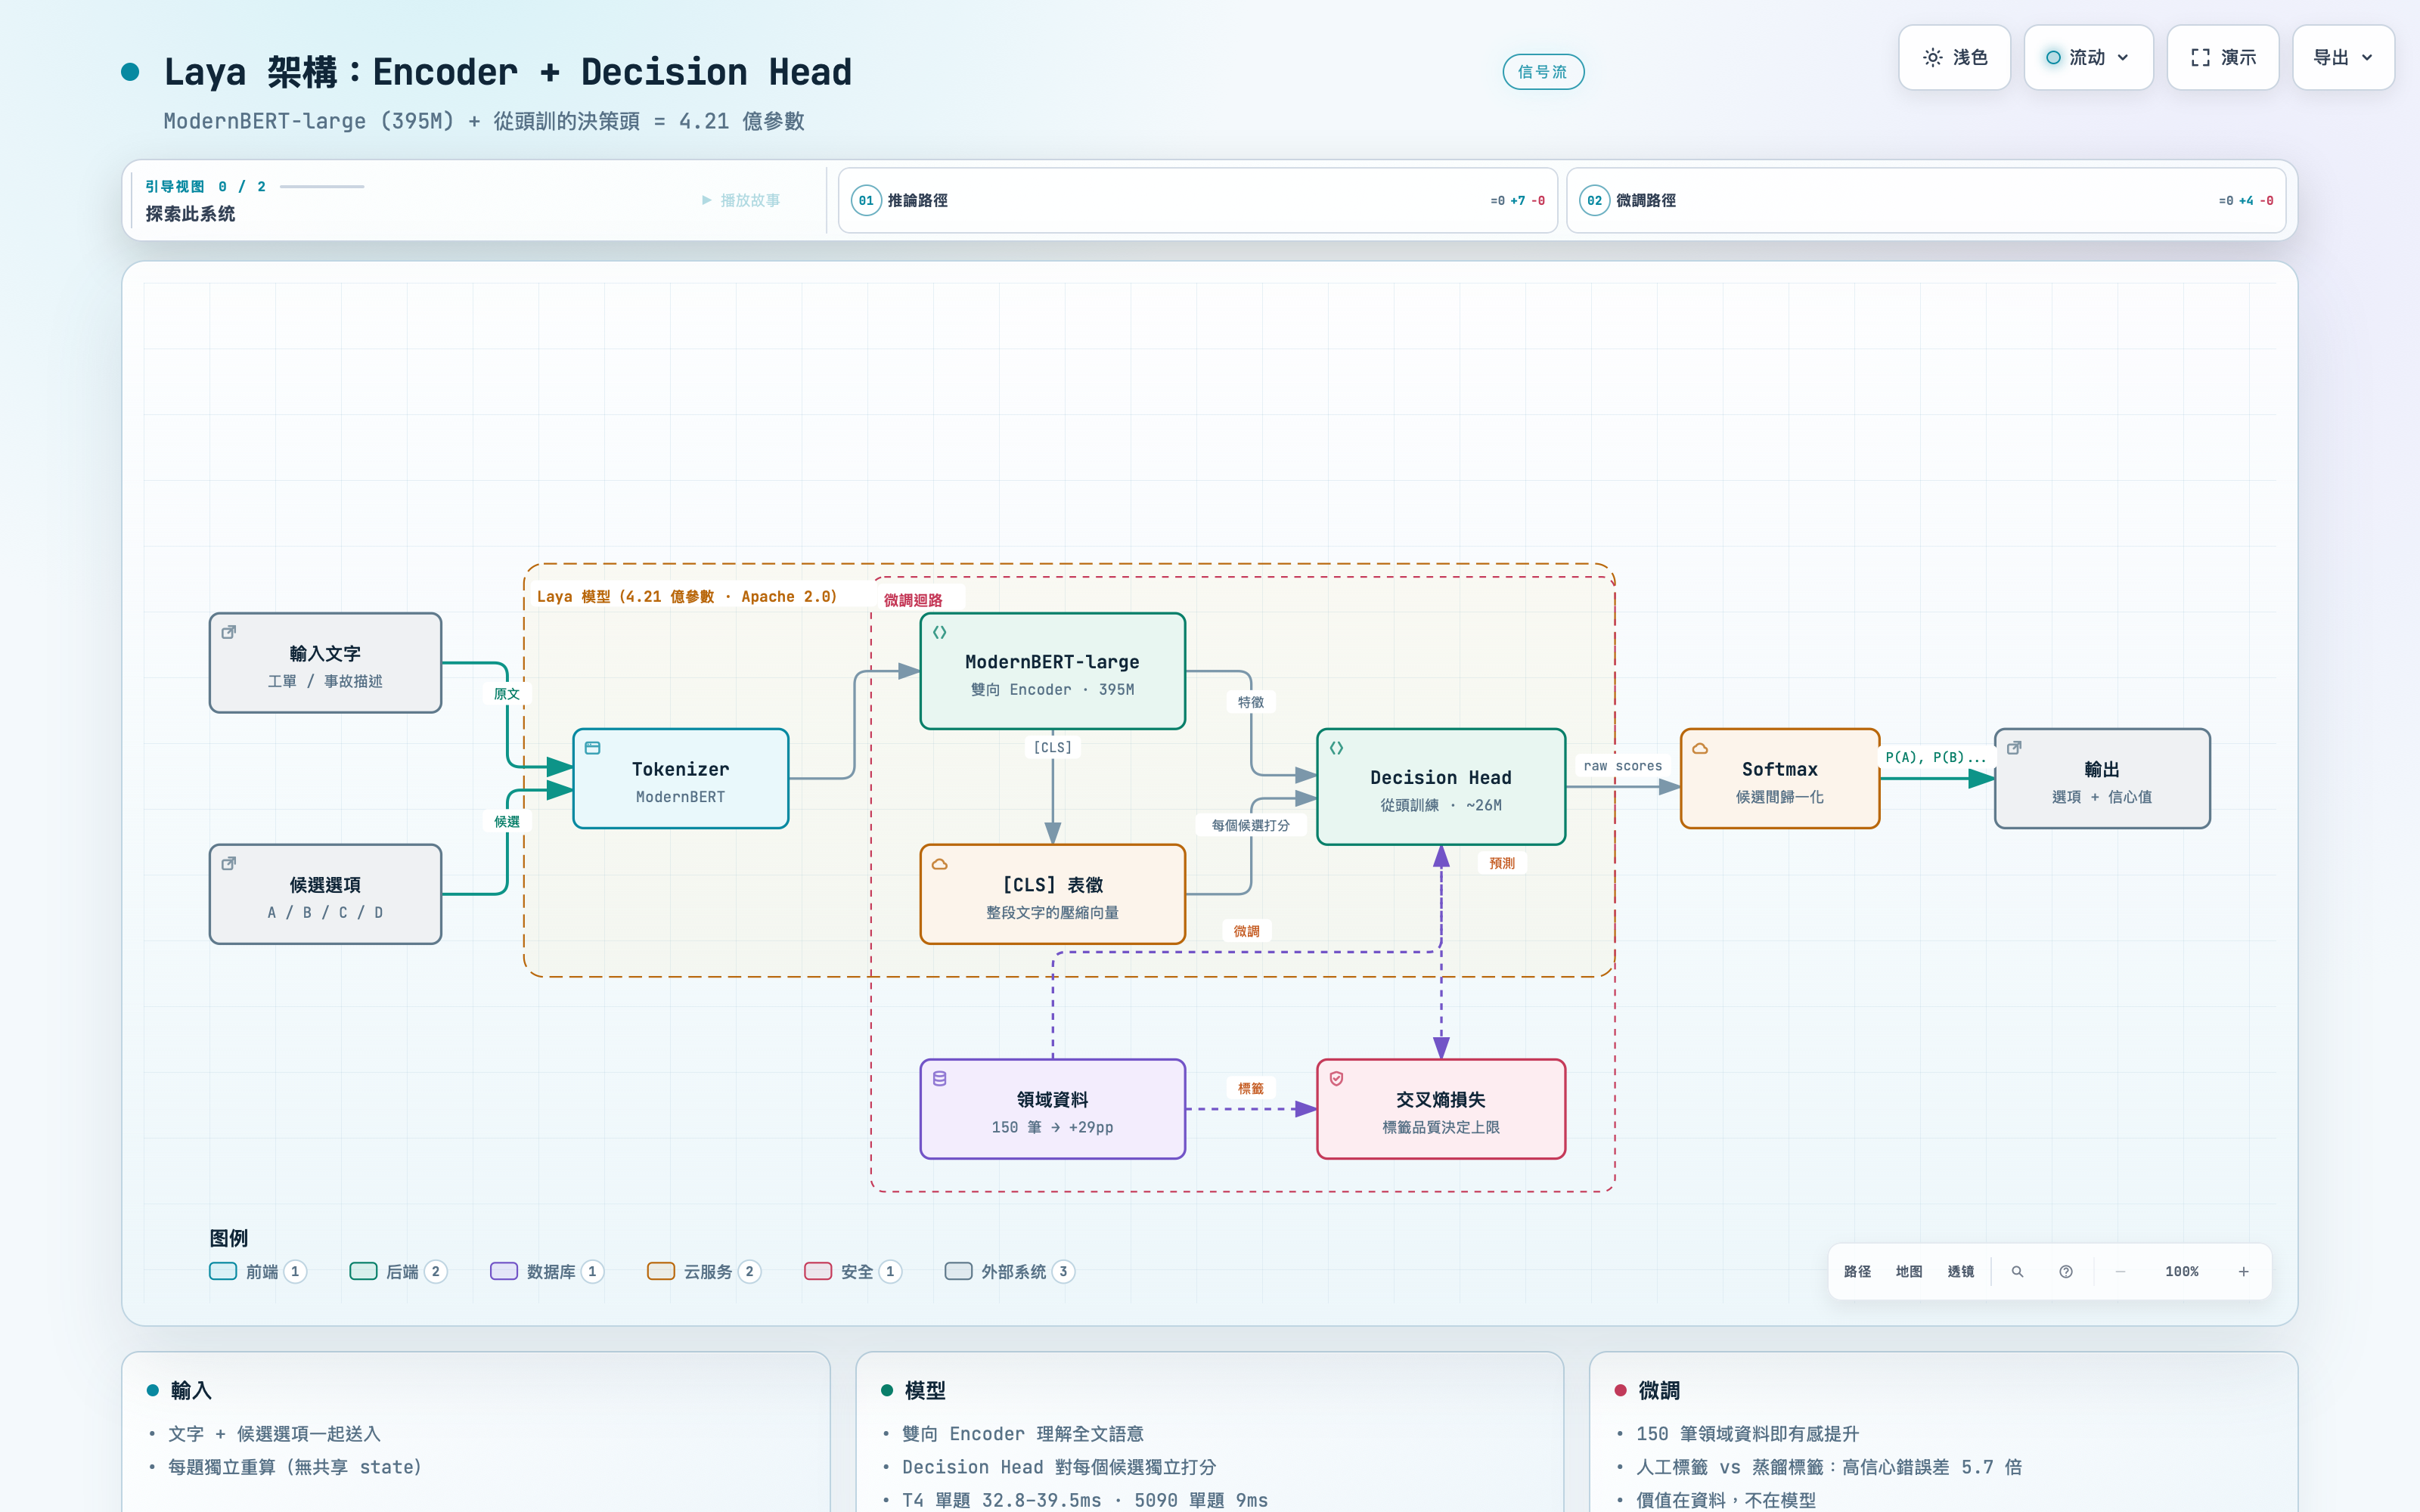
4.21 億參數的 Laya,在 typed-decisions 基準上零樣本拿 0.362。這個基準如果你每題都猜最常見的答案,可以拿 0.461。
換句話說,開源版 Jev 出廠的時候,比閉著眼睛猜還差。
然後我拿 180 筆合成的 RCA 事故資料去微調它,在 RTX 5090 上跑。合成測試集從 0.496 升到 0.921。同一個模型,出廠和微調後像兩個東西。
上一篇〈Jev 把一次 AI 判斷賣成零件〉講的是商業面:判斷被定價成零件之後,錢流到哪裡。這篇回頭拆原理:Jev 怎麼做到不寫字只給機率、開源版走哪幾條路、我自己微調 Laya 看到什麼。最後講兩個判斷,一個關於 frontier lab,一個關於開源。
30 秒定位
| Jev 1.13 | 開源復刻:Qwen3.6-35B-A3B 讀 logit | Laya | |
|---|---|---|---|
| 做的人 | TypeSafe AI | 社群(openjev-sglang 等) | Convai Innovations |
| 底座 | 未公布(逆向推測約 10B active 的 MoE) | Qwen3.6-35B-A3B,35B 總參數、約 3B active | ModernBERT-large 加決策頭,4.21 億參數 |
| 做法 | 平行輸出所有選項機率 | 一次 prefill,讀選項 token 的 logit | 雙向 encoder 加候選打分頭 |
| JevBench v1.0 準確率 | 96.3% | 95.5% | 未列入 |
| JevBench v1.4.1 綜合排名 | 第 1(63.3) | SimpleJev 版第 44(24.9) | 第 36(30.3) |
| 授權 | 閉源 API | 開放權重 | Apache 2.0 |
大模型本來就在算機率
先講一個天天用 ChatGPT 也不一定注意過的事:大模型每吐一個字之前,其實已經把整張字表的每個字都打了分數。
這個分數叫 logit。模型讀完你的輸入,對字表裡的每一個 token 各給一個分數,經過 softmax 變成機率,再從裡面挑一個吐出來。然後把這個字接回輸入,再算一次整張字表,再挑一個。聊天模型寫一段分析,就是這樣一輪一輪跑出來的。
問題在這裡:如果你問的是「這張工單是 A 帳務、B 物流、C 退貨,還是 D 以上皆非」,答案其實在第一輪就算完了。模型在要吐第一個字的那一刻,A、B、C、D 這四個 token 各自的機率已經躺在 logit 裡。後面那一輪一輪的生成,都是在寫解釋給人看。
Jev 這類模型做的事,就是不讓它往下寫。把選項放進 prompt,跑一次前向傳遞,直接把 A、B、C、D 四個位置的 logit 抽出來,只在這四個之間做 softmax,得到一個機率分布。結束。
一個開源復刻專案的 README 把這件事寫得很乾脆:
“reads the logits of the option-label tokens”
讀選項標籤 token 的 logit,就這樣。
工程師的類比大概是這樣:你要知道某個 log 檔裡有沒有 OOM,可以叫 agent 讀完寫一份報告,也可以 grep -c OOM。答案一樣,前者要等、要付字數錢、回來的東西還要再解析一次;後者回一個數字,直接進你的 if。
這個做法順便解釋了 Jev 的三個賣點:
- 快。 只有 prefill,沒有逐字 decode。官方說延遲 70 到 500 毫秒。
- 便宜。 沒有輸出 token,所以只收輸入費,每百萬輸入 token 0.042 美元,輸出不收費。
- 型別安全。 輸出空間被鎖死在你給的選項裡,它不可能回一個選項表以外的東西。
Jev「應該」是這樣做的,但它多做了兩件事
我說「應該」,是因為 TypeSafe 沒公布底座模型、參數量、訓練資料。官方只說它一次平行輸出所有機率,不是一個 token 一個 token 生成,訓練方法叫 RLCD(Reinforcement Learning for Calibrated Decisions),用來取代聊天模型的 RLHF。名字借自 Kahneman 的系統一:快、不推理、直接給判斷。
目前最完整的逆向分析是 Archer Hume 做的。他打了上萬次 API,從延遲、token 計費、選項順序效應去反推,結論是稀疏 MoE 的 causal transformer,active 參數大約 10B。tokenizer 方面,415 個探針裡 348 個跟 Qwen 的 tokenizer 一致,但不是原封不動的 Qwen。他自己也寫了這整件事 “quite speculative”。
在他的推測裡,Jev 比「讀 logit」多做了兩件事:
第一,共享 state、隔離問題。你給一份材料問五個問題,材料只編碼一次,五個問題各自平行去看材料,但問題之間彼此看不到。這讓一次呼叫能問很多題,而且題目之間不會互相帶偏。
第二,校準。RLCD 的目標不是讓答案更討人喜歡,是讓「它說幾成把握,實際就有幾成對」。上一篇講過,沒有校準,把握值就不能拿來設轉人工的門檻,整個零件就不能用。
所以 Jev 的原理可以濃縮成一句:一個大模型,拿掉生成,保留 logit,再用 RL 把 logit 訓到誠實。
開源版走了兩條路
Jev 發布後幾天,社群冒出一整排仿製版。一篇比較文整理了六個,做法差很多:
| 名稱 | 底座 | 做法 |
|---|---|---|
| Laya | ModernBERT-large | 雙向 encoder,候選打分頭,每題各自重算 |
| Kev-0.5B | Qwen2.5-0.5B + LoRA | decoder LLM,共享 state、問題隔離 |
| Nimble | Qwen3.5-9B + LoRA | decoder LLM,讀 next-token logits |
| SemIf | Qwen3.5 4B / 35B | decoder LLM 當 NLI 分類器 |
| DiffusionGemma | Gemma diffusion 版 | 固定槽位,從答案位置抽 logit |
| Jevlike | byte-level 或預訓練骨幹 | encoder 式,每個候選單獨對文件打分 |
比較文的結論是,六個裡只有 Kev 同時做到共享 state 和問題隔離。
把這張表收斂一下,其實就兩條路:
路線一:decoder 大模型讀 logit。 這條最接近 Jev 的推測架構。拿一個現成的聊天模型,不讓它生成,只讀選項位置的機率。好處是底座越大、懂得越多,零樣本就越準。
路線二:encoder 加打分頭。 Laya 走這條。ModernBERT 是 BERT 家族,本來就不是用來生成的,它讀完整段文字,每個選項丟給一個打分頭算分。好處是小、快、便宜,壞處是它懂的世界知識遠少於一個 35B 的大模型。
Laya 是什麼
Laya 是 Convai Innovations 在 Jev 發布四天後放出來的,ModernBERT-large 底座加一個從頭訓的決策頭,4.21 億參數,Apache 2.0。多語版底座是 mmBERT-base。T4 上單題 32.8 到 39.5 毫秒。
model card 頭條寫 typed-decisions 0.766,贏 Jev 的 0.727。但同一份 model card 也老實寫了:英文底座零樣本只有 0.362,低於 0.461 的多數類基線。0.766 是在這個基準自己的訓練集上微調過的結果。model card 的原話:
“Laya is a fast base to specialise, not a zero-shot decision engine.”
Laya 是拿來特化的快速底座,不是開箱即用的判斷引擎。這句話是整篇文章的關鍵,後面會一直回來。
網路上的共識:Jev 真正贏的是準
JevBench 是目前比較像樣的第三方評比。v1.0 在九月十九日測了一輪:
| 系統 | 準確率 | ECE(校準誤差,越低越好) | 中位延遲 |
|---|---|---|---|
| Jev 1.13.0 | 96.3% | 0.027 | 0.65 秒 |
| openjev-sglang(Qwen3.6-35B-A3B) | 95.5% | 0.042 | 0.68 秒 |
JevBench 自己提醒:
“read a gap of about a point between two rows as noise”
差一個百分點左右視為雜訊。換句話說,在這個基準上,Jev 的準度大約等於一個 35B MoE 大模型照路線一的做法去讀 logit。 校準 Jev 還是贏,0.027 對 0.042。
九月二十三日的 v1.4.1 把題目擴到 534 題公開加 308 題封存、82 個系統。Jev 綜合分 63.3 排第一。Laya 排第 36,綜合 30.3,其中 Intelligence 一項 36.1,Jev 是 53.1。
Laya 跟 Qwen3.6-35B-A3B 總參數差了八十幾倍。零樣本打不過,一點都不意外。
我自己試的感覺也是 Jev 比 Laya 準,這是手感,沒有跑成正式對帳。但方向跟 JevBench 一致。
我的實測:在 5090 上把 Laya 微調成 RCA 分流層
我想要的東西很具體:事故發生時,程式先把 log 和 metric 整理好,一個小模型在幾毫秒內判斷「這是哪個子系統的問題、是不是已知故障模式、要不要升級」,把握不夠的轉給人,大模型再寫因果鏈和報告。Laya 負責中間那一段。
零樣本:信心滿格的錯誤
先不訓練,直接問。多語版 checkpoint 在子系統那題,四個 case 全部回 none_of_the_above,信心值全是 1.000。
退化成單一答案,還給滿格把握。對分流層來說這是最危險的失敗模式,因為門檻攔不住它。
微調是必要條件,不是加分項。
量表先對上
先重現官方微調,確認我的流程沒問題。官方 checkpoint 在我機器上跑 0.7685,自己訓的 0.776,跟 model card 的 0.766 對得上。
訓練速度:6,000 個 decision、4 個 epoch,RTX 5090 單卡 4 分 11 秒。算力完全不是瓶頸。
通用判斷帶不動領域判斷
接著只看兩個 RCA 型的 workflow(資安事件、agent trace):
| 訓練資料 | 準確率 |
|---|---|
| 沒訓練 | 0.354 |
| 不相干的另兩個 workflow 600 筆 | 0.378 |
| RCA 150 筆 | 0.646 |
| RCA 600 筆 | 0.751 |
| 全部 1200 筆混合 | 0.745 |
600 筆發票處理加客服的資料,只把 RCA 從 0.354 推到 0.378。150 筆 RCA 資料就推到 0.646。1200 筆混合(其中一半不相干)還輸給 600 筆純 RCA。
通用的判斷能力,不會自動變成事故分流的判斷能力。 這張表是這篇文章後半段所有論點的證據。
自己標 vs 叫大模型標
最後一組用合成事故:12 種故障樣板、隨機化服務名和數字,180 筆訓練、60 筆測試,正確答案由建構決定。
我比較兩種標籤來源:人工真值,和本機 qwen3.6:27b 每筆取樣 5 次投票產生的蒸餾標籤。
| 訓練標籤 | 準確率 | 高信心錯誤率 |
|---|---|---|
| 沒訓練 | 0.496 | — |
| 大模型蒸餾 | 0.738 | 0.0958 |
| 人工真值 | 0.921 | 0.0167 |
兩個發現:
學生準確繼承老師的天花板。teacher 自己平均 0.730,學生 0.738。蒸餾買到的是「把 27B 的判斷壓縮成在 5090 上一次判斷 9 毫秒」,不是更好的判斷。
更麻煩的是高信心錯誤。蒸餾標籤訓出來的,是人工標籤的 5.7 倍。大模型錯的時候,常常五次投票一致地錯,這個錯誤就以「高信心」的形式被學進去。分流層最貴的錯正是這種。
判斷一:Jev 這個概念會被做進 frontier API
回頭看原理那段:Jev 的核心機制是「大模型不生成、只讀 logit」。這件事任何有大模型的人都做得到。社群用開放權重的 Qwen3.6-35B-A3B,發布後幾天就做到 JevBench v1.0 上跟 Jev 差一個百分點以內。
frontier lab 手上有更強的底座、現成的推論叢集、既有的客戶。他們要做一個「只回選項機率、只收輸入費」的模式,工程上沒有門檻。
所以我的猜測是:Jev 這個概念很快會變成 frontier API 裡的一個元件,一個參數、一個模式,而不是一家你要另外串接、跟大模型協作的獨立 API。開發者不會想為了判斷另外接一家、另外管一把 key、另外處理一套計費。
TypeSafe 的真正資產會是 RLCD 的校準功力。但校準也是一個訓練方法,不是物理定律。
判斷二:但開源 Jev-like 的空間更大
Kahneman 的系統一是直覺。直覺從哪來?
資深 SRE 看一眼 dashboard 就說「這是連線池耗盡」,不是因為他比較聰明,是因為他看過太多次。放射科醫師看一眼片子就知道要不要追,也是同一回事。直覺是經驗的壓縮。 系統一快,是因為推理已經在過去做完了,存成了模式。
System 1 模型也一樣。它不推理,所以它能做的判斷只能來自權重裡已經有的東西。frontier lab 的 System 1 權重裡有全世界的公開知識,但沒有你公司的服務清單、你們過去的事故紀錄、你們 SRE 對「這種 log 算不算 database 問題」的共識。
我的實測剛好量到這件事:通用資料 600 筆只換到 2.4 個百分點,領域資料 150 筆換到 29 個百分點。
快速分類要準,要把大量的既有系統知識、獨家資料灌進 System 1 的權重裡。這件事 frontier API 很難替你做,因為資料在你手上,而且你多半不能、也不該把它送出去訓練別人的模型。
所以我的建議啦:開源模型當底座,用自己的標註資料微調。 閉源的 Jev 或未來 frontier 的判斷模式,拿來當基準線和輔助標註工具,但核心分流層的權重要在自己手上。
這也修正了我上一篇的結論。上一篇說判斷變便宜之後,價值往出題人流。往下再挖一層,價值流向的是標註資料:誰手上有標好的領域 case,誰的 System 1 就準。
反方:frontier lab 也可以開微調 API
先攻擊自己。
frontier lab 的底座比 Qwen3.6-35B-A3B 強,如果他們的判斷模式也開放微調,你上傳 150 筆標註資料,拿到的會比自己微調 Laya 更準。開源的優勢在哪?
這個攻擊有一半成立。如果真的出現可微調的 frontier 判斷模式,「底座越大越準」這件事會站在他們那邊,零樣本和微調後的上限都可能比 4.21 億參數的 Laya 高。
但另一半不成立。我的實測顯示,準度的主要來源是領域資料,不是底座大小:通用 600 筆換不到東西,領域 150 筆就換到大半。標籤品質又比標籤數量重要:同樣 180 筆,人工和蒸餾差了 18 個百分點。這兩件事不管底座是誰的都成立。
所以主論點要降級一點。重點不是「一定要開源」,是標註資料一定要自己持有,而且要是人標的。開源模型是目前讓你同時持有資料和權重、在自己機器上 9 毫秒跑完的最直接方式。如果哪天 frontier 的微調條款讓你放心,換底座也不影響你手上最值錢的那份資料。
坦白說
我的 0.921 是合成資料量出來的。合成事故的樣板到標籤是確定性映射,真實事故沒有這麼乾淨,這個數字灌水嚴重。那一組實驗唯一能推論的是相對差距:同樣 180 筆,人工和蒸餾差 18 個百分點,高信心錯誤差 5.7 倍。我到現在還沒接入任何一筆真實事故。
校準我也還沒做好。我自己訓的 checkpoint ECE 0.22,比 Laya model card 引用的 Jev 0.144 差。原因是官方腳本在訓練集上 fit 溫度,fit 出來接近 1.0,等於沒校準。另外選項 11 個以上的題型,出廠信心值直接被標為未校準。在溫度改到 held-out 上 fit 之前,我的把握值不能拿來設門檻。
「Jev 比 Laya 準」這件事,我自己的證據只有手感,正式的數字來自 JevBench 和 Laya 的 model card。Jev 的架構是 Archer Hume 的逆向推測,他自己也說很 speculative。
JevBench v1.4.1 還有一個讓我不太舒服的數字:同樣拿 Qwen3.6-35B-A3B 當底座,SimpleJev 這個版本只排第 44。v1.0 的 openjev-sglang 跟 Jev 差一個點以內,但另一個包法就掉到後段。讀 logit 這個概念容易複製,做好不容易。 我說 frontier lab 會輕鬆吸收它,前提是他們願意花 TypeSafe 花過的功夫。
關鍵洞察
- Jev 的原理是「大模型不生成,只讀選項 token 的 logit,再用 RL 把機率訓到誠實」。 快、便宜、型別安全都是這個機制的副產品。
- 開源有兩條路。 decoder 大模型讀 logit,零樣本準;encoder 加打分頭(Laya),小、快,但一定要微調。
- 通用判斷不遷移。 不相干資料 600 筆換 2.4 個百分點,領域資料 150 筆換 29 個百分點。
- 標籤要人標。 蒸餾標籤會把大模型「一致地錯」學成高信心錯誤,同樣資料量多 5.7 倍。
- 可執行的判斷: 判斷層可以先接 Jev 當基準線,但從第一天就開始累積自己人工標註的領域 case。150 筆是第一個有感的門檻,這份資料比任何一家的 API 都值錢。
常見問題 Q&A
Q: Jev 的原理是什麼?為什麼它不寫字就能給答案?
Jev 是 TypeSafe AI 在 2026 年 9 月發布的系統一模型(System One Model)。TypeSafe 沒公布底座,但從逆向分析和開源復刻看,它的機制是讓大模型跑一次前向傳遞(prefill)之後不往下生成,直接讀出每個選項標籤 token 的分數(logit),只在這些選項之間做 softmax 得到機率分布。另外用 RLCD(Reinforcement Learning for Calibrated Decisions)訓練,讓把握值跟實際準確率對得上。因為沒有逐字生成,官方說延遲 70 到 500 毫秒,只收輸入費,每百萬輸入 token 0.042 美元。
Q: 開源的 Laya 跟 Jev 差在哪?
Laya 是 Convai Innovations 放出的開源判斷模型,ModernBERT-large 底座加一個決策頭,4.21 億參數,Apache 2.0 授權,T4 上單題 32.8 到 39.5 毫秒。它是雙向 encoder 加打分頭,不是大模型讀 logit。英文底座零樣本在 typed-decisions 上只有 0.362,低於 0.461 的多數類基線;在 JevBench v1.4.1 排第 36 名,Jev 排第 1。model card 自己說它是拿來特化的快速底座,不是零樣本判斷引擎,一定要用自己的資料微調。
Q: 有沒有開源模型準度接近 Jev?
有。JevBench v1.0(2026 年 9 月 19 日)裡,用 Qwen3.6-35B-A3B(35B 總參數、約 3B active 的 MoE)讀 logit 的 openjev-sglang 拿 95.5%,Jev 1.13.0 是 96.3%,基準方說差一個百分點左右視為雜訊。校準誤差(ECE)Jev 仍然較好,0.027 對 0.042。但同樣底座的另一個包法 SimpleJev 在 v1.4.1 只排第 44,實作細節影響很大。
Q: 微調 Laya 需要多少資料和算力?
作者在 RTX 5090 單卡上實測,6,000 個 decision、4 個 epoch 訓練 4 分 11 秒,算力不是瓶頸。在 RCA 型任務上,150 筆領域資料就把準確率從 0.354 推到 0.646,600 筆到 0.751;不相干任務的 600 筆資料只推到 0.378。標籤來源比數量重要:同樣 180 筆合成事故資料,人工標籤訓出 0.921,大模型蒸餾標籤只有 0.738,而且高信心錯誤率是人工標籤的 5.7 倍。
Q: 企業該直接用 Jev API,還是自己微調開源判斷模型?
作者的看法是,Jev 這類「只讀 logit」的機制容易被 frontier lab 吸收成 API 的一個模式,但快速分類要準,靠的是權重裡的領域知識,而領域知識在企業自己的資料裡。建議用閉源判斷 API 當基準線,同時從第一天開始累積人工標註的領域 case,核心分流層用開源模型(例如 Laya)加自有資料微調,讓資料和權重都在自己手上。
來源
- TypeSafe AI: Introducing System One Models & Jev
- Archer Hume: Jev’s Architecture Unmasked
- convaiinnovations/laya on Hugging Face
- JevBench v1.0(Benchmark Heaven)
- JevBench v1.4.1(Benchmark Heaven)
- Comparing 6 Open-Source Jev Clones(lilting channel)
- leo-kreisman/Qwen3.6-35B-A3B-JEV
- Laya 官方微調 notebook