Meta 把 Agent 的「決策」和「做事」拆開:同一顆 GPT-5.5,ProgramBench 從 63.7% 拉到 71.5%,但原本的 Agent 只用了 18% 預算就收工
用 Claude Code 或 Codex 跑長任務,你可能看過這種畫面:Agent 跑了一陣子,回報「完成了」,你打開一看,還有一堆測試沒過。
Meta Superintelligence Labs 9 月 29 日的論文〈Thinking Before Thinking: Scaling Agentic Inference Through Meta-Reasoning〉處理的就是這個問題。他們讓 Agent 從頭重建 200 個程式,每題給 1200 次 model call 的預算,比較兩種做法:
- 現在的做法:Agent 在同一個 context 裡,一邊做事一邊決定下一步。
- Meta 的做法:把「決定下一步」抽出來,變成獨立的一輪思考;實際做事交給 worker。
同一顆 GPT-5.5,現在的做法拿 63.7%,Meta 的做法拿 71.5%。
但論文裡我覺得最值得看的不是這個分數,是另一個數字:現在的做法,1200 次預算只用了大約 18% 就宣布完工。它不是做不好,是太早停了。
這幾天中文圈流傳的版本,把這篇講成「讓苦力專心搬磚、讓總監專心指揮」的管理寓言。跟論文對過一遍,有三處要修正:
- 「總監」和「苦力」在論文裡是同一顆模型。拆開的是兩邊各自看到的資訊,不是兩個腦子。
- 「越做越笨」不是論文的結論。論文觀察到的是提早收工。
- 「通過率 70% 以上」只有 GPT-5.5 一組。換成 Opus 4.8,對 Claude Code 只多 1.7 分。
30 秒定位
| 項目 | 內容 |
|---|---|
| 論文 | Thinking Before Thinking: Scaling Agentic Inference Through Meta-Reasoning(arXiv 2609.38147) |
| 機構 | Meta Superintelligence Labs,12 位作者全部掛 Meta Superintelligence Labs,包含 Jason Weston、Gabriel Synnaeve、Rob Fergus、Sanjeev Arora |
| 日期 | 2026-09-29 |
| 核心主張 | 「控制」本身值得一個獨立的推理流程,不該和做事擠在同一步 |
| 方法 | Controller 跑四階段迴圈(Assess → Propose → Evaluate → Dispatch),worker 做事,產出存成 artifact graph |
| 模型 | Gemini 3.1 Pro、GPT-5.5、Opus 4.8,controller 和 worker 是同一顆模型 |
| 關鍵數字 | ProgramBench(GPT-5.5,1200 call):71.5% vs direct control 63.7% vs Codex 58.0% |
| 程式碼 | 論文沒附程式碼 |
一、原本的 Agent 怎麼做決定
論文在 Figure 1 的說明裡,一句話就把問題講完了:
“Current agent designs interleave two cognitive functions, control and object-level work.”
現在的 Agent 把「控制」和「做事」交錯在一起。
具體來說:你用 Claude Code 或 Codex,模型每一步都在同一個 context 裡,看著全部累積的歷史,同時決定兩件事——下一步要幹嘛,以及直接把它幹掉。改檔案、跑測試、讀錯誤訊息、決定要不要換方向、決定要不要收工,全部是同一次 call、同一串歷史。
論文把這種做法叫 Direct Control Agent,拿它當主要對照組。重點是這個對照組設計得很乾淨:同樣的 worker、同樣的預算,只差在控制方式。所以後面看到的差距,不能歸給「換了模型」或「多給了算力」。
二、新做法:一個 controller 指揮、一群 worker 做事
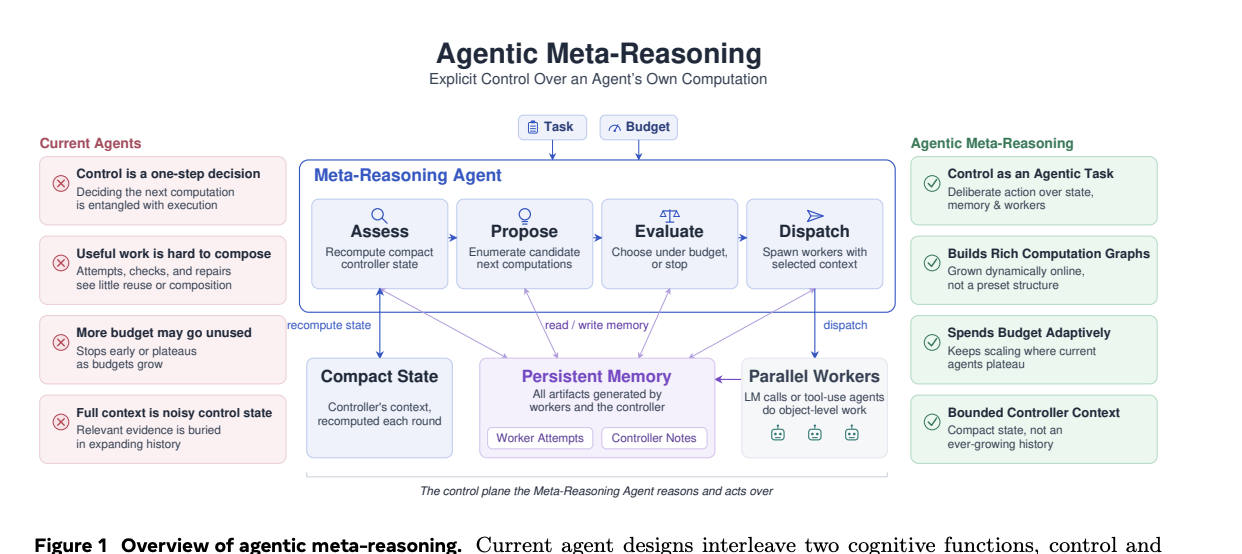
圖:論文 Figure 1。來源:arXiv 2609.38147
這個架構用一句話講:讓總監專心指揮,讓苦力專心搬磚。
總監(controller)只做決定:下一步做什麼、派給誰、什麼時候收工。它自己不動手寫 code,也不帶著整串歷史做決定,眼前只有一頁每輪重寫的進度筆記,加上這一輪苦力剛交回來的成果。苦力(worker)只做事:寫 code、跑測試、寫證明。它不管全局,只拿到總監交代的指令和挑給它的幾份舊成果,做完交回倉庫,等下一輪派工。
拆成元件來看,一共四個:
| 元件 | 負責什麼 | 看得到什麼 |
|---|---|---|
| Controller(指揮) | 決定下一步做什麼、派給誰、什麼時候停。自己不動手做題 | 題目、預算、精簡狀態、這一輪新交回來的產出;需要時再去持久記憶查 |
| Worker(執行) | 實際做事:寫 code、跑測試、寫證明。可以是單次模型呼叫,也可以是會用工具的 Agent,而且能同時派好幾個 | 只有三樣:題目、controller 挑給它的舊產出全文、controller 寫給它的指令。看不到 controller 的狀態和思考過程 |
| Compact State(精簡狀態) | controller 的工作筆記:哪條路有希望、哪裡還沒驗證。每一輪重寫,不是往後追加 | 只給 controller 看 |
| Persistent Memory(持久記憶) | 存放所有產出,包括 worker 交回來的每一份嘗試和 controller 自己的筆記。完整保存,不丟 | controller 按需讀寫;worker 只拿到被挑中的那幾份 |
controller 和 worker 用的是同一顆模型(下一節細講),所以這張分工表真正在分的是各自眼前擺的是什麼。
Controller 每一輪的四個步驟
| 階段 | 問的問題 | 做什麼 |
|---|---|---|
| Assess(盤點) | 我們學到了什麼? | 根據 worker 新交回來的結果,重寫精簡狀態 |
| Propose(提案) | 接下來可以做什麼? | 列出候選的下一步,這一步先不管預算 |
| Evaluate(估值) | 哪個選項值得花? | 拿候選方案對照剩下的預算,挑一個做,或決定停 |
| Dispatch(派工) | worker 該拿到什麼? | 把選中的工作派出去,並決定每個 worker 能看到哪些舊產出 |
worker 做完,產出寫回持久記憶,下一輪 controller 再從 Assess 開始。
這些產出之間的關係記成一張 artifact graph:節點是產出,邊代表「這份產出是拿哪幾份舊產出當基礎做出來的」。後面會看到,這張圖長得多快,是判斷預算有沒有花在刀口上的指標。
兩種做法的 context 差多少
論文量過 controller 每次做決定時看到的內容有多大。direct control 的歷史在最長的 Opus 4.8 IMO ProofBench-Adv run 超過一百萬字元,meta-reasoning 的狀態維持在幾千到幾萬字元。
三、建立直覺:不是請一個總監,是同一個人換帽子
上一節用了總監和苦力的比喻。這個比喻講分工是對的,但錯在一個地方:論文裡 controller 和 worker 是同一顆模型。用 GPT-5.5 的實驗,指揮的是 GPT-5.5,做事的也是 GPT-5.5。沒有請一個更聰明的總監進來。
比較接近的畫面是這樣:一個工程師自己接案、自己動手。原本的工作方式是開著一個越拉越長的聊天視窗,所有嘗試、錯誤訊息、半成品都堆在裡面,每次決定下一步就從頭往下捲。新的工作方式是,每做完一輪就闔上電腦,在筆記本上重寫一頁「目前狀況」:哪個方向有希望、哪個 lemma 還沒驗、還剩多少預算。下一輪只看這一頁決定要做什麼,再把需要的舊檔案翻出來交給「動手模式的自己」。
人沒換。換的是做決定時眼前擺的是什麼。
這也是為什麼我會把它歸進這個 blog 講了半年的 harness 系列,而不是「多 agent 架構」:它沒有加新的智力,改的是資訊流。
四、數字逐一對帳
主表:ProgramBench,1200 次 model call
ProgramBench 是 200 題長程程式重建任務:給你文件和一個只能執行、看不到原始碼的參考程式,要你從頭寫出一個行為一致的完整 codebase,最後用隱藏測試比對。
| 模型 | Meta-Reasoning | Direct Control | 原廠 Coding Agent | mini-SWE Agent |
|---|---|---|---|---|
| GPT-5.5 | 71.5% | 63.7% | Codex 58.0% | 57.6% |
| Opus 4.8 | 67.2% | 65.3% | Claude Code 65.5% | 64.7% |
| Gemini 3.1 Pro | 48.7% | 46.9% | — | 42.0% |
三件事要看清楚:
- 「70% 以上」只有 GPT-5.5 一組。 Opus 4.8 是 67.2%,Gemini 3.1 Pro 是 48.7%。
- 這個百分比不是「整題通過率」,是每題隱藏測試的平均通過比例。71.5% 不代表 200 題裡有七成完全寫對。
- GPT-5.5 對 Codex 多 13.5 分,Opus 4.8 對 Claude Code 只多 1.7 分。 同一套方法,換顆模型,效果差很多。論文自己也承認增益大小取決於模型:Gemini 在推理類 benchmark 受益最大、GPT-5.5 在 ProgramBench 受益最大、Opus 4.8 增益較小但一致為正。
ProgramBench 以外,論文還測了 IMO ProofBench-Advanced、ARC-AGI-2、LongCoT-mini 三個推理類 benchmark。3 顆模型 × 4 個 benchmark,12 組對照全部贏,平均每個 benchmark 多 3.6 到 4.2 分。差距最大的一組是 Gemini 3.1 Pro 在 LongCoT-mini:62.7 vs 53.5,多 9.2 分;同一顆模型在 IMO ProofBench-Adv 也有 91.3 vs 82.7。
真正的發現:原本的 Agent 不是變笨,是提早收工
推文說以前的 Agent「越做越笨」。論文沒有這個結論。論文觀察到的是另一件事:
“Direct control often stops early.”
GPT-5.5 在 ProgramBench 給 1200 次 call,direct control 只用了大約 18%。同一個設定下,meta-reasoning 用掉 89% 到 101%(超過 100% 是因為預算只在每輪之間檢查,已經派出去的 worker 會跑完)。
預算加上去,分數跟著走:
| 預算 | GPT-5.5 Meta-Reasoning | GPT-5.5 Direct Control |
|---|---|---|
| 400 call | 64.1% | 停在 64% 附近 |
| 1200 call | 71.5% | 63.7% |
所以「算力越多越猛」這句話要加一個前提:對 direct control 來說,多給的預算它根本沒在用。 你給它 1200 次,它自己覺得做完了。
但作者也沒有讓「提早收工」變成唯一解釋。Opus 4.8 的 direct control 確實隨預算多用了 call,從 376 用到 768,分數卻只從 62.7% 到 65.3%,而且在中間預算就見頂。作者的結論是:
“Continuing to work is not enough; what the agent does next also matters.”
光繼續做不夠,下一步做什麼才是重點。
Artifact graph:多出來的預算花在哪
GPT-5.5 在 ProgramBench 從 400 call 加到 1200 call,meta-reasoning 的 artifact graph 節點超過 2.5 倍,邊接近 4 倍。direct control 沒有類似成長。
邊比節點長得快,意思是新的工作越來越多是建立在舊產出上,而不是一直從零重寫。兩種做法用的是同一套「選哪些舊產出給 worker」的介面——direct control 做得到,但大多沒有去做。
歷史太長是原因嗎?作者說沒測
中文轉述把原因歸給「上下文太長、被自己的歷史看吐了」。論文的原話保守很多:
“This may be part of why direct control stops improving as its budget grows, though we did not test it directly and isolating the effect would require a separate ablation.”
可能是原因之一,但沒有直接測試,要分離這個效果需要另做消融實驗。一百萬字元的歷史是量到的事實,「因為歷史太長所以變笨」是推論。
五、跟這個 blog 之前講過的東西接起來
Harness 系列的第四個數據點
這半年我們收集了幾個「同模型、只改 harness」的數據:
- 同一顆 Kimi K3,官方 Kimi Code 對開源 Maka 差 10 個百分點
- GPT-5.6 Sol 改兩個設定,ARC-AGI-3 從 13% 跳到 38%
- JIT-Agent 把「寫 harness」訓練成一顆模型
這篇是第四個:同一顆 GPT-5.5、同樣的 worker、同樣的預算,只改控制結構,63.7% 到 71.5%,多 7.8 分。
但它補上了前面三篇沒講清楚的一層。前面幾篇改的是 harness 的「零件」:context 怎麼修剪、推理要不要保留、工具開哪些。這篇改的是 harness 裡負責「決定下一步」的那個迴圈本身——而且證明這個迴圈值得自己花 call 去想。
跟 MemHarness 是同一個道理
八月寫過 MemHarness:給 Agent 加記憶反而變差,問題在「死背」還是「重構」。
Meta 的 controller 每輪重寫狀態,就是重構。direct control 把一百萬字元的歷史整串帶著走,就是死背。兩篇論文從不同方向得出同一個結論:記憶不是越完整越好,是每次決策前要重新整理過。
「何時停」本來就是一個控制決策
上個月寫 OpenAI Agent 越權存取 Medicare 事件 時,重點放在 Agent 碰到阻礙時「不知道該停」。這篇是反過來的病:在還剩八成以上預算的時候「太早停」。
兩個方向的錯,根源是同一個——停不停,是混在做事的同一步裡順便決定的。Meta 的設計把它拉出來,放在 Evaluate 階段,跟剩餘預算一起明確權衡。
六、反方:58.0% 不是你平常用的 Codex
對這篇論文最強的質疑,我認為是基準線的設定。
看論文附錄 I:Codex 和 Claude Code 都跑 headless 模式(codex exec、claude -p),內建工具全關,所有動作只能走同一個 bash 工具。Claude Code 只允許那一個 MCP 工具;Codex 用 --sandbox read-only,改檔案只能靠 heredoc 和 shell 指令。
作者這樣做有道理:讓所有系統在完全相同的工具環境裡比,差距才能歸給控制方式。但代價是,表上的 Codex 58.0% 和 Claude Code 65.5%,不是你每天打開來用的那個 Codex 和 Claude Code。原廠花了大量工程在內建的檔案編輯、搜尋工具上,這些全被拿掉了。
我的回應是:這個質疑削弱的是「Meta 贏了 Codex 13.5 分」這個標題,但不削弱論文的核心比較。核心比較是 meta-reasoning 對 direct control,兩邊用的是一模一樣的 worker 和工具,差的就是控制結構。拿來跟原廠產品比的那一欄,讀成參考就好。
坦白說
這篇論文有幾個地方,會讓我不敢把它的結論直接搬進生產環境。
1. 低預算會輸。 Opus 4.8 在 400 call 時,meta-reasoning 56.6% 對 direct control 62.7%,落後 6.1 分;GPT-5.5 在最小預算也略輸。四階段控制本身要花 call,預算不夠多時賺不回來。你的任務如果是改一個 bug、加一個 API endpoint,這套東西大概只會讓它變慢變貴。
2. 預算單位是 call,不是錢。 論文明說不對 token 成本或執行時間下結論。meta-reasoning 把預算用到 89% 到 101%,direct control 只用 18%——換算成帳單差多少,論文沒有算。另外有一件事是我的推論、論文沒量:controller 每輪重寫狀態,prompt 前綴每輪都變,對 prompt cache 命中率可能不友善。direct control 那種只往後加的歷史,cache 反而好打。
3. 沒有消融。 論文附錄 A 自己寫了:這個比較同時改了精簡狀態、四階段流程、記憶存取三件事,證明的是「整套設計有效」,不知道是哪一塊在起作用。
4. Controller 判斷錯,錯誤會被放大。 論文的限制段原話:
“an incorrect controller assessment can also propagate a misleading state or discard good partial work it never re-reads, and compact state is lossy”
controller 判斷錯,會傳播錯誤的狀態、丟掉它再也不會回頭看的好半成品;而且精簡狀態本來就有損。西洋棋子集是實際案例:多做的檢查反而把原本已經對的答案改錯,作者稱為「unproductive reconsideration」。
5. 沒有程式碼。 論文沒附 repo,目前只能照論文附錄的 prompt 自己重做。
但它做對了一件事:它把 Agent 的預算使用率變成一個可以量的東西。18% 這個數字,比 71.5% 更能改變你怎麼看自己的 Agent。
關鍵洞察
1. 先量你的 Agent 用了多少預算,再決定要不要改架構。 如果它常常提早說「完成了」,問題可能不是模型不夠聰明,是它沒有一個明確的時間點去問「還剩多少預算、值不值得再試一條路」。這個量測不用蓋任何新東西,看 log 就有。
2. 短任務不要蓋這個。 論文的低預算交叉點很清楚:預算不夠大,控制成本賺不回來。這套東西適合的是會跑上百次 call 的長任務——程式重建、證明、長程研究。
3. 可以先偷的是「重寫狀態」,不是整套四階段。 在 CLAUDE.md 或 harness 裡讓 Agent 每隔一段落把「目前進度、哪條路有希望、還剩多少預算」寫成一份短文件,下一輪從這份文件出發,而不是從整串歷史出發。這是成本最低的版本,雖然論文沒有單獨驗證這一塊的效果。
4. 讀二手轉述時,回頭查 controller 和 worker 是不是同一顆模型。 這決定了它是「請一個更強的總監」還是「同一個人換工作方式」。這篇是後者,所以它可以直接套在你現有的模型上,不用多付一顆模型的錢。
常見問題 Q&A
Q: Meta 的 Meta-Reasoning Agent 是什麼?
元推理(Meta-Reasoning)是 Meta Superintelligence Labs 在 2026 年 9 月 29 日論文〈Thinking Before Thinking〉提出的 Agent 推論架構。它把 Agent 拆成兩個角色:controller 負責決定下一步做什麼,worker 負責實際做事。Controller 每輪跑四個階段——盤點(Assess)、提案(Propose)、估值(Evaluate)、派工(Dispatch)——而且只看一份每輪重寫的精簡狀態,不看完整累積歷史。Worker 的產出存成產出圖(Artifact Graph),記錄哪份產出是建立在哪些舊產出上。實驗裡 controller 和 worker 是同一顆模型。
Q: 這個方法讓 coding agent 的通過率真的到 70% 以上嗎?
只有一組數字到 70% 以上:GPT-5.5 在 ProgramBench、1200 次 model call 的預算下拿到 71.5%,同條件的 direct control 是 63.7%,Codex 是 58.0%。Opus 4.8 是 67.2%(Claude Code 65.5%),Gemini 3.1 Pro 是 48.7%。另外,ProgramBench 的分數是每題隱藏測試的平均通過比例,不是整題完全寫對的比例。
Q: 為什麼原本的 Agent 給更多預算也不會變強?
論文觀察到兩個現象。第一是提早收工:GPT-5.5 的直接控制代理(Direct Control Agent)在 1200 次 call 的預算下只用了大約 18% 就停了。第二是加了預算也沒用在對的地方:Opus 4.8 的 direct control 隨預算把 call 數從 376 用到 768,分數只從 62.7% 到 65.3%。作者提到累積歷史超過一百萬字元可能是原因之一,但明確寫了沒有直接測試,所以「上下文太長導致變笨」目前是推論,不是論文的結論。
Q: 什麼情況不該用這種 controller / worker 分離架構?
預算小的短任務。論文裡 Opus 4.8 在 400 次 call 時,元推理 56.6% 輸給 direct control 的 62.7%,因為四階段控制本身就要花 call。另外論文只用 model call 計算預算,沒有比較 token 成本和執行時間,而元推理會把預算用到 89% 到 101%,實際帳單可能明顯更高。如果你的任務是單一 bug 修復或小功能,現有的 Claude Code、Codex 這類 coding agent 更划算。
Q: 論文裡的 Codex 和 Claude Code 跟我平常用的一樣嗎?
不一樣。為了讓所有系統在相同工具環境下比較,論文把 Codex 和 Claude Code 以 headless 模式執行,關掉內建工具,所有動作只能透過同一個 bash 工具(container_bash)進行。所以表上的 Codex 58.0% 和 Claude Code 65.5% 是「工具受限版本」的成績,不能直接當成原廠產品的實際表現。論文最乾淨的比較是元推理對直接控制,兩邊用完全相同的 worker 和工具。
來源: