OSWorld 從 12% 打到 85%,然後 2.0 出來把所有人打回 20%
AI 寫程式碼已經不稀奇了。下一個問題是:它能不能直接操作電腦?
打開 Excel 填報表、登進 ERP 後台匯出資料、在三個應用程式之間切換完成一個工作流——這些事情佔了辦公室裡大量的人力,但 API 不存在、RPA 太脆弱、每家公司的介面都不一樣。如果 AI 能像人一樣看著螢幕、動滑鼠、敲鍵盤把事情做完,那就是數位員工的聖杯:不需要任何系統改造,直接坐上去用。
這個能力叫 computer use。問題是,怎麼評測它?
你不能用 MMLU 那種選擇題,因為 computer use 的輸入是螢幕截圖、輸出是滑鼠座標和鍵盤操作。你不能在模擬器裡跑,因為真實的桌面環境有彈窗、有延遲、有千奇百怪的 UI 狀態。你需要的是一個真實的作業系統、真實的應用程式、真實的工作流,然後讓 agent 從頭做到尾,看它能不能做對。
OSWorld 就是這樣的 benchmark。2024 年 4 月由 XLANG Lab 發布,在真實的 Ubuntu、Windows、macOS 環境裡設了 369 個任務。它是目前 computer use agent 領域最被廣泛引用的評測基準。
發布當天,最強的 GPT-4V 只拿到 12.24%。
兩年後的 2026 年 6 月,最高分數已經到 85%。
看起來問題快解決了。然後 OSWorld 2.0 出來,最強模型拿到 20.6%。
打回原形。
數字先攤在這裡
| 項目 | 數字 | 來源 |
|---|---|---|
| OSWorld 1.0 初始最高分 | GPT-4V 12.24%(2024-04) | 原始論文 arXiv 2404.07972 |
| OSWorld 1.0 最新最高分 | 85%(2026-06) | OSWorld leaderboard |
| Agent S3(1.0 上超越人類) | 72.6%,人類基線約 72%(2025-12) | Agent-S GitHub |
| OSWorld 2.0 任務數 | 108 個長程任務 | arXiv 2606.29537 |
| 2.0 人類中位完成時間 | 約 1.6 小時/任務 | arXiv 2606.29537 |
| 2.0 平均工具呼叫(Opus 4.7) | 318 次(1.0 約 30 次) | arXiv 2606.29537 |
| 2.0 論文最佳(Opus 4.8) | strict 20.6%、partial 54.8% | arXiv 2606.29537 |
| Fable 5.1(Anthropic 八月版) | strict 41.7%、partial 77.9% | Anthropic 發布頁 2026-09-01 |
| Astra(OpenAI Offline 子集) | 72.6% | OpenAI Devs X 貼文 2026-09-03 |
| Sai(Simular 自報) | 73% | Agent-S GitHub 2026-08-28 |
三個分數,三個不同的考卷。下面拆。
OSWorld 1.0:一張被做爛的考卷
OSWorld 1.0 的設計是這樣的:369 個任務,橫跨 Ubuntu、Windows、macOS,涵蓋辦公軟體、瀏覽器、檔案管理、終端操作。Agent 拿到螢幕截圖,用滑鼠和鍵盤操作,完成任務。
2024 年 4 月剛出來的時候,所有模型都慘不忍睹。Claude 3.5 Sonnet 拿到 14.9%,其他的更低。人類在這些任務上的基線大約 72%。
然後各家開始針對性地訓練。
2025 年 12 月,Simular AI 的 Agent S3 達到 72.6%,宣稱超越人類基線。到 2026 年中,最高分已經到 85%。benchmark 的天花板被碰到了——不是因為任務太簡單,而是模型學會了這張考卷的模式。
這是 benchmark 的宿命:只要任務是固定的、可重複的、有標準答案的,模型最終都會學會。問題是,學會考試不代表學會做事。
OSWorld 2.0:把任務拉長十倍
2026 年 6 月 28 日,XLANG Lab 發布 OSWorld 2.0(arXiv 2606.29537,Mengqi Yuan 等 36 人)。
設計思路完全不同。
1.0 的任務平均 30 步,幾分鐘做完。2.0 把它拉到 318 步(以 Claude Opus 4.7 計),人類完成一個任務的中位數時間大約 1.6 小時。將近七成任務需要人類超過一小時。
108 個任務橫跨七個專業領域,用了 31 個自架網站加上桌面應用程式。任務不只是「打開一個 app 做一件事」,而是完整的工作流——需要跨應用切換、理解動態變化的介面、從多個來源拼湊資訊。
Claude Opus 4.8 在 500 步上限下拿到 20.6% 的嚴格通過率(全做對才算),部分分 54.8%。GPT-5.5 用 39K token 到 14% 就上不去了,Opus 4.8 要花 244K token 才換到 20.6%。任務時間超過 163 分鐘的,每個模型的完成率都掉到零。
從 1.0 的 85% 到 2.0 的 20.6%,不是模型變笨了,是考卷變真實了。
三份考卷,三個分數
2026 年 9 月,三家公司幾乎同時發布了 OSWorld 2.0 的成績單。問題是,它們考的不是同一張卷子。
A 卷:Anthropic 自跑,2026 八月任務版
Anthropic 在 2026 年 9 月 1 日的 Fable 5.1 發布頁上報了 OSWorld 2.0 分數:
| 模型 | 嚴格通過率 | 部分分 |
|---|---|---|
| Fable 5.1 | 41.7% | 77.9% |
| Opus 5 | 39.6% | 75.4% |
| Fable 5 | 36.1% | 72.9% |
Anthropic 明確說明這是 benchmark 作者 2026 年 8 月版本的任務集,跟先前公布的 OSWorld 2.0 數字不能直接比較。Fable 5 和 Opus 5 都在同條件下重跑過,所以表內三個數字互相可比。碰到安全護欄的任務直接算零分。
B 卷:OpenAI 自跑,Offline 子集
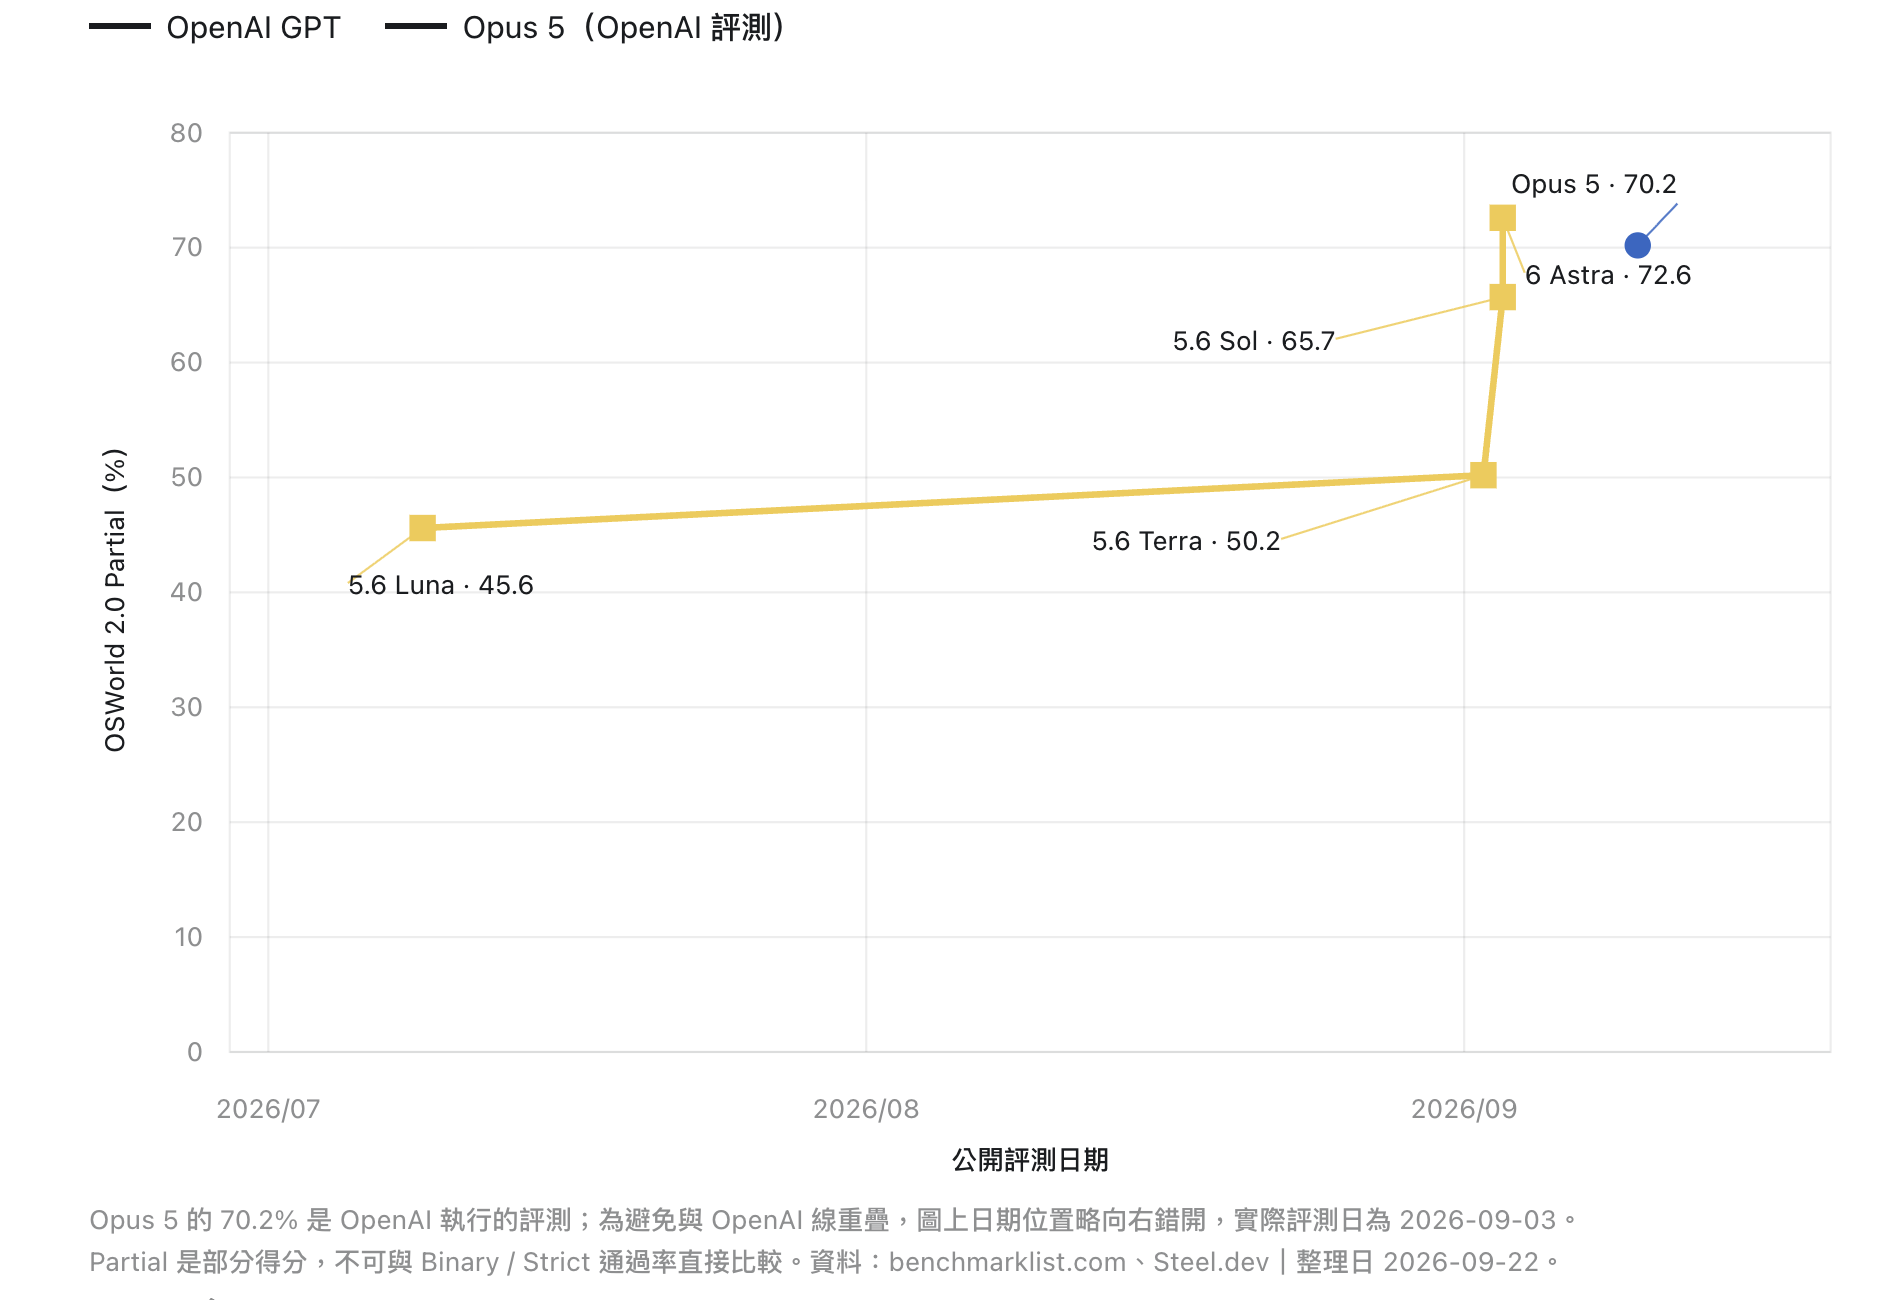
GPT-6 Astra 在 2026 年 9 月 3 日發布,OpenAI Developers 在 X 上寫的是「72.6% on OSWorld 2.0 Offline, which tests desktop tasks without internet access」。
| 模型 | 分數 | 平均單任務時間 |
|---|---|---|
| GPT-6 Astra | 72.6% | 約 40 分鐘 |
| GPT-5.6 Sol | 65.7% | 約 75 分鐘 |
Offline 是什麼意思?完整版用了 31 個自架網站,Offline 把網路相關的任務拿掉了。網路任務通常是最長、最需要跨來源推理的那批——拿掉之後,分數天然偏高。
更關鍵的是,OpenAI 自己沒有說明 72.6% 是嚴格通過率還是部分分。第三方彙整站 benchmarklist.com 把 Astra 的 72.6% 和 Opus 5 的 70.2% 都標記為 Partial(部分分)——如果這個標記正確,那 Astra 的 72.6% 對應的是 Anthropic 那張表的 partial 欄,不是 strict 欄。
這件事本身就說明了問題有多亂:一個廠商公布的頭條數字,要靠第三方站台幫它標註計分方式。而同一個 Opus 5,在 Anthropic 自己手上是 partial 75.4%、在 OpenAI 手上是 70.2%、在 Snorkel 手上是 68.31%。誰跑的、用什麼 harness,直接決定分數。
C 卷:論文原版
六月底原始論文裡的數字,Opus 4.8 strict 20.6%。那是 2.0 最早的任務版本。
三個分數拉在一起比「Astra 72.6% vs Fable 41.7%」?不成立。不同的任務集、不同的計分方式、不同的評測條件。MarkTechPost 在報導 Astra 時也註明 Anthropic 的數字「不該直接比較」。
還有 Simular 的 Sai 自報 73%,但沒有說明用的是哪個任務版本、哪種計分方式,也沒出現在官方 leaderboard 上。
「追平人類 72%」是錯的
好幾篇媒體報導寫 Astra 72.6%「追平人類水準」。
這個 72% 是 OSWorld 1.0 的人類基線。2.0 沒有公布人類成功率。1.0 的任務平均幾分鐘做完,2.0 的任務平均 1.6 小時。把 1.0 的人類分數套到 2.0 上,等於拿國中段考的及格線來衡量大學聯考。
分數高不等於能上線
假設 benchmark 分數是真的反映能力,能不能直接拿去做事?兩篇 2026 年的研究說:還差很遠。
效率問題:步數是人的三到四倍
OSWorld-Human(MLSys 2026 Oral,Abhyankar、Qi、Zhang)評了 16 個 agent,發現即使是最強的 agent,步數也是人類的 2.7 到 4.3 倍。
人做三步的事,agent 要做十步以上。而且後段每一步比前段慢 3 倍,因為規劃、反思、判斷的大模型呼叫吃掉了大部分延遲。一個人幾分鐘做完的任務,agent 可能要半小時,而且越到後面越慢。
準確率好看沒有用,使用者不會等。
可靠度問題:同一題跑兩次,一次過一次不過
「On the Reliability of Computer Use Agents」(arXiv 2604.17849,2026 年 4 月)做了一件很直覺但很少人做的事:讓 agent 在 OSWorld 上重複跑同一個任務。
結果發現同一個 agent、同一個任務、同樣的環境,第一次成功,第二次可能失敗。三個來源:執行過程的隨機性、任務描述本身的模糊、同一 agent 跨次執行的行為變異。
論文的建議:不要看 pass@1,要用重複執行協議評測。一次考試考 85 分不代表你每次都能考 85 分。
Snorkel 的四大失敗類型
Snorkel AI 在 2026 年 9 月 3 日的分析裡,把 OSWorld 2.0 上的失敗歸為四類:
- 漏看任務細節,而且不敢問。 Agent 遇到模糊指令不會要求澄清,直接猜。
- 看不懂陌生介面。 複雜的教學頁面、不熟悉的應用程式,agent 的視覺理解就崩了。
- 沒驗證就宣稱完成。 做到一半覺得差不多了就停手,不回頭檢查。
- 前段資訊到後段丟了。 第 1 到 50 步蒐集的資訊,到第 300 步的時候 context 裡已經找不到了。
第四點最致命。OSWorld 2.0 的任務平均 318 步,這不是 context window 的問題(Astra 有 1.05M context),而是 agent 在長序列裡失去了對早期資訊的有效利用。
這跟我之前寫過的 OS tax 問題形成互補:那篇講的是作業系統的 shell 環境會讓 agent 降級,這裡講的是任務長度本身就會讓 agent 降級。Agent 的真實能力是多個乘數相乘的結果——模型能力只是其中一個。
新架構:拆任務和拆觀察
2026 年上半年出了兩篇值得注意的架構論文,嘗試從不同方向解這些問題。
Multi-Agent Computer Use(arXiv 2606.01533,CMU 的 Koh、Salakhutdinov、Fried,2026 年 6 月):把單一 agent 拆成一個 manager 加多個 worker。Manager 把任務拆解成有向無環圖(DAG),平行 worker 同時執行不同子任務,manager 根據中間結果不斷修改圖。在桌面和網頁任務上提升 3.4 到 25.5 個百分點,Odysseys benchmark 上牆鐘時間快 1.5 倍。
Agent-Computer Observation Interfaces(arXiv 2606.29472,Li & Shi,2026 年 6 月):不改 agent 的動作端,改觀察端。用關鍵幀擷取、語音轉錄、視覺旁白三個管道,把連續的螢幕狀態轉成持久的文字描述。7B 到前沿模型不用重新訓練就提升 17 到 48 個百分點。最有趣的發現是:關鍵幀怎麼選不太重要,把畫面轉成文字才是關鍵——agent 比起「看」螢幕,更擅長「讀」螢幕。
兩篇加起來的啟示:目前 computer use agent 的瓶頸不只是模型智力,還有任務拆解和感知介面的工程問題。
坦白說
這篇整理的數字都是截至 2026 年 9 月 22 日的公開資訊。幾個帳本上要標「不完全」的地方:
OSWorld 1.0 的「85%」來自二手媒體綜述,我沒有直接查到 leaderboard 上的原始列表。Agent S3 和 Sai 的分數是 Simular 自報,沒有獨立第三方驗證。OpenAI 官網的 Astra 頁面抓不到(403),Offline 子集的任務數量和計分規則都是從二手報導推斷的。MindStudio 那個 Opus 5 70.2% 只有一個來源。
更根本的問題是:benchmark 演進的速度和模型演進的速度在賽跑。我寫這篇文章的時候 Fable 5.1 才發布三週、Astra 才發布不到三週,三個月後這些數字大概都會被刷新。這篇的價值不在具體分數,在於「三份考卷不能互比」和「分數不等於可用性」這兩個結構性的判斷。
另一個沒處理的面向是成本。Astra 單任務 40 分鐘的模型推理成本是多少?Fable 5.1 在 77.9% partial 時消耗了多少 token?這些數字會直接影響「能不能上線」的判斷,但目前都沒有公開。
關鍵洞察
- Benchmark 被打穿不代表問題被解決。 OSWorld 1.0 從 GPT-4V 的 12.24% 到 85% 花了兩年,2.0 一出來最強模型只有 20.6%。下次看到「AI 在 X benchmark 上超越人類」,先問:這個 benchmark 的任務跟你的真實工作流有多像?
- 不同考卷的分數不能放在一起比。 Fable 5.1 的 41.7% 和 Astra 的 72.6% 用的是不同任務集、不同計分方式、不同評測條件。如果你要用 benchmark 做採購決策,看的不是誰的數字大,是誰的任務集跟你的場景最像。
- 分數之外至少還有三層距離。 效率(步數是人的 3-4 倍)、可靠度(同一題重跑結果不一致)、長程記憶(300 步之後前面的資訊就丟了)。這三層目前沒有一層被解決。
- 拆任務和拆觀察是目前最有希望的工程方向。 Multi-Agent DAG 拆解和觀察介面文字化,都能在不換模型的情況下提升 17 到 48 個百分點(AOI 論文數字)或 3.4 到 25.5 個百分點(Multi-Agent 論文數字)。模型升級很貴,工程改善相對便宜。
常見問題 Q&A
Q: OSWorld 是什麼?跟其他 AI benchmark 差在哪?
OSWorld 是由 XLANG Lab 開發的 computer use agent 評測基準,測試 AI 能不能像人一樣操作真實的作業系統——打開應用程式、點選選單、填表單、跨應用完成工作流。跟一般 benchmark 用文字或程式碼測不同,OSWorld 在真實的 Ubuntu、Windows、macOS 環境裡跑,agent 透過螢幕截圖感知介面、用滑鼠和鍵盤操作。1.0 版有 369 個任務(2024 年 4 月發布),2.0 版有 108 個長程任務(2026 年 6 月發布),單一任務人類中位完成時間約 1.6 小時。
Q: OSWorld 1.0 跟 2.0 差在哪?
最大差異是任務長度和複雜度。1.0 的任務平均約 30 步,幾分鐘做完;2.0 的任務平均 318 次工具呼叫(以 Claude Opus 4.7 計),人類做一題中位數要 1.6 小時,將近七成任務需要超過一小時。2.0 用了 31 個自架網站加桌面應用程式,任務需要跨應用切換、跨來源推理,更接近真實的職場工作流。1.0 的最高分已被打到 85%,2.0 的嚴格通過率(Strict Pass Rate)最高到 Fable 5.1 的 41.7%(Anthropic 2026 年 8 月任務版)。
Q: GPT-6 Astra 的 72.6% 跟 Claude Fable 5.1 的 41.7% 能直接比嗎?
不能。Astra 的 72.6% 跑的是 OSWorld 2.0 Offline(無網路子集),OpenAI 沒有公布用的是嚴格通過率(Strict)還是部分分(Partial),也沒有說明任務數量。Fable 5.1 的 41.7% 是 Anthropic 用 benchmark 作者 2026 年 8 月版任務集自跑的嚴格通過率。任務集不同、計分方式不明、評測條件不同,三個變數裡至少兩個對不上。MarkTechPost 報導 Astra 時也特別註明這兩組數字不該直接比較。
Q: Computer use agent 現在能實際用在工作上嗎?
有限度可以。簡單、重複、步驟少的桌面任務(填表、匯出報表、搬資料),現有 agent 的成功率已經堪用。但 OSWorld-Human 研究(MLSys 2026)顯示即使最強的 agent,步數也是人類的 2.7 到 4.3 倍,後段每一步延遲是前段的 3 倍。而且可靠度論文(arXiv 2604.17849)指出同一任務重跑結果不穩定。實務上建議用在「失敗了可以重來、不需要人盯著」的任務,不要用在「一次錯就有後果」的操作。
來源
- OSWorld 原始論文(1.0):arXiv 2404.07972
- OSWorld 2.0 論文:arXiv 2606.29537
- OSWorld 2.0 官網
- Introducing Claude Fable 5.1 and Claude Mythos 5.1(Anthropic)
- OpenAI Developers on X:GPT-6 Astra OSWorld 2.0 Offline
- MarkTechPost:OpenAI Releases GPT-6 Astra
- DataCamp:GPT-6 Astra Features, Benchmarks, and Pricing
- MindStudio:GPT-6 Astra’s Computer Use Skills
- Agent-S GitHub(Agent S3 & Sai)
- OSWorld-Human(MLSys 2026 Oral)
- On the Reliability of Computer Use Agents:arXiv 2604.17849
- Snorkel AI:OSWorld 2.0 Why Computer-Use Agents Still Fail
- Multi-Agent Computer Use:arXiv 2606.01533
- Agent-Computer Observation Interfaces:arXiv 2606.29472
- The Hardest Easy Problem in AI(Medium 綜述)