Qwen3.8-Flash-Next 跑在 RTX 5090 + 64GB:Strata 實測 IQ3_XXS vs IQ3_S
又到了保證無聊的 IT 日。
Qwen3.8-Flash-Next 這個模型我想試很久了。看官方 benchmark,很多項目都比我平常用的 27B 更強:
| 項目 | Qwen3.8-Flash-Next | Qwen3.8-27B |
|---|---|---|
| DeepSWE 1.1 | 58.7 | 42.2 |
| JobBench | 55.7 | 33.4 |
| SWE-bench Multilingual | 81.0 | 73.8 |
| Toolathlon Verified | 73.5 | 67.1 |
| SWE-bench Pro | 62.5 | 61.7 |
| GPQA Diamond | 91.7 | 89.2 |
差最多的幾項,都是 agent 類的工作:修 repo、跑工具、做完一整份任務。
但偏偏,我這台 5090 + 64GB RAM,卡在想試卻跑不動的位置。
30 秒定位
| 項目 | 數字 |
|---|---|
| 模型 | Qwen3.8-Flash-Next,8 月 26 日發布,Qwen Community License |
| 參數 | 125B 總參數、每個 token 只激活 6B,另外掛一張 51B 的 n-gram embedding 表和 4B 的 MTP 模組 |
| MoE 結構 | 每層 512 個 expert,每個 token 用 10 個路由 expert 加 1 個共享 expert |
| Context | 原生 262,144 token,官方說可延伸到 1M |
| 引擎 | Strata,Niko1221 開源(MIT),9 月 24 日第一個 commit,9 月 30 日已經是 0.1.30 |
| 量化 | IQ3_XXS(RAM+VRAM 需求 47.0GB)、IQ3_S(54.8GB) |
| 我的機器 | Core Ultra 7 265K、64GB DDR5-4800、RTX 5090 32GB、CUDA 12.9 |
卡住的地方:125B,不大不小
Qwen3.8-27B 的量化版塞得進顯卡,平常也用得順。同一張 5090,八月跑 Qwen3.8-27B 是單人 113.75 tok/s,四人並行總吞吐 425.44 tok/s。
Flash-Next 則是 125B 主幹,每個 token 啟用約 6B,另外還有一張巨大的 n-gram 向量表。整顆塞不進 32GB 的顯卡。
MoE 塞遊戲卡,學術界最新的解法是 FreeToken。8 月 17 日上 arXiv,UC Berkeley 領頭,作者群有 Ion Stoica、Song Han、Matei Zaharia,論文宣稱一張 5090 就能跑 284B 的 DeepSeek V4 Flash,22-25 tok/s。它也支援 Flash-Next,但在我這台機器上跑不起來:
- 它把全部專家放在主機 RAM,論文裡那台 5090 配的是 192GB DDR5
- Flash-Next 它只吃 FP8 或 NVFP4,NVFP4 版的 checkpoint 還有 135GB
- 那張 n-gram 查表,就要 47.7 GiB 釘在主機 RAM
32GB VRAM 加 64GB RAM,總共 96GB。135GB 的模型,一開始就塞不進去。
那就加 RAM?八月我記錄過 32GB DDR5 從約 3,000 元漲到近 13,000 元。為了嘗試一個模型特別花錢升級,我一直下不了手。
直到最近,我發現了 Strata。
Strata 怎麼讓它跑起來
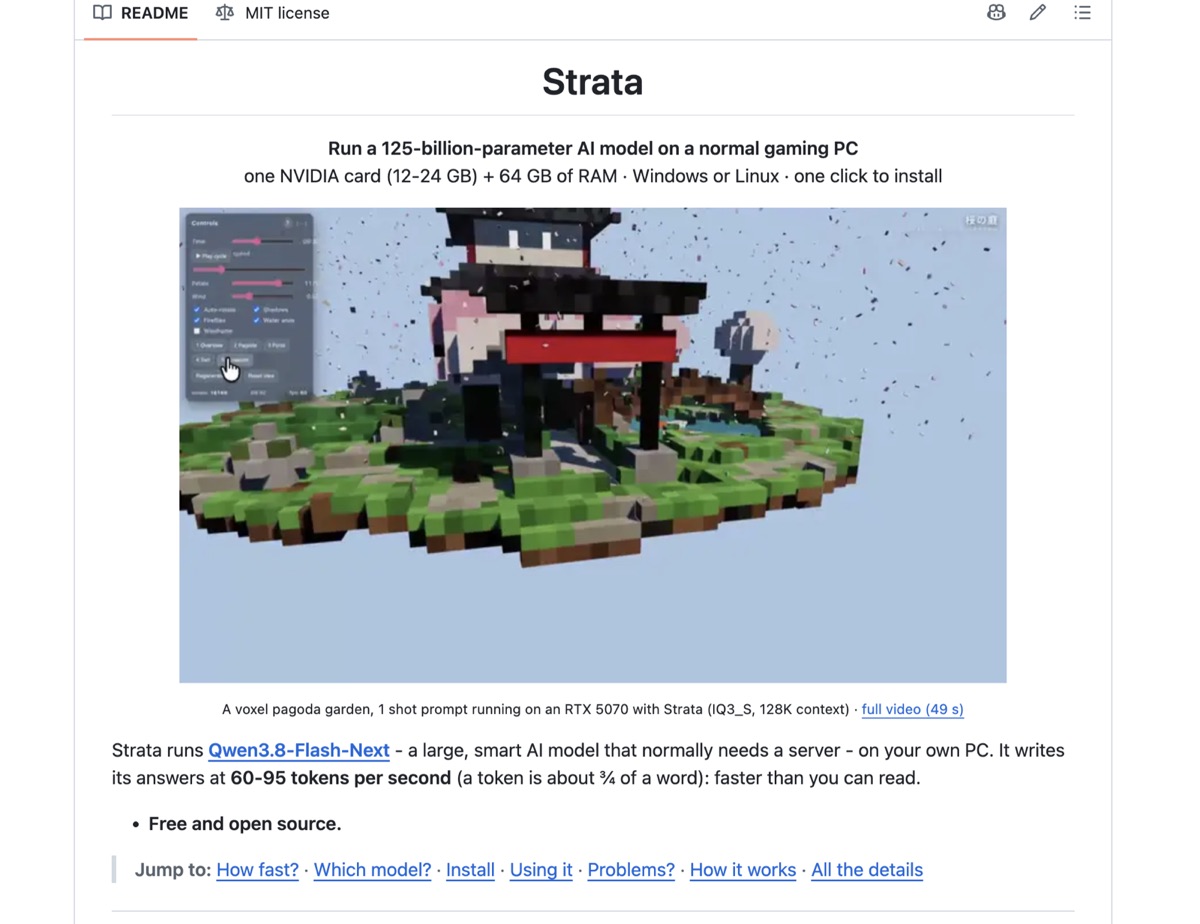
Strata 是一個高手自己做、面向消費級 RTX 20 到 50 系列 PC 的開源推理引擎。README 第一行就寫:一張 12-24GB 的 NVIDIA 卡加 64GB RAM,跑 125B 的模型。GitHub 上 2.9k stars(10/1 看的)。看完才發現,想用大模型、又不想升級整台電腦的人,不只我一個。
它把四種技術整合起來,讓顯卡、CPU、RAM 和 SSD 一起分工。
1. 低位元量化
先用 IQ3 格式把權重壓小。兩個都是 3-bit 量化:
- IQ3_XXS:llama.cpp 定義約 3.06 bit/權重,壓得最兇,RAM+VRAM 需求 47.0GB
- IQ3_S:約 3.44 bit/權重,多留一點精度,RAM+VRAM 需求 54.8GB
這裡用的是 ISTA-DASLab 重新調過的版本,不同層分到的精度不一樣。Strata 作者對 IQ3_S 的形容是品質最好,官方公開測試上跟原版一樣。
2. 專家快取與 CPU/GPU 分工
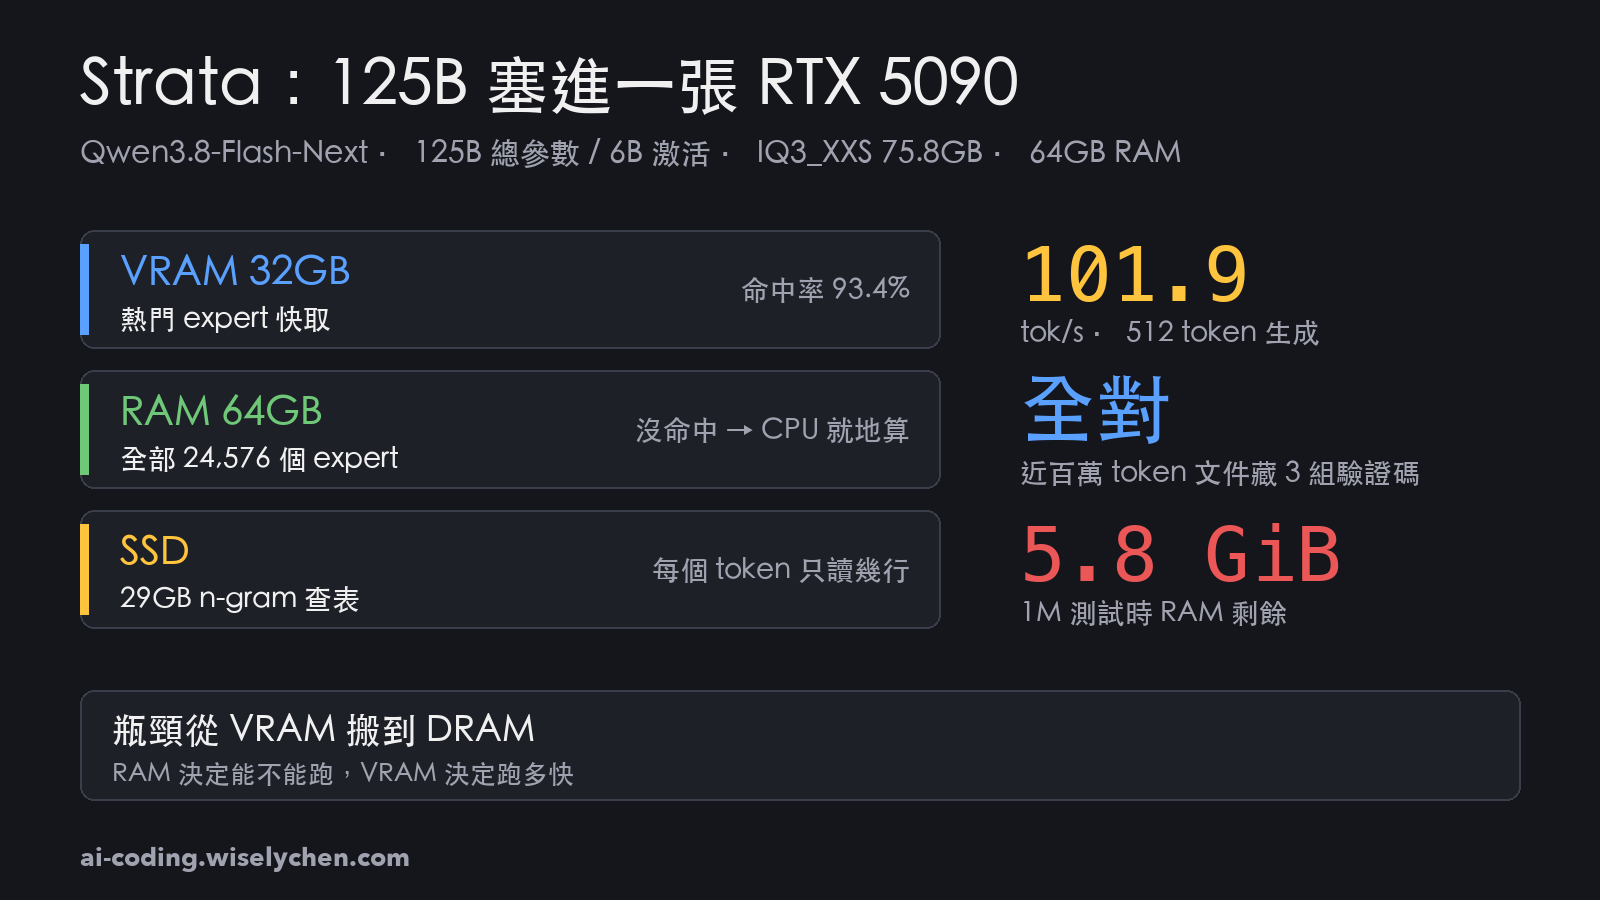
全模型有 24,576 個 expert(48 層 × 512 個),每個 token 只叫 10 個。
- 專家權重全部放在 RAM
- 常用的快取到 VRAM
- 生成時,GPU 算快取裡的專家,CPU 同時處理沒命中的專家
快取還會隨實際使用情況動態調整,讓留在 VRAM 裡的專家更貼近當下的工作。9/30 升 0.1.29 那次的 log 裡,GPU 專家快取命中率 93.4%:100 次呼叫有 93 次在顯卡上就解決了。
這修正了我七月寫 MoE Offload 完全拆解 時的結論:
MoE offload 場景下,速度 = f(VRAM 能留多少 expert)。大 VRAM 不是為了塞下模型,是為了少搬 PCIe。
那時候的前提是 llama.cpp 的做法:沒命中的 expert 搬過 PCIe 給 GPU 算。Strata 的做法是不搬,CPU 就地算。前半句還是對的,VRAM 越大能留的 expert 越多;後半句要改成:大 VRAM 不只是為了少搬 PCIe,是為了少叫 CPU。
3. n-gram 向量表放 SSD
Flash-Next 有一張 29GB 的 n-gram 查表,存的是模型學到的連續 token 組合向量,查出來之後仍要交給模型繼續計算。
FreeToken 把這張表整張釘在 RAM。Strata 把它留在 SSD,需要哪幾行才讀哪幾行。對 64GB RAM 的機器來說,這一步就是能不能跑的分界。
4. MTP 推測解碼
老朋友了。小模型先猜接下來幾個 token,主模型一次驗證,猜對了就一次往前走幾步。作者說快 1.6-1.8 倍;我昨晚那次的 log 是猜了 191 個 token、被接受 76 個,大約四成。
Strata 的價值在整合
CPU/GPU 混合推理、量化、推測解碼,各自都有先例。Strata 的價值,是針對 Flash-Next 的特性把這些方法工程整合起來,讓一台家用電腦的硬體一起分工。
更重要的是,它切中了一群人的痛點:手上有一張好顯卡、RAM 只有 64GB、又不想為了一個模型升級整台機器。
我的實測
機器就是原本那台:RTX 5090 32GB、64GB DDR5-4800、Core Ultra 7 265K。
IQ3_XXS:context 一路開到 1M
先試 IQ3_XXS,Strata 0.1.30,把 context 上限開到 1M:
--rope-scaling yarn --rope-scale 4:把原生 262K 用 YaRN 拉 4 倍--kv q4_0:KV cache 從 int8 降到 4-bit,不然 64GB RAM 放不下
短 prompt、生成 512 token 的那次,速度是 101.9 tok/s。
接著測長文件,業界叫「大海撈針」(needle-in-a-haystack):準備一大堆無關的填充文字,在 10%、50%、90% 的位置各插一句「驗證碼是 violet-harbor-731」這種句子,最後問模型三組驗證碼是什麼。沒真的讀進去就答不出來。
| 文件長度 | 三組驗證碼 | 讀完到回答 | 換算讀取速度 |
|---|---|---|---|
| 30 萬 token(299,513) | 全對 | 76 秒 | 大約每秒 4,000 token |
| 99.9 萬 token(999,490) | 全對 | 344 秒,將近六分鐘 | 掉到每秒 2,900 左右 |
1M token 的輸入真的跑過去了。代價是那次 RAM 只剩 5.8 GiB。
接進 OpenClaw 之後的真實請求,實際 context 約 185K 到 188K,prefill 3,278 到 3,642 tok/s,長輸出生成 87.2 到 89.6 tok/s。
IQ3_S:context 收回 262K
IQ3_S 比 IQ3_XXS 多吃 7.8GB。1M 測試時 RAM 只剩 5.8 GiB,這 7.8GB 塞不進去。所以 context 上限改回 262K,KV 換回 int8,不開 YaRN。
切過去之後,32.81 GiB 的專家常駐 RAM,GPU 快取 9,494 格。
一個多小時接了 41 筆真實 agent 請求:
- Decode(生成)速度中位數 106.8 tok/s,範圍 31.8 到 170.6
- Prefill(讀 prompt)大概每秒 3K 到 4K token(3,160 到 4,250)
- 每筆 prompt 5 萬到 6.7 萬 token,大約 64K
所以這個速度,是實際約 64K 請求的結果,不是塞滿 262K 的測速。而且前面 49,152 token 沿用上一輪讀過的,不能把整份 prompt 都當成重新讀取。
目前我先留在 IQ3_S + 262K。1M 是這次測試的亮點,但日常 OpenClaw 的工作,我選擇多留一點權重精度和記憶體餘裕。
為什麼最後選 IQ3_S
實際用下來,我也感覺到兩版的差別。
IQ3_XXS 在 OpenClaw 裡寫程式、看截圖,比較常碰到一些錯誤。因為 agent 會自動重試,也不太會整個 fail,但就是有一些錯誤訊息。換成 IQ3_S、把 context 收回來之後,這些問題少了很多。
這是我自己的使用觀察。兩次的 context、KV 精度和任務不完全相同,還不能把改善全部歸因於 IQ3_S。
第三方的數字也指向同一個方向。X 上 Nigel Hungerford-Symes(@VectorCrossProd)用同一組 291 題 MMLU-Pro 比較 Strata 的 IQ3_S 和 Unsloth 的兩個較大量化版:
1
2
3
IQ3_S on Strata, 84 GB:     65.3%
UD-Q4_K_XL, 111 GB:         68.4%
UD-Q6_K_XL, 169 GB:        68.7%
他在下一則補了一句:
The 3.5-bit does cost ~3 pts, and it’s real (p=0.02 vs Q6).
壓到 3.5-bit 大約扣 3 分,而且統計上站得住。IQ3_S 已經是 Strata 精度最高的版本,IQ3_XXS 壓得更兇,照常理只會扣更多,但沒有人測過。
對我來說,選擇很直接:比起把 context 撐到最大,我更在意每天做事時,能少出錯、少花時間重做。
那 27B 不就好了?
官方表上 Flash-Next 明顯比 27B 強,差最多的 DeepSWE 1.1 是 16.5 分。但放到我這張 5090 上,要扣掉兩件事:
- 量化折扣:官方分數是原版模型,我跑的是 3-bit。上面 MMLU-Pro 的例子,IQ3_S 就扣了大約 3 分。
- 一次只回一個請求:Strata README 寫得很清楚,它一次只回一個請求。27B 用 SGLang 可以四個人同時用,總吞吐 425.44 tok/s。
所以如果問題是「幫小團隊架一台共用的 coding server」,答案還是 27B dense。它整顆住在 VRAM、不吃 RAM、能並行。
Strata + Flash-Next 的位置是單人的個人 agent 機:一個人、一個 agent、要更強的模型,必要時一次把整個 repo 塞進去。
瓶頸從顯卡搬到了記憶體
Strata 把對 VRAM 的需求壓下去了,壓力轉到 DRAM。
以前在 5090 上規劃模型,問的是「32GB VRAM 塞得下什麼」,答案是 27B dense。現在多一條路,但要先問「RAM 夠不夠放全部專家」:
- RAM 決定能不能跑:IQ3_XXS 要 47.0GB、IQ3_S 要 54.8GB 放專家
- VRAM 決定跑多快:能快取多少熱門專家,就少叫多少次 CPU
而 RAM 剛好是這半年漲最兇的東西。64GB 對這個模型是「剛好夠」,不是「很寬裕」:IQ3_XXS 開 1M 剩 5.8 GiB,IQ3_S 多吃 7.8GB 就得放棄 1M。
開源的威力
回頭看這整件事,沒有一個環節是同一家公司做的:
- Qwen 把 125B 的權重放出來
- ISTA-DASLab 把它壓到 3-bit
- 一個人花一週寫出 Strata,站在 llama.cpp 的肩膀上,MIT 授權
- X 上有人自己跑 291 題 MMLU-Pro 幫大家驗品質,有人順手送 PR 讓舊顯卡也能跑
- 然後我在一張 5090 上,把它接進自己每天在用的 agent
雲端模型便宜歸便宜,但是廠商到最後要 IPO,Codex、Claude 還是會漲價。
反觀半年前投資的這台 5090 沒變。它的價格倒是從 10 萬、12 萬、17 萬,一路漲到現在 22 萬。模型從 Qwen 3.6 27B、Qwen 3.8 27B 換到 Qwen 3.8 Flash Next,Artificial Analysis 智力指數從 21、34 到 40。
機器還是那個機器,智力卻一路往上長。
坦白說
這篇的數字有幾個很明顯的限制。
第一,benchmark 是 Qwen 官方自己的表。 我自己沒有跑品質 benchmark,只有算術、tool call、看圖、找驗證碼這種「能跑、沒壞」的測試。9/28 讓它寫一個 merge_intervals,過了 5 個邊界案例,但漏寫了我明確要求的測試範例。
第二,IQ3_S 比較少出錯,是使用觀察,不是對照實驗。 兩段時間的 context、KV 精度、任務都不一樣。兩版真實請求的速度也一樣不是同條件:IQ3_XXS 那邊的 context 是兩倍長。
第三,1M 是硬撐出來的。 模型原生訓練到 262,144,1M 是 YaRN 延伸 4 倍;KV 降到 q4_0,Strata 自己的測試顯示文件類 perplexity 在 1K 多 8%、8K 多 12%。三組驗證碼全對,只代表它「找得到」一句明顯的話,不代表它「讀得懂」整份文件。
第四,Strata 是一個人、一週的專案。 一週三十個版本,代表迭代很快,也代表明天的版本可能改掉今天的行為。我每一版都留了前一版的 engine 和 config 備份。
但它做對了一件事:它證明了「32GB 顯卡 + 64GB RAM 跑 125B MoE」不是 demo,是可以每天開著用的服務。 9/28 起它就是我 mini 上 OpenClaw 的預設模型。
關鍵洞察
MoE 時代,地端的瓶頸從 VRAM 移到 DRAM。 規劃機器時先問「RAM 夠不夠放全部 expert」,再問「VRAM 能快取多少熱門 expert」。
同一個模型,量化版本的選擇就是 RAM 的分配。 64GB 上,IQ3_XXS 換到 1M context,IQ3_S 換到精度。日常跑 agent,少出錯比 context 長更值錢。
選模型看場景。 多人共用的 server 選 27B dense;單人、要更強模型的個人 agent,才是 125B MoE + Strata 的位置。
雲端的智力是租的,租金會漲;地端的機器是買的,智力會漲。
附錄:實測數據
所有數字都在同一台機器:Core Ultra 7 265K、64GB DDR5-4800、RTX 5090 32GB、CUDA 12.9。速度都是單次量測。
| 日期 | 版本與設定 | 數字 |
|---|---|---|
| 9/28 | 0.1.14、IQ3_XXS、32K、int8 KV | 短請求 87.7 到 118.8 tok/s,首 token 0.31 到 0.45 秒;768 token 長輸出 129.9 tok/s,同 prompt 重跑 146.9;VRAM 吃到 31,693 MiB,只剩 416 MiB |
| 9/28 | 同上,旁邊掛著 Bonsai | 同一題長輸出 97.4 tok/s |
| 9/30 | 跟 CosyVoice 共用 GPU | Strata 讓出 4GB VRAM,expert 快取格數從 13,602 掉到 9,084,生成 61.5 tok/s |
| 9/30 晚 | 0.1.29、IQ3_XXS、262K、int8 KV | 384 token 生成 94.4 tok/s(前一版同條件 80.6);GPU expert 快取命中率 93.4%;快取 11,340 格 |
| 10/1 凌晨 | 0.1.30、IQ3_XXS、1M、q4_0 KV | 512 token 生成 101.9 tok/s;官方 serve 測試 51/51;30 萬 token 撈針 76 秒全對;99.9 萬 token 344 秒全對,RAM 剩 5.8 GiB |
| 10/1 凌晨 | 同上,真實請求 | 實際 context 約 185K 到 188K;prefill 3,278 到 3,642 tok/s;長輸出生成 87.2 到 89.6 tok/s |
| 10/1 清晨起 | 0.1.30、IQ3_S、262K、int8 KV | 32.81 GiB 專家常駐 RAM,快取 9,494 格;41 筆真實請求生成中位數 106.8 tok/s;prefill 3,160 到 4,250 tok/s;專家快取命中率 67.8% 到 96.5% |
常見問題 Q&A
Q: Strata 是什麼?跟 llama.cpp 有什麼不同?
Strata 是 GitHub 使用者 Niko1221 在 2026 年 9 月 24 日開源的推論引擎(MIT 授權),專門讓 Qwen3.8-Flash-Next 這個 125B 的混合專家模型(Mixture of Experts, MoE)跑在一張 12-24GB 的 NVIDIA 遊戲卡加 64GB RAM 上。它用了部分 llama.cpp / ggml 的元件,但做法不同:llama.cpp 的 MoE 卸載(MoE Offload)是把 expert 放 CPU RAM、用到時搬到 GPU 算;Strata 把最常用的 expert 快取在 VRAM,沒命中的直接由 CPU 在 RAM 裡算,並把 29GB 的 n-gram 查表留在 SSD。在 RTX 5090 上實測 GPU expert 快取命中率 93.4%。
Q: IQ3_XXS 和 IQ3_S 差在哪?該選哪個?
兩者都是 llama.cpp 家族的 3-bit 量化(Quantization):IQ3_XXS 約 3.06 bit/權重,IQ3_S 約 3.44 bit/權重。跑 Qwen3.8-Flash-Next 時,IQ3_XXS 的 RAM+VRAM 需求是 47.0GB,IQ3_S 是 54.8GB。在 RTX 5090 + 64GB RAM 上,IQ3_XXS 可以把 context 開到 1M,IQ3_S 多吃 7.8GB 只能用到 262K。第三方用 291 題 MMLU-Pro 測,Strata 的 IQ3_S 得 65.3%,比 Unsloth 的 UD-Q6_K_XL(68.7%)低約 3 分;IQ3_XXS 壓得更多。日常跑 agent,作者實際使用時 IQ3_S 出錯較少,但那是使用觀察,不是對照實驗。
Q: RTX 5090 跑 Qwen3.8-Flash-Next 實際有多快?
在 Core Ultra 7 265K、64GB DDR5-4800、RTX 5090 32GB 的機器上用 Strata 0.1.30:IQ3_XXS 生成 512 token 為 101.9 tok/s;IQ3_S(262K context、int8 KV)41 筆真實 agent 請求的生成速度中位數 106.8 tok/s,讀 prompt(Prefill)大約每秒 3,000 到 4,000 token。這些是約 64K token 的真實請求,不是塞滿 262K 的測速。如果同一張卡還跑著其他 GPU 服務,Strata 可快取的 expert 變少,速度會掉,例如跟 CosyVoice 共用時掉到 61.5 tok/s。
Q: Qwen3.8-Flash-Next 在 5090 上真的能開到 1M context 嗎?
能跑,但屬於實驗性質。模型原生訓練長度是 262,144 token,要到 1M 必須用 YaRN 旋轉位置編碼延伸(Rope Scaling)4 倍,並把 KV cache 從 int8 降到 4-bit(q4_0)。實測做法是大海撈針測試(Needle-in-a-Haystack):把一份 999,490 token 的文件丟進去,在 10%、50%、90% 的位置各藏一組驗證碼,三組全部答對,但讀完花了 344 秒,RAM 只剩 5.8 GiB。這種測試只證明找得到,不代表長文件理解品質不變;而且只有 IQ3_XXS 放得下,IQ3_S 就塞不進 64GB RAM。
Q: 為什麼 FreeToken 跑不動,Strata 卻可以?
FreeToken 是 2026 年 8 月 UC Berkeley 領頭發表的 MoE 推論系統,做法是把全部 expert 放在主機記憶體(Host RAM),論文裡的 RTX 5090 測試機配了 192GB DDR5。它支援 Qwen3.8-Flash-Next 的 FP8 或 NVFP4 版本,NVFP4 checkpoint 還有 135GB,而且那張 n-gram 查表要 47.7 GiB 固定在 RAM。RTX 5090 的 32GB VRAM 加 64GB RAM 總共 96GB,放不下。Strata 改用約 3-bit 的 IQ3 量化,並把 29GB 的 n-gram 查表留在 SSD 按需讀取,所以 64GB RAM 就跑得起來。
延伸閱讀
- MoE Offload 完全拆解:為什麼 671B 模型只吃 17GB VRAM 還能跑
- 5090 三個月從 10 萬變 17 萬:五條技術路徑壓低地端 AI 的硬體門檻
- YouTube 逐字稿:千問3.8-27B 用了兩天說說感覺——RTX 5090 SGLang/vLLM/llama.cpp 實測
- Qwen3.8-27B 開源:SWE-bench Pro 61.7 贏過 Opus 4.6 Max
- 單機跑得動 Tier 1 地端 Model 嗎?RTX Pro 6000 一週實驗 Day 1-2
來源
- Strata(GitHub, Niko1221)
- Qwen/Qwen3.8-Flash-Next model card(Hugging Face)
- FreeToken: Efficient Edge-Native MoE Serving with Bandwidth-Adaptive Execution(arXiv 2608.16157)
- FreeToken supported models
- RadixArk/Qwen3.8-Flash-Next-NVFP4
- Artificial Analysis:Qwen3.8-Flash-Next、Qwen3.8 27B、Qwen3.6 27B
- Nigel Hungerford-Symes(@VectorCrossProd):Strata IQ3_S 的 291 題 MMLU-Pro 測試
- llama-quantize 量化類型說明(IQ3_XXS / IQ3_S bpw)