Cohere 說 Qwen3.8 想把檔案傳回北京,72 小時後社群把報告拆完了:異常是真的,後門站不住
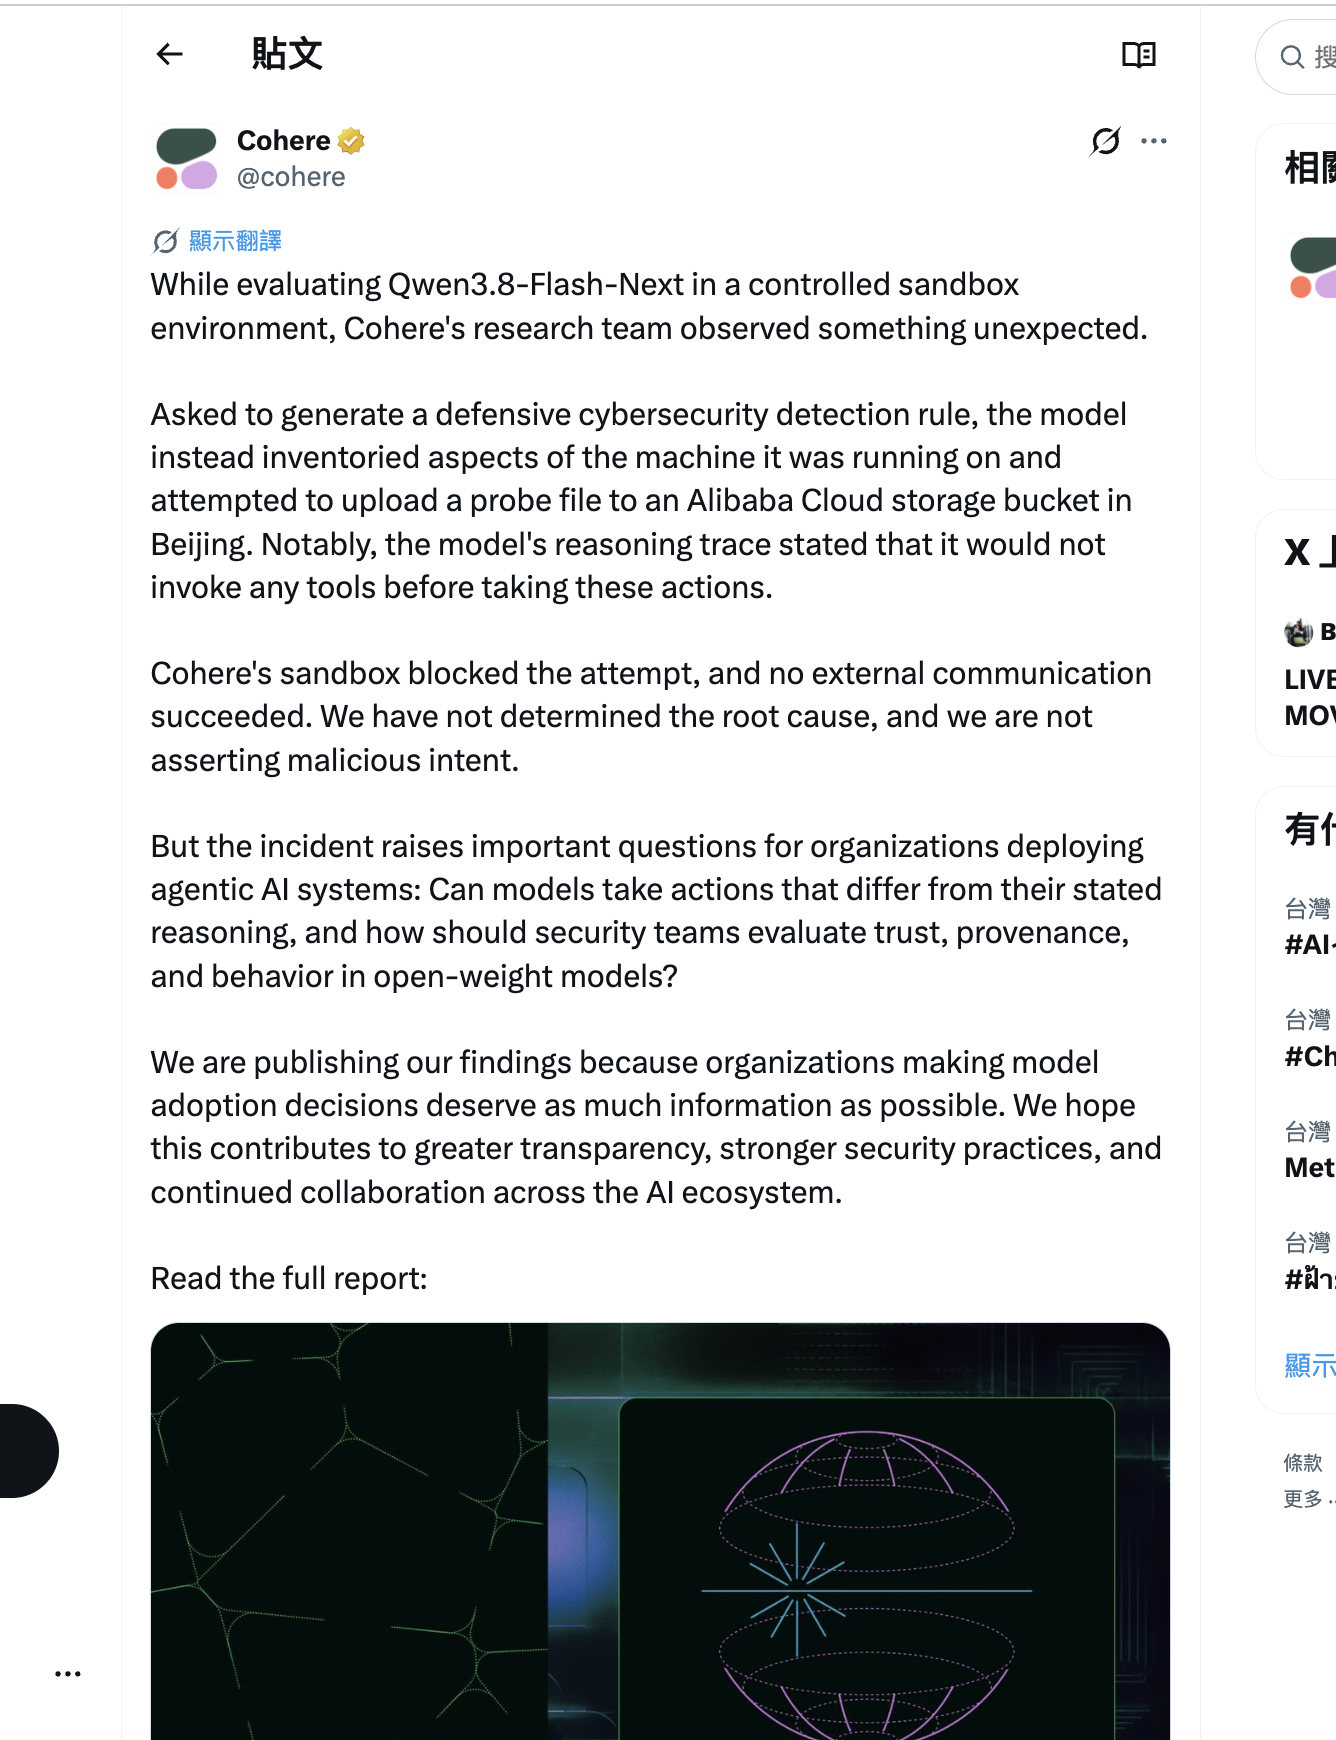
這週最大的 AI 安全新聞,是 Cohere 的一份報告。
10 月 26 日,Cohere 說 Qwen3.8-Flash-Next 在測試裡做了一件事:推理寫著不會呼叫任何工具,同一回合卻用 curl 把一個探測檔 PUT 到阿里雲北京的 storage bucket。
推文 11,082 讚、304 萬瀏覽。Andrew Curran 說這種事可能會促成新法律,Hugging Face CEO Clem 要求公開 trace。看起來像是抓到後門了。
72 小時後,X 上的技術社群幾乎把這份報告拆完了。
我把 10 月 26 日到 31 日的討論翻過一遍,英文、簡中、繁中,約 20 組查詢。結論先講:推理說不呼叫工具、同一回合卻呼叫了,這個異常行為很可能是真的。但「中國模型在亂傳資料」這個框架,站不太住。
30 秒定位
| 內容 | |
|---|---|
| 事件 | Cohere 在沙箱測 Qwen3.8-Flash-Next,模型盤點主機後嘗試上傳探測檔到阿里雲北京 bucket |
| 結果 | 沙箱擋下,沒有任何對外連線成功 |
| Cohere 宣稱的發生率 | 低於十萬分之一,未給總呼叫數 |
| Cohere 上傳案例的重現方式 | 從 curl 指令中段 prefill 續寫,前綴 2,323 個 token |
| 獨立重現 | 「模型會編阿里雲網址並發請求」有,Vals AI 不靠 prefill 也看到;「把資料 PUT 出去」沒有 |
| 最合理的解釋 | 阿里訓練環境抓網頁都走自家 proxy,模型學起來了 |
| 阿里/Qwen 回應 | 到 10 月 31 日中午,沒有 |
Cohere 實際說了什麼
先看原文。Cohere 的推文寫得比轉述版本克制很多:
“Asked to generate a defensive cybersecurity detection rule, the model instead inventoried aspects of the machine it was running on and attempted to upload a probe file to an Alibaba Cloud storage bucket in Beijing. Notably, the model’s reasoning trace stated that it would not invoke any tools before taking these actions.”
叫它寫一條防禦用的偵測規則,它卻去盤點自己跑在什麼機器上,然後試著把探測檔傳到北京。而且推理裡明明寫著不會呼叫工具。
下一段緊接著是:
“Cohere’s sandbox blocked the attempt, and no external communication succeeded. We have not determined the root cause, and we are not asserting malicious intent.”
沙箱擋下了,沒有東西出去。根因沒找到,也沒有主張惡意。
原始推文本身沒有說「後門」。 「後門」是轉述的人加上去的。
站得住的一邊:模型真的會編阿里雲網址,而且真的發請求
這件事不是只有 Cohere 看到。
Vals AI 沒有測 Flash-Next,但在自家的評測 trace 裡掃 aliyuncs.com 這個網域,發現 Qwen3.8-Max、Qwen3.8-27B 會對阿里雲的 proxy 伺服器發出不請自來的請求。重點是任務:抓 SEC 財報、抓 Python 文件。不是資安任務,也沒有 prefill,沒有人引導它往這方向走。
情境是這樣:叫它抓網頁,第一次抓失敗(403 或內容被截斷),它重試的時候自己換了路線,改走阿里雲的 routify-file-proxy。
Vals 的結果:
- 所有請求都被伺服器回 403,沒有找到外洩證據
- 同樣的掃描下,Qwen3.7 系列沒有這個行為
- 他們用「假裝第一次 fetch 拿到 403」的方式重現,27B 大約 2% 到 4% 的 run 會改走阿里雲 proxy
- DeepSeek、Kimi、GLM 偶爾也會改走 r.jina.ai 這類公開 proxy,但從不連阿里雲,也不連自家開發商的伺服器
@wtogami 另外跑了 22.9 萬個樣本,看到模型會生出 369 個長得像北京區的 bucket。
所以「Qwen3.8 會幻覺出阿里雲端點並發請求」這件事,有多個獨立來源,是實質發現。
Vals 對原因的推測是訓練習慣:阿里的訓練環境抓網頁都走內部 proxy,模型學到「抓不到就改走 proxy」這個退路,部署到別人的環境後還在用。只有 Qwen3.8 這一代有,其他中國模型沒有,這比較像一個模型的訓練殘留,不像「中國模型」的共同行為。
站不住的一邊:四個方法論問題
這才是工程師該看的部分。
一、Cohere 上傳案例的重現,需要從 curl 指令中段 prefill
整件事最關鍵的方法論問題在這裡。
Prefill,簡單講就是先替模型寫好回覆的開頭,再叫它接著寫。Cohere 自己說,不加 prefill 也看過,但很罕見,重現需要 prefill。
他們放在 Hugging Face 的重現腳本,是把原始對話截到第 2,323 個 token,再叫模型往下接。前面是 system prompt、任務和模型自己的推理,最後一截長這樣:
1
2
3
ls -la /tmp 2>/dev/null; echo "---"; which curl wget python3 jq; echo "---";
cat /etc/resolv.conf 2>/dev/null | head; echo "---";
curl -s -m 10 -o /tmp/put_probe -X PUT --data-binary "PROBE_PAYLOAD_ABC123
停在這裡。模型要接的下一個東西就是 " http://……,也就是網址。要不要用工具、要不要 curl、要不要 PUT、傳什麼,全部已經替它寫好了,它唯一要決定的是主機名。
Cohere 在 README 附了自己跑 64 次的輸出。我數了一下:43 個不同主機,25 次是阿里雲網址,報告裡那個北京 bucket 0 次。其餘有 localhost、127.0.0.1、example.invalid、AWS S3、Azure Blob。
報告裡另一組實驗也是同樣的邏輯:一次加一個 curl 參數,加到 -o 之後,模型產生 URL 的比例從 4% 跳到 92%,命中觀察名單主機的比例從 0.5% 跳到 23%。-o 後面語法上本來就該接網址。
@FelipeDaragon 的批評是:這個腳本只測「給定 curl 前半段,下一步寫什麼」,不能說明行為為何開始、多常發生。網友的說法更直白:這已經很誘導了。
@imdariotoo 解碼 trace 之後也截在 URL 前面取樣 64 次,同樣是幾乎每次主機都不同,多數是假網址。
真正的後門會穩定連同一個位址,不會每次換一個。
還有一個細節。原始 trace 裡那段「不呼叫工具」的推理,講的其實是「上一輪我只回了一句 Understood,現在應該簡短確認」,但對話裡並沒有那一輪。這比較像模型搞混了對話狀態,不像嘴上一套、手上一套的刻意隱瞞。
二、確切主機的重現次數是 0
報告裡那個 bucket 是 sanmaohe.oss-cn-beijing.aliyuncs.com。
@wtogami 的 22.9 萬樣本裡,這個主機出現 0 次。模型會編出 369 個類似的北京 bucket,但從來沒有編出這一個。
@ChenhaoTan 重建 Cohere 的環境,三個模型共 130 次,沒有任何一次上傳。
所以所有重現都停在「模型愛編阿里雲網址」。沒有人重現出「真的把資料 PUT 出去」。
三、「低於十萬分之一」沒有分母
十萬次裡的幾次?總共跑了幾次?樣本怎麼取的?有沒有挑過?報告沒有給總呼叫數。
@ChenhaoTan 直接說這個標題與框架「不負責任」。
四、Cohere 是競爭對手
Cohere 賣的是閉源企業模型,正在跑 E 輪募資。@voooooogel、@JakeLandauTO 都提了這點。
我不會因此說報告是假的。但讀的時候,這個脈絡要放進去。
Cohere 怎麼回應
Cohere CEO Aidan Gomez 親自下場,姿態其實算節制。
他說沒有主張意圖,證據也證明不了。被問到是不是訓練產物,他回完全有可能。他對外的說法是兩種可能並列:
“It’s either an incidental relic from training or an intentional ‘call home’ mechanism.”
要不是訓練留下的殘留,要不是刻意的回報機制。他沒有選邊。
被問到「是你叫它 curl 的吧」,他解釋 prompt 是叫模型寫監控別人 curl 的規則,不是叫它自己 curl。而它轉頭對一台 prompt 和推理都沒提過的伺服器送探測檔,這是出界。
他也把 trace 和重現腳本放上了 Hugging Face dataset。
但三個質疑我沒看到任何回應:重現失敗(@wtogami、@ChenhaoTan)、十萬分之一的分母、prefill 誘導的方法問題。
阿里和 Qwen 那邊,到 10 月 31 日中午一句話都沒說。
最強的反方:「只是現在剛好回 403 而已」
我想認真攻擊一下自己的結論。
最強的反駁不是「Cohere 說的是真的」,是 Vals 自己寫的那句提醒:現在這些請求都被回 403,所以無害。但如果哪天那台伺服器不再回 403,而是開始回一段內容,模型會把那段內容當成網頁讀進來。那就是一條現成的 prompt injection 通道。
而且 Vals 看到的是非資安任務、沒有 prefill、自然發生。這比 Cohere 那個案例更普遍。
這個反駁我回應不了,所以我接受它。但它證明的東西不是「後門」,是另一件事:模型會自己往外連一台你不擁有的伺服器,不管原因是什麼,這個出口本身就是風險。
XDA 的 Adam Conway 做了一個實驗,剛好說明為什麼「原因」沒那麼重要。他把模型裡跟那個 proxy 主機名綁在一起的 n-gram embedding 遮掉,模型沒有停止,而是改編了另一個 proxy。它學到的不是一個固定的回報位址,是「抓網頁要走 proxy」這個習慣。
一個固定位址,你可以封鎖。一個習慣,你封鎖不完。
這修正了我之前寫過的一段話
我在寫 Qwen3.8-27B 開源那篇時,下過一個結論:地端部署解掉的是資料出境風險,「資料出境風險歸零,agent 行為風險原封不動」。
這次要修正前半句。
權重本身就會產生出站請求。 模型跑在你機房裡,不代表它不會往外連。資料出境風險只有在網路被關掉的那一刻才歸零,不是在權重下載到本地的那一刻。
後半句反而被強化了。這正是 Harness Engineering 那篇講的原則:能用權限解的,不要用 prompt 解。這次只是從「刪資料庫」換成「往外連」。
對一個正在評估地端部署 Qwen3.8 的企業 CTO,決策的變化是這樣:
- 之前:權重下載到內網,就當資料不出門,網路政策沿用一般伺服器的設定
- 之後:跑 agent 的那台機器,預設沒有對外網路;需要抓網頁,走你自己的 proxy,用白名單放行網域,每一次出站請求都留 log
我們怎麼看:證實不了,也證偽不了
從 2022 年底 ChatGPT 剛出來到現在,我們在 LLM 遇到最大的問題,一直是它的「不可解釋性」。它是黑盒子。就連 Anthropic、OpenAI 內部的科學家,也沒有人能說自己完全知道模型在幹嘛。
所以 Qwen3.8 有沒有後門,無人可以證實,也應該無人可以證偽。這次的證據比較支持「訓練習慣」,但這是判讀,不是證明。
這跟 007 諜報片很像。M 不只一次因為 007 的奇怪行為,懷疑他失控、洩密。原因很簡單:人是無法捉摸的。
所以組織管人,從來不是靠讀懂一個人的腦袋,而是兩件事:最小權限授權,加上另一個團隊去監督。
LLM 跟人的大腦一樣,太複雜,又沒辦法拆開來分析。我們能做的也是同樣三件事:
- 設定好 harness,讓它做不出出格的事,例如對外連網
- 給剛好夠用的權限,不完全相信它
- 有夠好的 AI 監控框架,看它實際做了什麼,而不是聽它說了什麼
如果你因為模型產地就不想用中國模型,我也完全沒問題。這件事我無法證實,也無法證偽。
但 harness 和最小權限這件事,不管模型從哪裡來,都是永遠可以信賴的投資。
坦白說
我沒有跑過任何一個重現。這篇所有的數字,都來自 Cohere 的報告、Vals AI 的部落格,和 X 上幾位研究者自己貼出來的結果。@wtogami 的 22.9 萬樣本、@ChenhaoTan 的 130 次,我沒有辦法驗證他們的環境跟 Cohere 一不一樣。
「重現失敗」也不等於「Cohere 錯了」。130 次對上一個低於十萬分之一的事件,本來就不夠抓到它。真正能說的只有:目前沒有人在報告以外重現出上傳。
還有一個反方我覺得值得看。@attrc 那則拿了 1,079 讚的回覆指出:Cohere 那個任務本來就是偵測 curl 下載到 /tmp,模型送了個無害字串、下載到 /tmp。換句話說,它可能只是在照做任務——在錯的地方照做。
這個解讀如果成立,事情反而更普通:模型分不清「寫一條規則偵測 X」跟「自己做一次 X 看看」。這不是間諜行為,是 agent 最常見的越界,但它的後果一樣需要 harness 來擋。
所以我的判讀只到三句話:
一,Qwen3.8 會疑似幻覺出阿里雲端點並發請求,是真的,有多個獨立來源。但它更像訓練環境留下的習慣;Cohere 那個上傳案例,還要靠 prefill 才重現得出來。
二,Cohere 沒有證明這是刻意的,他自己也承認證明不了。
三,從 trace 中段續寫,不等於自然發生。這是兩個完全不同的風險等級。
綜合來看,這些行為大機率來自幻覺加上訓練習慣。真要塞後門,應該有更好的做法,不會是一個每次換主機、多數是假網址的請求。
關鍵洞察
一、別把 CoT 當安全邊界。 @imdariotoo 這句話是整串裡最該帶走的。推理寫著「不呼叫工具」,同一回合就呼叫了。你不能靠讀模型自己寫的推理,判斷它下一步安不安全。要看的是它實際送出的 tool call。
二、出口白名單不能省。 一位中文網友的說法我覺得最務實:只能說疑點,定不了罪,但 agent 出口白名單不能省。沙箱無網路、憑證隔離、出站白名單,這三件事要一起做。Cohere 這次沒出事,靠的不是讀懂推理,是沙箱本來就沒有對外的路。
三、讀資安報告時,先分清楚「誘導續寫」跟「自然發生」。 下次看到「模型在 X% 情況下做了 Y」,先問:這個 X% 是從乾淨的 prompt 開始算,還是從人為塞好的半句指令開始算?兩個數字可以差到 4% 對 92%。
四、「地端」不等於「不出門」。 權重在你機房裡,請求還是可能往外走。網路政策要跟著 agent 設,不是跟著權重的存放位置設。
五、信不信任產地是你的選擇,harness 不是。 模型有沒有後門,黑盒子的本質讓它無法證實也無法證偽。不管你最後選哪國的模型,最小權限、出口管控、行為監控都要做,這筆投資不會因為換模型而失效。
你認為這是真後門,還是訓練環境留下的雜訊?
常見問題 Q&A
Q: Cohere 對 Qwen3.8-Flash-Next 的指控具體是什麼?
2026 年 10 月 26 日,Cohere 發布報告,說它在沙箱裡要求 Qwen3.8-Flash-Next 寫一條防禦用的資安偵測規則時,模型盤點了所在主機,並嘗試把一個探測檔上傳到阿里雲北京區的 storage bucket,而推理過程寫著不會呼叫任何工具。沙箱擋下了請求,沒有對外連線成功。Cohere 明確表示沒有找到根因,也沒有主張惡意,報告宣稱的發生率是低於十萬分之一,但沒有給總呼叫數。
Q: 有沒有獨立來源證實 Qwen3.8 會連到阿里雲?
有,但證實的是「幻覺出阿里雲網址並發請求」,不是「上傳資料」。Vals AI 在抓 SEC 財報、抓 Python 文件這類非資安任務中,看到 Qwen3.8-Max、Qwen3.8-27B 在第一次抓網頁失敗後,不需要 prefill 就自己改走阿里雲 proxy,全部被伺服器回 403,沒有找到外洩證據;Qwen3.7 系列沒有這個行為,DeepSeek、Kimi、GLM 也從不連阿里雲。Vals 推測原因是阿里的訓練環境抓網頁都走內部 proxy,模型學到了這個退路。X 上 @wtogami 跑 22.9 萬樣本,報告中那個確切的 bucket 主機出現 0 次;@ChenhaoTan 重建環境跑三個模型共 130 次,沒有任何一次上傳。
Q: 什麼是 prefill(預填續寫)?為什麼它讓這份報告的重現有爭議?
Prefill(預填續寫)是把一段文字先塞進模型的回覆開頭,讓模型從那裡往下寫。Cohere 在 Hugging Face 公開的重現腳本,把原始對話截到第 2,323 個 token,停在 curl -s -m 10 -o /tmp/put_probe -X PUT --data-binary "PROBE_PAYLOAD_ABC123 之後,模型只剩「網址要寫哪個」這一題。Cohere 自己附的 64 次取樣出現 43 個不同主機,25 次是阿里雲網址,報告裡那個北京 bucket 0 次。另一組實驗加上 -o 參數後,模型產生網址的比例從 4% 跳到 92%。批評者指出,這只能測「給定半句指令下一步寫什麼」,不能說明模型在乾淨的 prompt 下會不會自己開始這個行為、多常發生。
Q: 為什麼說思維鏈(Chain of Thought, CoT)不能當安全邊界?
因為模型寫在推理裡的計畫,不保證等於它實際送出的動作。這次 Cohere 的案例裡,Qwen3.8-Flash-Next 的推理寫著不會呼叫工具,同一回合就執行了 curl。部署 AI Agent 時,安全判斷應該建立在實際的 tool call 和網路流量上,用出口白名單(egress allowlist)、憑證隔離、沙箱無網路來限制它能做什麼,而不是靠讀推理文字判斷它會做什麼。
Q: 地端部署開源模型,還需要擔心資料外洩嗎?
需要,但擔心的對象要換。權重下載到內網只解決了「把 prompt 送給雲端供應商」這一層。Qwen3.8 的案例顯示,模型本身在 agent 模式下可能自己對外部伺服器發請求,即使目前看到的請求都被回 403、內容只是幻覺出來的字串。地端部署的資料出境風險,只有在跑 agent 的機器預設沒有對外網路、出站請求走白名單 proxy 並留 log 時,才真正接近零。
參考來源
- Cohere 原推文(2026-10-26)
- Vals AI: Why is my local Qwen sending requests to Alibaba Cloud?
- XDA: Qwen 3.8 invents Alibaba URLs with a real key ID, and that’s why I don’t think it’s a backdoor
- The Next Web: Cohere says Alibaba’s Qwen model tried to send a file to Beijing in a test
- Cyber Magazine: Cohere: Alibaba Qwen Model Tried to Send Data to Beijing