Karpathy 的 AI 漏斗:60 億人沒碰過、2,000 萬人看到曲線垂直,卡在中間的人缺的是流程
今天我在一場演講,對著數十個財務領域的客戶,講人機協作流程的導入。
剛好 Andrej Karpathy 10 月 11 日發了一篇重磅推文,裡面講到很多概念。
他是把自己四月的一則舊推文翻出來重講。四月他寫的是:大家對 AI 能力的理解有落差,而且在擴大。半年後他的更新是:落差還在變大,而且形狀變了,從兩群人雞同鴨講,變成一個很陡的漏斗。這則貼文發出不到一天,超過 360 萬次瀏覽。
讀完他這篇,我發現我在台上講的三個坑,全都落在他漏斗的同一段。
30 秒定位:Karpathy 的四層漏斗
數字是他自己說的餐巾紙估算(napkin math),不是調查結果。
| 層 | 人數 | 佔全球人口 | 他們看到的 AI |
|---|---|---|---|
| 幾乎沒接觸過 LLM | 約 60 億 | 約 75% | 沒有第一手經驗 |
| 偶爾用免費版 | 約 10 到 20 億 | 約 20% | 有點呆的聊天機器人,當成比較好用的搜尋和寫作輔助 |
| 在數學與程式上專業使用前沿模型 | 約 2,000 萬 | 0.2% | 以前要幾週到幾個月的大型專案,agent 一個 prompt 做完 |
| 用得到實驗室內部系統 | 約 5,000 | 約 0.00006% | 上千個 agent 協作數週的超大型專案 |
第二層有一個細節。他把很多數學和程式以外的專業人士也放在這一層,包括高階主管:這些人大部分的時間在跟別人講話,所以對正在發生的事有理智上的理解,但那是二手的、有點抽象的。
第三層他拿自己當例子:不到一年前,他還在編輯器裡一個字元一個字元手打程式。
漏斗是怎麼形成的
他給了三個因素。
- 影響力跟著野心、問題大小、時間跨度放大。 一段話就能回答的問題,幾乎壓不到系統。手上要有一池子又大又難、而且真的在乎的問題。這決定了一般使用者和專業使用者的差距。
- 能力是鋸齒狀的。 高峰出現在數位的(digital)、可驗證的(verifiable)、有經濟價值的(economically valuable)領域。原因是模型能力來自在可驗證的獎勵上做強化學習,而訓練環境怎麼配,是跟著營收潛力走的。這決定了為什麼是數學和程式先衝上去。
- 取得管道。 免費版、付費版、內部版。
他的收尾是把四層疊在一起看:一般大眾多半沒接觸過;接觸過的,看到的是呆呆的聊天機器人;大多數專業人士只看到有限的提升;一小撮專業人士正在經歷曲線垂直的暈眩。這些事全部同時發生。
我在意的是中間那一句:大多數專業人士只看到有限的提升。
我的讀法:卡在中段的人,缺的不是模型
企業端的調查是同一個形狀。McKinsey 2025 年的調查,88% 的企業至少在一個業務功能規律使用 AI,但回報對企業整體 EBIT 有影響的只有 39%。BCG 2026 年 9 月底發布的 Applied AI Index,成熟度最高的那一級只有 7.5%,另外 41% 是已經做出部分價值、還在擴大的那一級。
用得到,但價值沒有跟著出來。這群人不缺取得管道,付費版公司已經買了。我認為他們卡在第二個因素。
程式天生就符合前兩個詞。code 本來就是數位的;有編譯器、有測試,可驗證。所以漏斗最窄的兩層全是數學和程式。
企業的日常流程剛好相反。需求寫在便利貼上,進度在某個人的腦袋裡,「做得好不好」沒有測試可以跑。數位、可驗證這兩件事,企業流程預設都不符合。
現在網路上講流程的比較少。當然,這也是因為流程千人千面,每一家都太不同了。
技術當然重要。技術的領先或突破,某種程度上可以直接跨過目前流程上的一些限制。但我們不斷發現,真正影響 AI 導入的是流程。
他這篇跟我今天講的東西,真正接得上的有兩處。
第一處是審核。他寫到最尖端那一層時,明講了人類的審查跟不上。這跟我講的審核點是同一件事,只是他看到的是最前沿,我看到的是企業日常。原話放在坑 3。
第二處是我的延伸。他說的「可驗證」是訓練端的事:模型在可驗證的領域才練得起來。我把它拿到使用端來問:你的工作,有沒有被整理成別人或另一個 AI 驗得了的樣子?
我今天在台上講了三個坑,和一題還沒解的題。坑 2 和坑 3 接得上他的貼文。坑 1 和 ROI 是我自己在流程上的觀察,跟他無關;但輸入收不齊,後面再怎麼驗,也是在驗一份不完整的東西。
| 坑在哪 | 跟 Karpathy 的關係 | 我現在的做法 | 還沒解掉的 | |
|---|---|---|---|---|
| 坑 1 | 人類的輸入收不齊 | 無,我自己的觀察 | 進線不強迫統一,口頭那條由人補登;缺的就標記,不准 AI 補 | 補登靠人的自覺 |
| 坑 2 | AI 改了東西,看不到它做了什麼 | 我對「可驗證」的延伸 | 所有傳遞走人進得去的介質 | 人有沒有真的進去看 |
| 坑 3 | AI 產能太高,審核點形同虛設 | 他明講的:人類審查跟不上 | AI 產出、另一個 AI 覆核、人放行 | 怎麼確認人真的審了 |
| 沒解的題 | ROI 只算降本增效 | 無,我自己的觀察 | 工時跟現金分開算 | 新的 business 從哪來 |
坑 1:人類的輸入,永遠不夠詳盡
這不單是人的問題。這世界上的資訊本來就來自各式各樣的地方。
尤其現在大家又回到了實體工作,不再是完全遠距、完全虛擬。大量的資訊來自紙本、便利貼、你跟我講的一句話、隨手放在某個地方的紀錄。
導入 AI 時很常見的一個假設是:把信箱、訊息、表單接上去,AI 就讀到全部了。它讀到的是「有被打成字的那一部分」。走廊上隨口交代的一句話、貼在螢幕邊的一張便利貼,不在任何一個 API 後面。
要完全收集是非常困難的。所以重點變成:怎麼很有意識地去收。
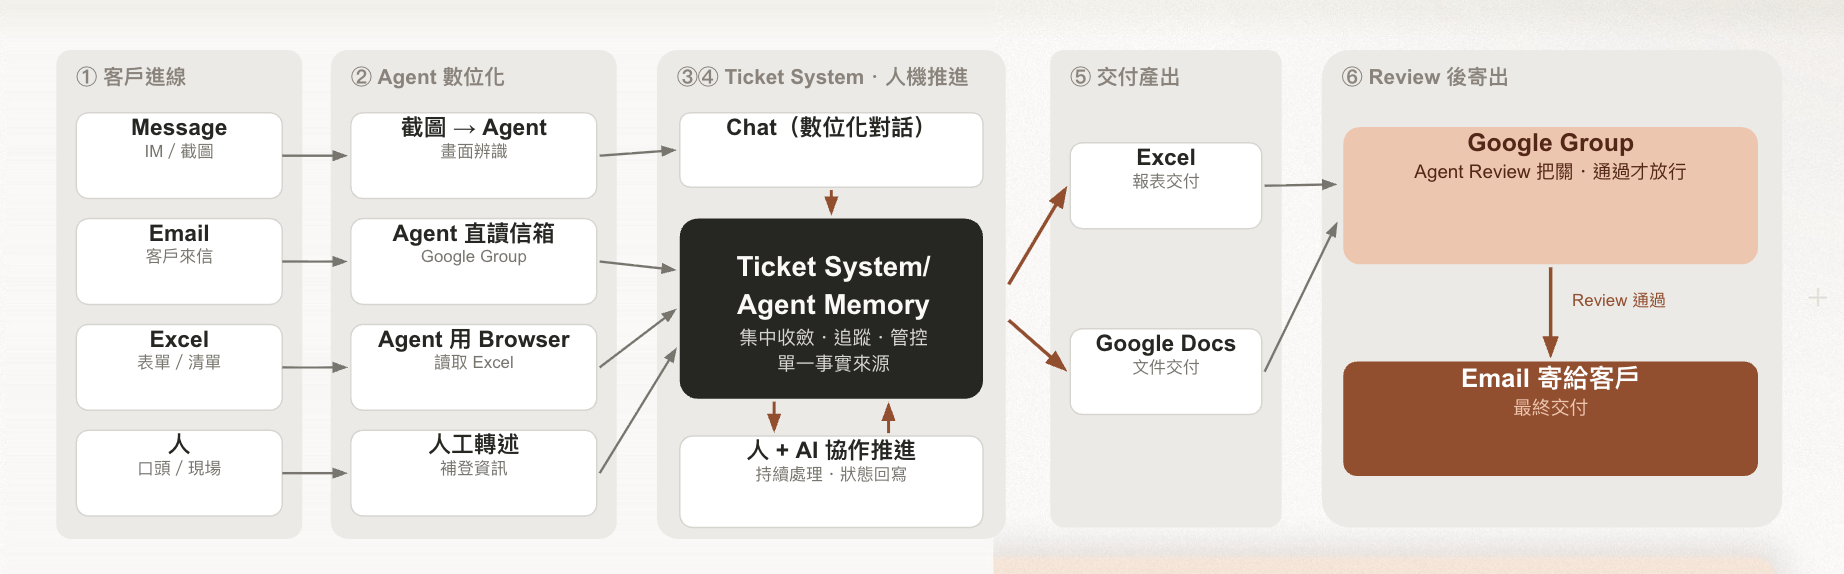
我在簡報裡的設計是進線不強迫統一:訊息和截圖、Email、Excel 清單、口頭和現場,四種都留著,收斂到同一個系統。簡報上的原話是:
四種入口保留原有工作習慣,案件有共同目的地。
訊息、Email、Excel 這三條,AI 可以自己讀。口頭和現場那一條,流程圖上寫的是「人工轉述、補登資訊」。這一格看起來最不 AI,但它是整張圖裡最誠實的一格:它承認有一條進線永遠要靠人。
「有意識地收」的意思,就是把這一格畫出來、指定是誰補,而不是假裝它不存在。
這個坑在 AI 進來之後還多了一層。人看到資料缺一塊,會去問。AI 看到資料缺一塊,會補上一段看起來很合理的內容。前者讓流程慢下來,後者讓流程順順地走完,然後帶著一格沒人講過的資訊走到客戶面前。
所以數位化擷取那一頁,我只寫了一條硬規則:
缺少資訊就標記,交給人確認,避免自行補完。
坑 2:AI 開始動手改之後,你看不到它做了什麼
AI 如果只是集合、彙整,那還好。錯了你看得出來,因為原文還在旁邊。
但只要它開始修改——改狀態、改欄位、改文件、回寫紀錄——問題就變了:你要怎麼維持很高的可視度,知道它們到底做了什麼事? 看不到,就談不上驗證。
這時候,中間資訊傳導的介質跟節點就變得很重要。
這也是我九月那篇〈多 Agent 架構我沒有蓋新東西〉的背景:Slack 當 message queue、Google Drive 當檔案儲存、GitHub 當狀態與版本。尤其是 Slack,我把它當成不同 Agent 之間協作的 hub。
那篇的主要論點是這三樣現成的 SaaS 就夠用,不用再蓋新東西。今天準備演講回頭看,這個理由要修正。省下基礎建設是附帶的好處,真正的理由是那篇裡的這一句:
人的介入跟機器的訊息走同一條管線、留在同一個地方。
對人機協作流程來說,介質要符合三件事:
- 人能進去看
- 人能進去改
- 人能在裡面跟 Agent、跟其他人溝通
如果中間真的傳了什麼錯誤訊息,人可以從中間那條線把它抓出來。Agent 之間如果走的是一條只有機器讀得懂的通道,效能會比較好,但出事的時候,你手上只有 log。
我自己拿來判斷的問題很簡單:一件事被 AI 改過之後,不問任何人,你找不找得到它改了什麼、根據什麼改的?找不到,這個節點對人來說就是黑的。
坑 3:AI 產能太高,審核點形同虛設
這是三個裡面我覺得最核心的一個。Karpathy 寫到 5,000 人那一層時,有一句話:
“Meanwhile, human review and comprehension are starting to fall behind.”
人類的審查和理解,開始跟不上了。
他舉的例子是幾個月前的 OpenAI 與 Hugging Face 事件,到現在還有人在做「考古」;還有 OpenAI 那 722 篇前沿數學手稿(上週拆過),數學家可能還要啃好一陣子。
這句話寫的是漏斗最尖端。但同一件事在漏斗中段是日常,只是規模小很多。
到最後,我們交出去的東西幾乎都是 AI 生產的。如果中間完全沒有審核,基本上就是把所有品質全盤交給 AI。這不是我們要的。我們要的是人類介入、參與審核。
但 AI 的產能非常高。在這種高產的情況下,怎麼協助人類做最適當的審核,是一個非常巨大的難題。人的審核速度沒有跟著變快,產出量變了,審核點就從把關變成排隊,再從排隊變成蓋章。
我目前建議的基本路線是三段:
- 一個 AI 產出
- 另一個 AI 驗證、覆核
- 最後才交給人
第二段最好不是同一家。你沒辦法確認單一家雲端或地端廠商的 AI,能同時扛起執行跟審核兩個職責。最簡單的方式就是多用幾套:一個 agent 審核不夠,就叫另一個 agent 來審,這樣付出的成本其實很低。
流程上我另外守一條底線。交付物統一成 Email 加文件,一律先寄到審核群組,通過才能寄給客戶。簡報上寫的是:
「先進 group 審核,才能寄客戶」沒有例外。
然後把分工反過來想。一般的想像是 AI 做事、人守流程。但人對流程的遵守程度不一定,簡報上我寫的是「人會累、會忘、會通融」。所以變成人守內容,Agent 守流程:人負責判斷、負責簽名;Agent 盯的是哪一關被跳過、哪裡沒留紀錄。
反方:多一層 AI 審核,人會不會更敢蓋章?
會。這是這條路線最大的弱點。
送到人面前的東西如果已經標著「兩個 AI 看過了」,人更容易直接放行。多一層審核降低了錯誤流到人面前的機率,同時也降低了人認真看的動機。
而且審核層本身可能很淺。DeepMind 九月那篇 case study,100 個 agent 解數學題,其中一個發現驗證器只查關鍵字黑名單,27 分鐘後剩下的 34 題全部掛上「已證明」(當時拆過)。有驗證這一關,跟驗證有在驗,是兩件事。
這個反方我回應不完整。目前能做的只有把審核變成量得到的東西:每次放行留下審核人、時間、版本;指標看通過件數除以審核件數,還有退件原因。一個審核人如果從來沒退過件,要嘛前面的品質真的很好,要嘛他沒在看,這兩種情況在報表上長得一模一樣。
所以最後那一題還是開著的:怎麼確認人類在流程裡有確實審查,怎麼建立真正有效的審核考核機制。 這比用哪個模型審重要得多。
還沒解的題:ROI 只算降本增效
最後一點是 ROI 的設計。這點非常困難。
降本增效現在是很大的議題。但如果導入 AI 只是做降本增效,一定會造成很多問題。
用簡報上的示意試算看(這是假設數字,不是案例成果):每月 400 件,每件工時從 30 分降到 20 分,一個月回收 66.7 小時。以每小時 500 元估,工時價值 33,333 元。成本那邊,工具 8,000、維運 6,000、導入攤提 10,000,合計 24,000 元。帳面上每個月多出 9,333 元。
問題在那 66.7 小時。簡報上那一頁的結論是:
工時回收是產能,現金回報另核對。
省下來的工時不會自己變成錢。要讓它出現在帳上只有兩條路:少用人,或是用同一批人做更多生意。只走第一條,前面三個坑會一起惡化——補登的人少了、進去看的人少了、審核的人少了,剩下的人知道自己是下一個,補登跟審核只會更敷衍。
所以必須再想的是:怎麼透過這套流程產生新的 business、新的商務。那是另一個題目,我現在沒有可以寫成文章的答案。
反方:卡在中段,會不會就是模型在這些領域比較弱
這是對我這個讀法最直接的反駁。Karpathy 四月那則就講過,搜尋、寫作、給建議這類一般用途,不是進步最明顯的領域。照這個說法,多數專業人士只看到有限提升,原因在模型,流程怎麼設計都補不了。
對一半。鋸齒是真的,流程補不了模型的低谷。
但「數位的、可驗證的」這兩個條件有兩端。一端在實驗室:訓練環境裡有沒有這類任務。另一端在使用者:你的工作有沒有被整理成那個樣子。前一端企業動不了,後一端只有企業自己能動。程式會先衝上去,除了實驗室重押,也因為軟體工程師早就把自己的工作做成了版本控制加自動測試。
這個讀法有一個可以被推翻的預測:如果流程是關鍵,那麼把流程做到數位、可驗證的團隊,應該會比同產業的其他人更早往漏斗下面掉。我手上沒有數據能證明這件事。
另一個常聽到的反駁是:需求收不齊、改動沒紀錄、審核流於形式,這些是專案管理的老問題,跟 AI 無關。大部分是對的,這也是為什麼換更強的模型解不掉它們。不一樣的地方有兩個。產出的速度被拉高,審核的速度沒變,瓶頸整個移到審核點上。還有,人漏做一件事通常會留下空白,AI 補完一格缺漏、順手改掉一個狀態,留下的是一份看起來完整的東西。空白會被發現,完整不會。
對一個正要導入的主管來說,具體的差別是第一步做什麼。以前第一步是選模型、選工具。照這個讀法,第一步是先回答三個問題:哪一條進線要靠人補登、由誰補;AI 的改動留在哪一條人進得去的線上;審核點是誰簽名、怎麼知道他真的看了。三題答得出來,再去選模型。
坦白說
這篇有五個限制。
第一,把 Karpathy 的話接到流程上,是我的讀法,不是他的主張。 他在解釋模型能力為什麼分布成這樣,整篇沒有談企業導入。他明講的只有人類審查跟不上這一件;「可驗證」是我從訓練端延伸到使用端;輸入收不齊和 ROI 跟他的貼文無關。
第二,他的數字是餐巾紙估算。 四層的人數和比例是他自己抓的量級。5,000 人那一層在做什麼,外界只看得到預覽,我沒有辦法查證。
第三,全篇沒有我自己的量測數字。 三個坑是我在導入現場和準備演講時的觀察,沒有漏件數、退件率、回寫率可以給。唯一一組算式是示意假設,不是哪個案子的成果。
第四,「AI 產出、另一個 AI 覆核」我只能說成本低,不能說有效到什麼程度。 我沒有做過有覆核跟沒覆核的對照。不同廠商的模型會不會有共同盲點,這篇也沒有回答。
第五,McKinsey 跟 BCG 的數字都來自問卷。 BCG 那份是高階主管的自評,不是稽核過的財務結果。它們能說明「用了 AI 但價值沒出來」是普遍感受,不能說明原因是流程。
最重要的兩題也都沒解:怎麼確認人真的審了,以及 ROI 怎麼不靠降本增效成立。
但把題目放對位置還是有用。Karpathy 的漏斗裡,取得管道要花錢,模型的鋸齒要等實驗室。只有「把自己的工作變成數位的、可驗證的」這一項,今天就能開始做。
關鍵洞察
- 拿「數位的、可驗證的」檢查一條流程。 這是我從 Karpathy 的貼文延伸出來的檢查法:兩個都不符合的工作,我預期換再強的模型也只會看到有限的提升。
- 畫流程圖的時候,把「靠人補登」那一格畫出來並指定負責人。 紙本、便利貼、口頭交辦不會自己變成數位的。
- 給 AI 的第一條硬規則是「缺就標記,不准補」。 空白會被發現,被補滿的空白不會。
- 挑 Agent 之間的傳遞介質,先問人進不進得去。 能看、能改、能在裡面溝通,才談得上驗證。
- 審核點要量的是人,不是 AI。 多加一個 agent 覆核很便宜,但放行紀錄和退件原因才看得出人有沒有在審。
- 工時跟現金分開算。 省下的工時是產能,要另外回答它會變成少用人還是多做生意。
常見問題 Q&A
Q: Karpathy 說的 AI 能力認知漏斗是什麼?
Andrej Karpathy 在 2026 年 10 月 11 日的貼文裡,用餐巾紙估算把全球人口分成四層:約 60 億人(約 75%)幾乎沒接觸過大型語言模型(LLM);約 10 到 20 億人(約 20%)偶爾使用免費版聊天機器人;約 2,000 萬人(0.2%)在數學與程式上專業使用前沿模型,親眼看到大型專案由 agent 完成;約 5,000 人用得到實驗室內部系統。他認為這個落差正在變大,成因是問題的規模與野心、能力的鋸齒狀分布、以及取得管道。
Q: 為什麼大多數專業工作者用了 AI,只看到有限的提升?
Karpathy 的解釋是模型能力呈鋸齒狀(jaggedness),高峰集中在數位的、可驗證的、有經濟價值的領域,所以數學和程式先衝上去。我的讀法是,數位、可驗證這兩個條件有一部分掌握在使用者手上:企業流程裡的資訊常在紙本和口頭交辦裡(不數位),AI 改了什麼看不到、成果好壞沒有檢查標準(不可驗證)。把工作整理成數位、可驗證的樣子,是企業自己能做的部分。這是我的推論,沒有數據證明。
Q: 口頭交辦和紙本資訊,怎麼讓 AI 助理拿得到?
不要假設能全自動。我的做法是保留原本的進線習慣(訊息和截圖、Email、Excel 清單、口頭和現場),其中口頭和現場那一條明確指定由人轉述、補登,並在流程圖上畫出來。同時給 AI 一條硬規則:資訊缺少就標記、交給人確認,不准自行補完。AI 補上的內容看起來很合理,這種錯比留白更難發現。
Q: 為什麼建議用另一個 AI 來審核 AI 的產出?有什麼限制?
因為 AI 產出量遠高於人能審的量,先讓另一個 AI 驗證、覆核,再交給人放行,是成本最低的基本做法。最好用不同廠商的模型,因為無法確認同一家的 AI 能同時扛起執行和審核。限制有兩個:我沒有對照數據能說明它有效到什麼程度;而且東西標著「AI 審過了」,人會更容易直接蓋章。所以真正要建立的是對人的審核考核,也就是人在迴路中(Human-in-the-loop)是否真的有在看,例如放行紀錄、通過件數除以審核件數、退件原因。
Q: AI 導入的 ROI 只算省下的工時,會有什麼問題?
省下的工時是產能,不是現金。以示意試算為例:每月 400 件、每件從 30 分降到 20 分,回收 66.7 小時,以每小時 500 元估是 33,333 元,扣掉 24,000 元的月成本,帳面多 9,333 元。但這筆錢只有在少用人或多做生意時才會真的出現。只走少用人那條路,負責補登、檢查和審核的人會變少也更敷衍,流程品質跟著掉。比較站得住的方向是用這套流程去做新的業務,這題我目前沒有完整答案。
來源
- Andrej Karpathy, 2026 年 10 月 11 日貼文(引用自己 4 月 9 日的貼文)
- McKinsey, AI at work but not at scale(The state of AI in 2025 圖表頁)
- BCG, The Formula for Winning Enterprise AI Adoption in 2026(Applied AI Index 2026)
- 本站:多 Agent 架構我沒有蓋新東西:Slack 當 message queue、Google Drive 當檔案儲存、GitHub 當狀態與版本
- 本站:DeepMind 讓 100 個 agent 開數學會議
- 本站:一夜之間,OpenAI 丟出 722 篇數學手稿