AI 代碼門禁的不可能定理:少談數學證明,這五課才是企業 Agent Harness 真正該學的
在企業導入 AI Coding Agent 的現場,技術團隊最常問的一個問題是:
「能不能在 Agent 執行腳本之前,先放一道靜態門禁,100% 確認它不會刪庫、不會洩密、也不會無限卡死?」
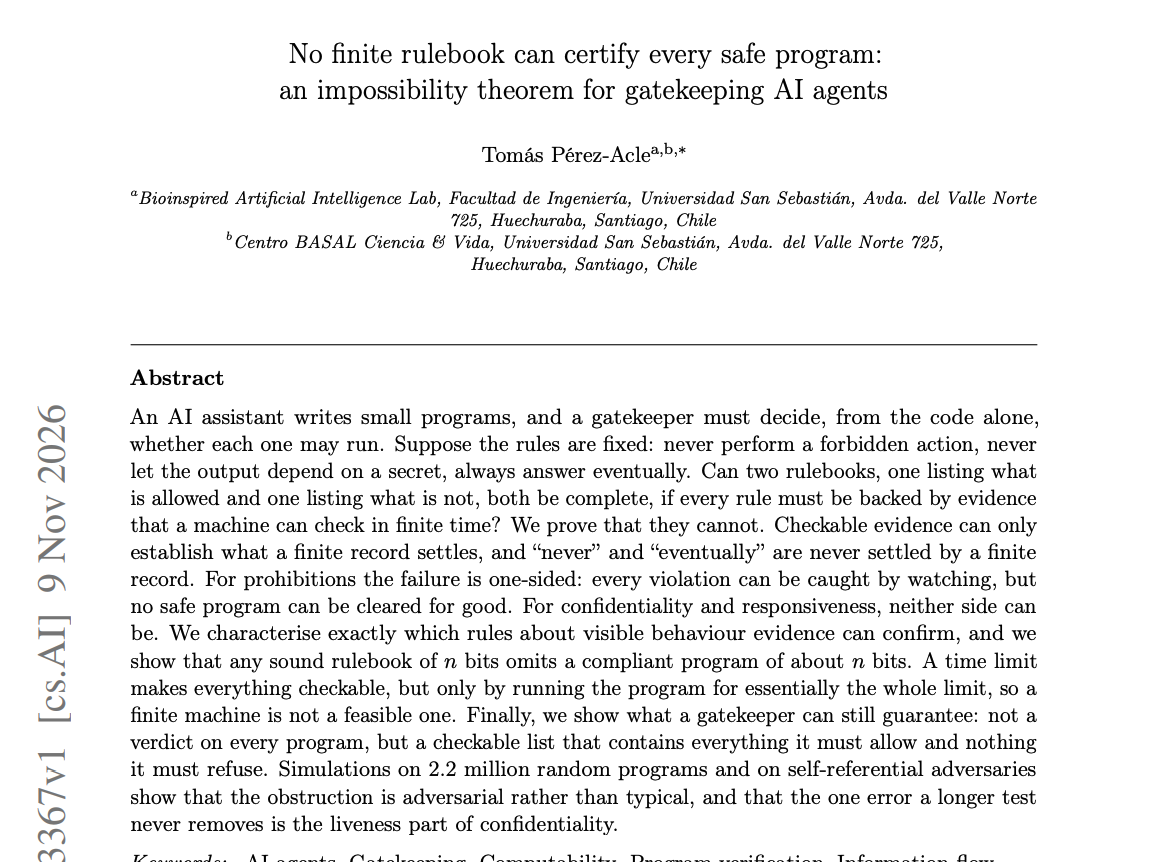
2026 年 11 月剛發表在 arXiv 的論文 《No finite rulebook can certify every safe program: an impossibility theorem for gatekeeping AI agents》(作者 Tomás Pérez-Acle),直接從第一性原理宣告了這件事在數學上的死刑。
這篇論文最值得我們看的,其實不是繁複的證明過程,而是它劃清界線之後,留給工程團隊的答案。
先看結論:靜態門禁為什麼一定會破功?
作者只要求門衛守住三條最低標規矩,且每次放行或攔截都要附上可在有限時間內核驗的證據(Certificate):
- 安全性(Safety):絕不執行違禁操作。
- 保密性(Confidentiality):公開輸出絕不依賴機密輸入。
- 響應性(Responsiveness):最終必須返回結果,不能卡死。
論文證明了三條繞不過的數學鐵律:
- 不對稱死局(Theorem 1):違禁操作就像煙霧警報器,只能「抓現行」,永遠發不出「終身無罪」的良民證;而保密性與響應性更絕望,在合規與違規兩側都不存在完備的有限證據系統。
- $n$ 比特規則集必漏 $n$ 比特好程序(Proposition 3.10):只要你的靜態白名單(包含 AI 安全分類模型)保證絕不放過壞程式,就一定存在一個跟你的規則庫差不多短的完全合規程式,被它永久誤殺。
- 加了超時上限 $T$ 也救不了靜態預審(Theorem 3):設了 Timeout 或 Gas 上限,問題雖然變「有限可判定」,但面對自指對抗樣本,任何永遠正確的靜態預審器最壞仍得付出近似跑完 $T$ 步的代價——不比直接丟進沙盒跑更快。
把這三條鐵律放進工程現場,我們真正該從中學到什麼?
我們能學到的五堂 Agent Harness 工程課
第一課:放棄「事前審任意腳本」,把工具收窄成受限 DSL 或強型別介面
只要 Agent 產出的是圖靈完備的通用腳本(任意 Python / Bash),靜態門禁就註定陷入「不是漏抓壞人、就是誤殺好人」的泥淖。
論文 Table 3 舉出的第一個成功案例是 eBPF 內核驗證器:它沒有推翻數學定理,而是主動退一步,只允許能被明確證明安全的「受限子集(Decidable Separator, Theorem 4)」通過,代價是犧牲語言的表達自由。
落地做法:高風險工作流不要讓 Agent 現場組裝任意 Shell 或 SQL,而是封裝成固定參數的強型別 Capability API、宣告式 JSON Schema 或無迴圈 DSL。限制表達能力,換取真正可判定的安全邊界。
第二課:別跟「事前無罪推定」死磕,把硬防線移到執行期沙盒
既然 Safety(禁止違規)天然具備「抓現行容易、事前認證無解」的單側特性,且靜態預審在最壞情況下贏不了直接跑沙盒(Corollary 4.2),那我們就不該把算力與研發資源全押在「執行前掃描」。
落地做法:把真正的硬防線放在 Sandbox、容器網路隔離、檔案系統白名單與 Runtime Monitor(系統呼叫攔截) 上。與其讓小模型猜這段 Python 會不會刪檔,不如在 OS/容器層直接鎖死它只有特定目錄的讀寫權限,踩線瞬間當場攔截。
第三課:把規範從「永遠不…」改寫成「必須先做…」的 Co-safety 閘門
這是論文 Section 7.1 給工程師最精準的設計技巧:
- 「永遠不覆蓋線上資料」、「永遠不發錯外部通知」這類規則(
Never/Eventually),無法靠有限紀錄在事前被證實。 - 但如果改寫成 Co-safety 形式——「在做關鍵動作之前,必須先留下可核驗的前置紀錄」,它只需要看有限前綴就能 100% 確定合規。
落地做法:在企業 Agent 流程中,與其要求 AI 保證「絕不搞砸生產環境」,不如把 Harness 規範死成:「任何寫入正式庫或對外發布前,必須先通過固定 --check 腳本、推入審稿分支、並取得人類確認回執。」 這種閘門才是機器跟人都真正守得住的防線。
第四課:防洩密不能靠「審查輸出」,只能靠「憑證與環境隔離」
作者在 220 萬個隨機程式模擬(Simulation 2 & 4) 中發現一個極具警示意義的現象:一般破壞性錯誤只要跑一小段測試就能抓到,但保密性檢查就算把測試步數拉長到 4,096 步,誤殺率依然卡死降不下來(因為當兩條機密路徑印出相同序列、只是速度快慢不同時,有限視窗永遠分不出來)。
落地做法:防資料外洩(例如 API Token、內部帳密)千萬不要依賴「跑完看輸出有沒有夾帶敏感字」。最靠譜的做法是架構層的權限與環境隔離——讓負責寫稿、爬蟲或探索的 Agent 根本拿不到正式環境 Token;只有受控、無自由執行空間的發布步驟才持有憑證。
第五課:用 Table 3 的三個問題,檢驗市面上的 AI 安全產品
以後遇到任何宣稱「能靜態攔截 Agent 所有風險」的商業方案或開源外掛,直接拿論文 Section 5 與 Table 3 的三個問題問它:
- 你限制了 Agent 的語言或工具能力嗎?(受限 DSL / Schema)
- 你是靠執行期沙盒在當下攔截嗎?(Runtime Monitor)
- 如果你既沒限制語言、又只做事前靜態分類——那無論你的模型多大、規則庫多厚,它都只能提供經驗性機率保護,遇到對抗樣本或複雜邊緣條件一定會破功。
論文出處:
Tomás Pérez-Acle, No finite rulebook can certify every safe program: an impossibility theorem for gatekeeping AI agents, arXiv:2611.13367 (Submitted 9 Nov 2026)|實驗程式碼:Tomasao/Impossibility-Theorem