Karpathy 的 HackerTube:AI 時代,比起隨手 vibe coding 一個小玩具,不如用 AI 當你的「獨家訊息整理演算法」
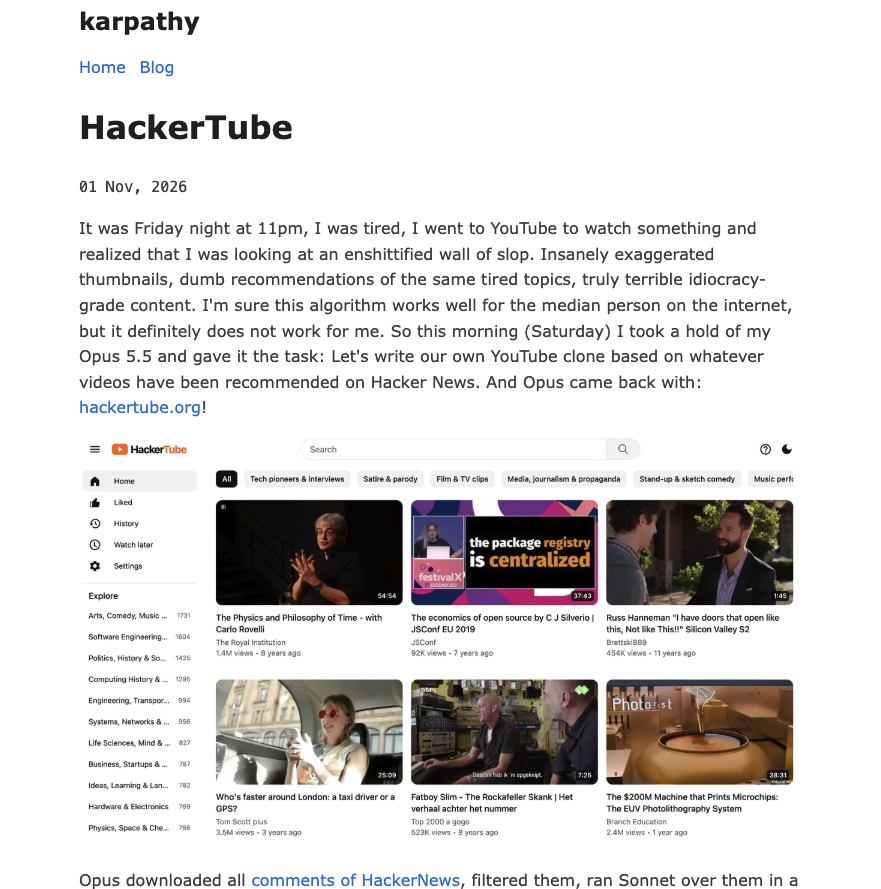
10 月底的週五晚上 11 點,Andrej Karpathy 很累,打開 YouTube 想隨便看點東西,結果看到滿屏誇張縮圖、同質題目的推薦,像電影《蠢蛋進化論》裡的內容,被他形容為「enshittified wall of slop」。他自己說,這套演算法大概對網路上的中位數使用者很好用,但對他不好用。
隔天早上,他把這件事交給 Claude Opus 5.5:花 2 小時做了一個以 Hacker News 留言推薦為來源的 YouTube clone——HackerTube。AI 幫他過濾掉 HN 留言裡的垃圾,留下 4 萬則推薦影片的留言,整理出 6,454 支影片、150 個主題,時間橫跨 2007 到 2026。甚至把整包原始資料開放給大家的 AI Agent 匯出重排,從抓取、篩選、分類到寫介面,全部交給 AI 完成。
很多人看到這個案例,討論的是 AI 兩小時就能搓出一個網站;但這件事真正讓我重新思考的是:
當 AI Coding 讓個人也能快速打造工具,我們是否終於有機會,不再只能接受平台「演算法」替我們安排好的資訊世界?
以前我們做不到,是因為面對海量資料,你時間不夠,只能靠平台演算法幫你過濾。但是有了 AI 的幫忙,身為讀者和觀眾,我們終於也能在這場與演算法的博弈裡佔上風。你不一定要像 Karpathy 一樣自己刻一個網站,但你可以叫 Agent 幫你 filter 今天的海量資訊。
這篇要講的,就是為什麼 AI 最應該幫你的不只是 Vibe Coding,而是當你「精神食糧」的把關者。
他手動只做三件事,卻換掉了整套推薦演算法
Karpathy 在附註裡說,他用 Claude Code 桌面版、Opus 5.5 的 Medium effort 當預設,現在只跟 Claude 講話。真正的手動工作只有三件:
- 去 Google Cloud UI 生一組 API key,用來查 YouTube 影片的中繼資料
- 開一台 VPS
- 買網域
之後他把 IP 丟給 Claude,叫它部署、加固、最佳化。這三件都卡在帳號、機器和付費;剩下的全交出去了。
清單裡有兩項設計最值得看:第一是拿掉誇張縮圖,改用影片 50% 處的畫面;第二是站台資料可以整包匯出給你的 agent,資料頁 hackertube.org/data 直接列出 videos.jsonl、mentions.jsonl、taxonomy.json。整條排序管線,從「哪些留言算數」到「最後怎麼排」,都可以被拿走、改寫。
為什麼平台最後都會長成一樣?自媒體創作者的殘酷實測
這不是 Karpathy 第一次對演算法資訊流出手。台灣時間 2 月 2 日,他就發文說自己最近回去用 RSS/Atom 訂閱,品質好的長文多得多,為了挑釁而生的浮濫內容少很多。貼文裡他寫了一句很精準的話:
Any product that happens to look a bit different today but that has fundamentally the same incentive structures will eventually converge to the same black hole at the center of gravity well.
任何看起來不一樣、但底層誘因結構相同的產品,最後都會掉進同一個重力井中央的黑洞。他附上 92 個 2025 年 HN 熱門部落格的 feed 清單;同一天有人問他 Substack,他直接回「another walled garden」。
HackerTube 可以看成這句話的推論:既然首頁和 Substack 走到最後是同一件事,解法就得動誘因結構——來源換成 HN 上的人推薦過的影片,狀態存在自己的瀏覽器,也不用帳號。看一個產品時先問:它的誘因是把人留住,還是幫你找到東西?
這件事,做過自媒體的人感受最深。
其實在平台上能不能紅,很多時候要先知道演算法要啥:
- 如果演算法要「吸眼球」,你就得放不是特別相關、但夠聳動的 title;
- 如果演算法要「增加討論」,你就得寫毀譽參半的文章(俗稱的黑紅)。
至於觀眾真正的感受?只能排第二。因為如果演算法不推、觀眾根本看不到,你內容做得再好也沒用。
就如同 Karpathy 說的一樣,當大家都在 AI 的幫助下學會 Hack 演算法,我們打開手機,最後就是看到一堆一模一樣的東西。但請不要怪自媒體工作者——因為我自己親身實測,順不順應演算法,對流量的影響可能是 100 倍。 在這個結構裡,你又能怎麼樣?
指望平台改規則、或指望創作者放棄 100 倍的流量是不切實際的。唯有看內容的人自己用 AI 拿回篩選權,這局才破得了。
被演算法控制的實驗證據
「演算法會影響人,而且關掉也未必能復原」已經有實驗證據,不只主觀感受。
今年 2 月 18 日,《Nature》刊出〈The political effects of X’s feed algorithm〉。研究團隊在 2023 年夏天做了七週的實地實驗:把活躍的美國 X 用戶隨機分派成「追蹤」(時間序)和「For You」(演算法)兩種時間軸,與 X 沒有合作,也不用平台內部數據。
結論很關鍵:把演算法「打開」有效果,把演算法「關掉」沒有同等效果。
被切到演算法的人,政策優先順序、對川普相關調查的看法、對烏克蘭戰爭的態度,整體指標往保守方向移動 0.12 個標準差;但被切回時間序的人,這些態度幾乎沒動。這跟 2020 年美國大選期間與 Meta 合作的實驗對得上:把臉書、IG 的時間軸換成時間序,政治態度測不出效果。《Nature》的解釋是,一開始被餵過的人,效果會留下來。
機制也支持這點:演算法會推保守內容、壓傳統媒體(新聞機構的貼文少 58.1%),被推的人開始追蹤保守政治行動者的帳號,就算把演算法關掉之後還是繼續追。效果主要出現在共和黨與獨立選民身上;兩邊都不影響感情極化與黨派認同。
範圍要講清楚:這是 2023 年、X、美國用戶、政治態度,不能外推到所有平台,也不代表「看 YouTube 會把你變怎樣」。但它清楚證明了演算法會透過改變你的關注清單,留下長期影響。
內容供給端也一樣。Kapwing 2025 年 11 月的報告開新帳號,記錄前 500 支 YouTube Shorts:104 支(21%)是 AI 生成,165 支(33%)是 brainrot,資料到 2025 年 10 月。這是一個新帳號的樣本,不是整個 YouTube 的統計,但它量的是新帳號一開始會看到什麼。
10 月 30 日,Wharton 教授 Ethan Mollick 也說,他每則貼文底下都有幾十則明顯的 AI 浮濫回覆;更糟的是,真人回覆(他舉的例子是 Anthropic 的人來回應他的問題)不會被回覆演算法優先顯示。
我的雙軌分工:平台演算法探索未知,AI 掌握認證過的資訊源
其實我已經在用 AI 幫我過濾資訊了。現在我採用的是「雙軌分工」:
- 我依舊看平台——平台演算法幫我「探索未知」:即使現在有 AI,我依然會使用 X、抖音和 YouTube。因為這些平台能讓我接觸原本不知道的新事物、觀察大家正在討論什麼、哪些趨勢正在形成,持續建立自己的「網感」。
- AI 演算法幫我「掌握認證過的資訊源」:對於已經確定值得關注的來源,我不再等平台推播。我用 GrokBot 篩選 X 上的資訊,讓 AI 追蹤固定的 YouTube Podcast,並補充 Hacker News 上與 AI 相關的消息,每天早上自動整理成一份晨間資訊給我閱讀。
這樣的方式並沒有取代我原本使用社群平台的習慣,而是讓平台演算法幫我探索未知,AI 幫我掌握已知,而最終的選擇權,始終掌握在我自己手上。
目前我的管道順序是這樣排的:
| 順序 | 管道 | 我的用法 | 為什麼 |
|---|---|---|---|
| 第一優先 | X | 主要獲取管道(探索+AI 篩選) | 演算法目前還算 OK;用 Grok 幫忙搜尋;API 比較親民 |
| 也常看 | 抖音 | 大量 AI 新聞(探索未知) | 建立網感很棒的管道 |
| 第二 | YouTube | 不當主要管道,更多是一種呈現方式 | 還是會看,固定的 Podcast 值得聽、值得看 |
| 第三 | Facebook、LinkedIn、IG | 還是可用 | 不當主要的獲取管道 |
X 放第一有一個現實理由:它的 API 是 pay-per-use,沒有訂閱制,Posts: Read 一筆 $0.005,同一則貼文在同一個 UTC 日內重複讀取不算第二次錢。每天盯幾十個認證帳號的小工具,成本算得出來。
Grok 則是讓我搜尋方便很多。Brian Roemmele 用 Grok Tasks 做每天早上的 X 摘要,形容成「取代噪音時間軸與無止盡手動滑動」:從「平台餵你」變成「你去要」。
別人怎麼換掉演算法?
目前大家換掉演算法的做法可以分成三層:自己訂閱來源、自建聚合器、委託 AI 寫稿的管線。
- 向陽喬木的 Obsidian RSS 插件,9 月更新時一次加了 600 個資訊源。
- 卡爾的 AI 沃茨重做了一版資訊工作流,他的觀察是:如果只是讓 AI 從全網找回前 10%,結果會跟平台給你的資訊流高度重複。
- swyx 把 Opus 5.5 跑出來的 AINews 跟 6 Sol 並排比較,差距「night and day」,之後 Opus 5.5 成了預設。
第二層的規則你改得到,第三層的標準你通常看不到。
AI filter 當然也有偏見,重點是誰設定標準
把資訊交給 AI filter,不代表沒有偏見。
X 也是演算法,《Nature》那篇講的就是 X,所以「目前還算 OK」只代表目前,不代表中立。Nikita Bier 今年 7 月(時任 X 產品負責人)時說過,custom timeline 上的停留時間與互動,會塑造你的 For You。另外,X 開源的 For You 程式碼寫的是用 transformer 排序;他說由 Grok 排序與標註的是 AI custom timeline,兩件事別混。
HackerTube 也有偏見,它把排序權交給 HN 的品味。發布當天就有人說「it all so bad」;也有人回,最新的影片是五個月前,「closer to a time capsule」。
再往下,品味到底是人的還是模型的?圈內人自己也吵:
- Chamath 說判斷與品味仍是人類獨有的領域;
- Marc Andreessen 說頂尖模型在長期規劃、點子生成和品味上都「quite good」;
- Ethan Mollick 說在 agent 時代還講 AI 沒有品味是「obviously false」,但也承認他比較能接受對「AI 選擇的品質或多樣性」的質疑;
- Paul Graham 講的是創作端:人人都能做東西之後,差別在你選擇做什麼。
放回資訊攝取,品味與標準的問題不會消失,只會換人扛。但是你可以選擇讓 AI 篩選,也可以選擇自己探索;可以接受平台推薦,也可以建立自己的資訊來源。真正要問的是:誰設定標準?你能不能改? HackerTube 的資料可以整包匯出,這題它答得出來;平台首頁答不出來。
可以做的四件事
想讓 AI 當你精神食糧的把關者,現在可以做四件事:
- 把管道順序與角色寫出來。 哪一條負責「探索未知、建立網感」,哪一條負責「掌握認證過的資訊源」,寫給自己看。
- 把篩選標準寫清楚,再交給 AI。 「找一些好的討論」不算標準,「本人第一手、附原始連結、整理成每日晨間簡報」才算。標準寫出來,之後才改得動。
- 至少留一條不經演算法的來源。 RSS、newsletter、一支固定的 Podcast 都可以。它不會更聰明,但它不會因為你這週多滑了兩分鐘就換內容。
- 定期看 AI 漏了什麼。 每週挑一次,自己手動搜尋對照。
資訊自主權,不是拒絕平台演算法,而是擁有選擇、調整的權利。
之前你時間不夠,無法即時過濾海量資訊;現在有了 AI,它最應該幫你的,不只是 Vibe Coding,而是當你「精神食糧」的把關者。但那是要動手才有的結果,不是換一個工具就自動發生。
延伸閱讀
參考資料
- Karpathy:HackerTube(頁面日期 01 Nov, 2026)
- HackerTube 資料頁
- Karpathy 的 RSS 貼文(2026-02-01 UTC,台北時間 2 月 2 日)
- Karpathy 回覆 Substack
- Gauthier et al., The political effects of X’s feed algorithm, Nature 652, 416–423 (2026)
- Guess et al., How do social media feed algorithms affect attitudes and behavior in an election campaign? Science (2023)
- Kapwing:AI Slop Report(2025-11-28)
- Ethan Mollick:回覆演算法不優先顯示真人回覆(2026-10-30)
- Ethan Mollick:反駁 AI 沒有判斷與品味
- X API 定價文件
- xai-org/x-algorithm
- Nikita Bier:custom timeline 的互動會塑造 For You
- Brian Roemmele:用 Grok Tasks 做每日 X 摘要
- 向陽喬木:RSS Obsidian 插件更新
- 卡爾的 AI 沃茨:重做資訊工作流
- swyx:AINews 改用 Opus 5.5
- Paul Graham:AI 時代品味更重要
- Marc Andreessen:模型擅長長期規劃、點子與品味
- Chamath:判斷與品味仍屬人類
- parsecranberry:對 HackerTube 的批評
- Lincoln:最新影片是五個月前