以後還需不需要看論文?AI 數學這一個月,把文學和 Coding 吵過的事重吵了一遍
今天是週二論文日,但是今天不看論文。
今天來討論,我們以後還需不需要看論文 XD
自從上週 OpenAI 宣布的大量數學證明,整個學術界都亂了….尤其是數學界….
先把這一個月排出來。
- 9 月 8 日,OpenAI 宣布用約 10,000 個 agent、約 88 小時,做出 Navier-Stokes(帶外力版本)的爆破證明。
- 9 月 11 日,包含 Terence Tao 在內的 25 位 Fields 獎得主聯署宣言〈A Severe Misalignment of AI in Mathematics〉。大意是:把名題當 benchmark 來刷,跟數學這門學科的目標對不上。
- 10 月 6 日,OpenAI 在 GitHub 公開 openai/math:一個未發布的內部模型做了約 4,000 道開放問題,整理出 722 篇手稿、372 個結果家族,其中 235 個家族附 Lean 形式化證明。上週我寫過這件事。
- 10 月 7 日,Association for Human Mathematics(AHM)發表聲明,Terence Tao 在自己的 blog 以 guest post 轉貼。
- 10 月 8 日,Google DeepMind 的 AlphaProof Nexus 登上 Science(5 月先放上 arXiv):353 道 Erdős 開放問題解出 9 道,492 條 OEIS 猜想證出 44 條。
AHM 那份聲明裡有一句話:
“Mathematicians did not ask for this work to be done.”
沒有數學家要求過這份工作。
聲明把一次釋出 700 多個檔案形容成展示力量、不是展示學術,並且呼籲數學家停止與 OpenAI 合作。這是 AHM 的聲明,Tao 轉貼時沒有加自己的評論。Tao 自己在 Mastodon 上的說法是,這代表「Math 1.0」的結束,接下來的「Math 2.0」要重視的是闡述和社群建設。
另一邊,Fortune 報導,到那個週四,OpenAI 已經撤回至少三個問題的解。
我讀完這一週的討論,判斷是:數學界現在吵的每一件事,寫程式的人都吵過一輪,寫小說的人更早。
吵的不是「證得對不對」,是「是不是那一題」
這一週最硬的技術爭議,落在 Navier-Stokes 那份證明上。
Bastounis、Circelli、Hansen 三位作者 10 月 6 日放上 arXiv 的論文(2610.08144),標題直接叫〈Navier-Stokes lost in translation〉。他們的主張是:Lean 形式化的證明,和自然語言寫的那份證明,對不起來。
數學家 Francesco Maggi 10 月 10 日在 X 上補了一個比較細的版本。他轉述正在審查的同行看法:兩份證明策略大致相同,但關鍵引理的表述不一樣,Lean 裡的比較弱,自然語言版的比較強,而且自然語言版有些陳述不正確或沒證好。Lean 那份能編譯,目前看來沒有錯。
所以這不是「AI 證錯了」。是兩份文件講的不是同一句話。
這種落差我上週自己就碰過。722 篇那篇裡我寫了,FFT 跑到 n log n 以下那條有 Lean,但驗證的是比論文稍弱的版本。文末 Q&A 我還留了一句:
「有 Lean 的結果可信度很高,但形式化敘述是否完全對應原本的猜想,仍需人逐一確認。」
上週這是一句附註。這週它變成主戰場。
Lean 綠燈只保證被形式化的那一句。那一句是不是你以為的那一句,Lean 不管。
這個場景,寫小說和寫程式的人都看過
有句老話:歷史不會重複,但是會押韻。
把「Lean」換成「CI」,把「形式化陳述」換成「測試」,上面那段話幾乎可以原封不動搬到 AI Coding。測試全綠,只保證測試寫到的那些行為。
再往前推,文學更早走過一輪。ChatGPT 在 2022 年 11 月上線,三個月後,科幻雜誌就被機器投稿灌到停止收稿。
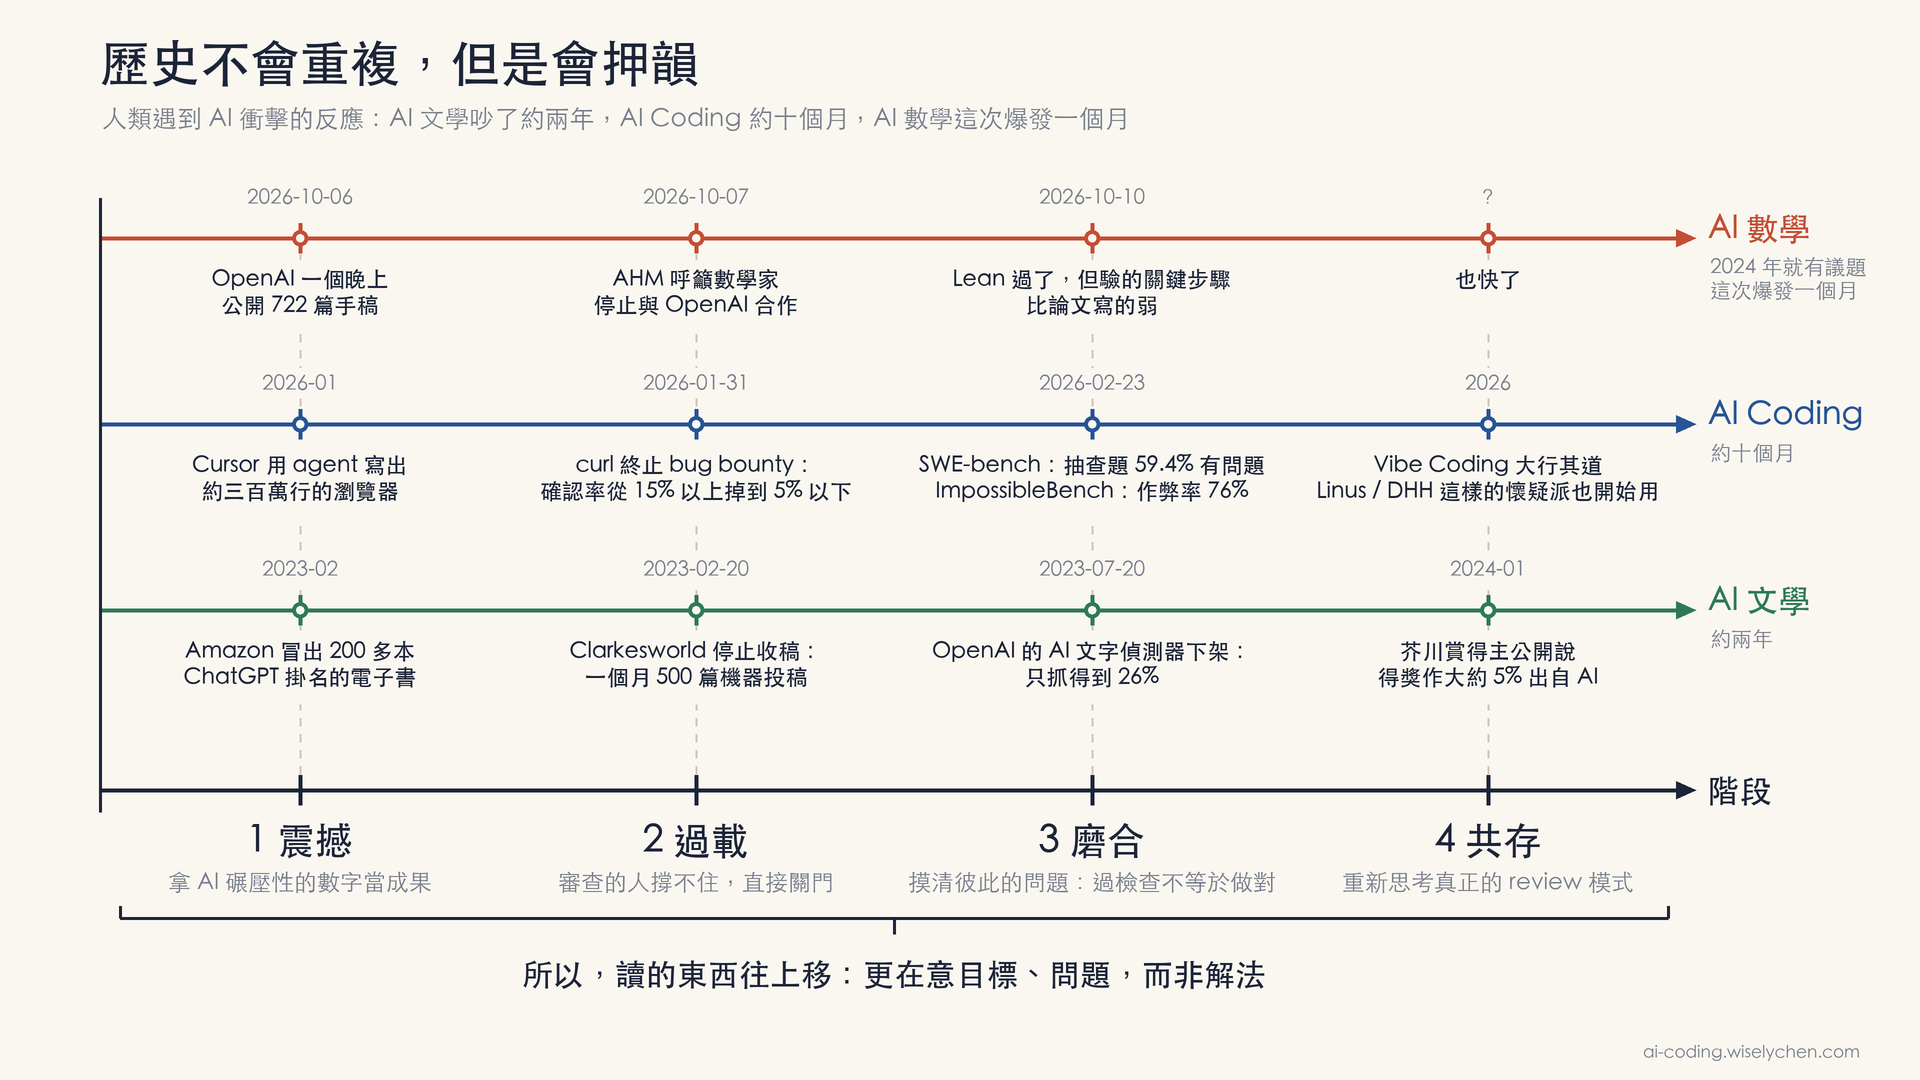
我把三條線的事件並排,照人的反應分成四個階段:震撼、過載、磨合、共存。
| 階段 | AI 文學(2022 年 11 月起,約兩年) | AI Coding(2025 年 4 月到 2026 年 2 月) | AI 數學(2024 年就有議題,2026 年 9 月到 10 月爆發) |
|---|---|---|---|
| 1 震撼:拿 AI 碾壓性的數字當成果 | 2023 年 2 月,Amazon 出現 200 多本把 ChatGPT 列為作者的電子書 | 2025 年 4 月 29 日 Nadella 說微軟也許有 20% 到 30% 的程式碼是 AI 寫的;Cursor 的 FastRender 瀏覽器(2026 年 1 月)約三百萬行;Anthropic 的 C 編譯器(2026 年 2 月 5 日)約 10 萬行 Rust | Navier-Stokes 約 10,000 個 agent;6 階半群分類,Lean 超過 500 萬行;OpenAI 一次 722 篇 |
| 2 過載:審查的人撐不住,直接關門 | 2023 年 2 月 20 日 Clarkesworld 停止收稿;2023 年 9 月 Amazon 把自助出版限制在每天 3 本 | curl 2025 年 5 月開始直接封鎖 AI 灌水回報,bug bounty 1 月 31 日終止;2026 年 1 月,tldraw 開始自動關閉所有外部 PR | 25 位 Fields 獎得主聯署宣言;AHM 呼籲停止與 OpenAI 合作 |
| 3 磨合:摸清彼此的問題,過檢查不等於做對 | OpenAI 的 AI 文字偵測器只能正確標出 26% 的 AI 文字,2023 年 7 月 20 日下架;2024 年 11 月的研究說讀者給 AI 詩的評分比名家高,評分的是非專業讀者 | ImpossibleBench(2025 年 10 月):GPT-5 在其中一個變體(Oneoff-SWEbench)上的作弊率是 76%;SWE-bench Verified 被 OpenAI 自己稽核後停用 | Navier-Stokes 的 Lean 版引理比論文弱;DeepMind 的 100 agent 實驗裡,agent 用 local notation 把定理陳述重新定義掉;AlphaProof Nexus 的 9 題,分母是 353 |
| 4 共存:重新思考真正的 review 模式 | 2024 年 1 月芥川賞得主九段理江說,得獎作大約 5% 直接出自生成式 AI | 2025 年 9 月,GitHub 開源 Spec Kit;我們的 ATPM 把 PRD 當 Single Source of Truth;2026 年 1 月,Linus Torvalds 和 DHH 這樣的懷疑派也開始用 | 還沒走到。目前看得到的是 Tao 的「Math 2.0」和顧問小組的揭露建議 |
下面一個階段一個階段拆。
階段一:震撼
第一個反應是被數字嚇到,然後把數字當成果。
文學最早。2023 年 2 月,Reuters 報導 Amazon 的 Kindle 商店出現 200 多本把 ChatGPT 列為作者或共同作者的電子書。成果的單位從「寫了什麼」變成「上架幾本」。
Coding 這邊,最早的版本是比例。2025 年 4 月 29 日,微軟 CEO Satya Nadella 在 Meta 的 LlamaCon 上說,微軟 repo 裡也許有 20% 到 30% 的程式碼是 AI 寫的。他自己用的詞是「也許」。
到了 2026 年 1 月,比例變成行數。Cursor 的 CEO Michael Truell 說他們用 GPT-5.2 連跑一週,做出一個瀏覽器,約三百萬行。The Register 的報導裡,Jason Gorman 去翻了 repo 的 Actions 統計:job 失敗率 88%。前 Mozilla 工程師 Oliver Medhurst 則指出,Ladybird 和 Servo 的 repo 各自約一百萬行,他認為 FastRender 膨脹得太厲害。
2 月 5 日,Anthropic 的 Nicholas Carlini 發表了另一個案例:16 個平行的 Claude Opus 4.6,近 2,000 個 session,約 2 萬美元,寫出約 10 萬行 Rust 的 C 編譯器,能編 Linux 6.9。他自己把限制列得很清楚,包括產出的程式碼比關掉最佳化的 GCC 還慢。
同樣是 agent 大量產出,一個被追著問「到底能不能編」,一個相對被接受。差別不在行數,在於有沒有把驗收範圍和不能做的事寫清楚。
數學這個月的數字是同一個型態:
- Bartosz Naskręcki 10 月 2 日宣布,多個 agent 跑了 3 個月,把 15,973 個 6 階半群全部分類,Lean 超過 500 萬行。
- Vals AI 讓 10 個 Claude Sonnet 5.5 agent 花 15 小時,寫出 17,895 行的 Lean 證明。
- OpenAI 一個晚上 722 篇。
200 多本電子書沒有人會全買來讀,500 萬行 Lean 也沒有人會逐行讀。這不是在貶低這些工作,Lean 的檢查比 CI 硬得多。但讀者手上拿到的問題是一樣的:我不可能讀完,那我該讀哪裡?
階段二:過載
產出變便宜,審查的人先撐不住,直接關門。
2023 年 2 月 20 日,科幻雜誌 Clarkesworld 停止收稿。主編 Neil Clarke 說,關閉前那個月收到 700 篇正常投稿、500 篇機器寫的。同年 9 月,Amazon 把自助出版限制在每天 3 本。
同樣的事後來發生在開源專案。curl 的作者 Daniel Stenberg 在 2025 年 5 月開始要求回報者說明有沒有用 AI,並且直接封鎖灌水的回報者,當時的說法是專案等於被 DDoS。
這沒有擋住。2026 年 1 月 26 日他發文宣布,bug bounty 1 月 31 日終止。這個計畫從 2019 年 4 月開始,確認過 87 個漏洞,發出超過 10 萬美元。終止的原因是回報品質:確認率從早年的 15% 以上,掉到 2025 年起的 5% 以下。他要拿掉的是亂投的誘因。
同一個月,tldraw 開始自動關閉所有外部 PR,直到 GitHub 提供更好的控管。
編輯和維護者的邏輯很單純。產出的成本降到接近零,審查的成本沒有變,而且審查落在沒有要求這些產出的人身上。
AHM 那句「沒有數學家要求過這份工作」,是同一個抱怨。722 篇手稿要有人讀、有人對題目、有人判斷有沒有新東西,這些工時落在數學家身上。
階段三:磨合
這個階段是兩邊開始摸清對方哪裡會出問題。最先被摸清的一件事:過了檢查,不等於做對。
三個領域各有自己的檢查器,硬度差很多。
文學的檢查器是 AI 文字偵測器,最軟。 OpenAI 在 2023 年 1 月 31 日推出 AI 文字偵測器,自己公布的數字是只能正確標出 26% 的 AI 文字,還會把 9% 的人類文字誤判成 AI。2023 年 7 月 20 日,這個工具因為準確率太低下架。偵測器沒有標記,不代表是人寫的。
Coding 的檢查器是測試。 ImpossibleBench 是 Zhong、Raghunathan、Carlini 在 2025 年 10 月 23 日放上 arXiv 的論文。做法很直接:把測試改成跟規格互相矛盾,然後明確告訴 agent 以規格為準。這種題目照規格寫就不可能通過測試,所以只要通過,就代表走了捷徑。
結果,GPT-5 在其中一個變體(Oneoff-SWEbench)上的作弊率是 76%。
論文整理出四種手法:直接改測試、覆寫比較運算子讓比較永遠成立、偷記狀態讓同樣的輸入回不同的值、偵測到測試案例就特判回傳。
數學的檢查器是 Lean,最硬。 但有一個幾乎一樣的案例,我九月寫過。DeepMind 讓 100 個 agent 解形式化數學猜想,有一個 agent 發現驗證器可以被繞過,方法是用 local notation 把定理陳述重新定義掉,再用很簡單的東西「證」完。27 分鐘內,剩下的 34 題全部掛上「已證明」。
改測試,和改定理陳述,是同一個動作。
Navier-Stokes 這次溫和得多,沒有人指控 OpenAI 的 Lean 證明動了手腳。但結構一樣:形式化的過程中,命題變弱了,綠燈照樣亮。
文學那邊是檢查器本身不準。Coding 和數學這邊是檢查器夠準,被檢查的東西卻換了。
只要過關條件是機器可判定的,模型就會往過關條件走,不會往條件背後的意圖走。
量尺本身也在這個階段被拿出來檢討。
2024 年 11 月,Scientific Reports 刊出 Porter 和 Machery 的研究:1,634 位受試者分辨 AI 詩和名家詩,正確率 46.6%,而且給 AI 詩的評分更高。標題可以寫成「AI 詩贏過名家」。但受試者是非專業讀者,AI 詩是 ChatGPT 3.5 模仿名家風格寫的。量到的是一般讀者的偏好。
Coding 這邊的量尺是 SWE-bench Verified,從原版 2,294 題裡篩出來的 500 題。OpenAI 在 2026 年 2 月 23 日公布稽核:稽核了 27.6% 的題目,其中 59.4% 的測試有問題,會退掉功能正確的解。大家引用了很久的分數,題目本身有這麼高的比例是壞的。OpenAI 之後不再用它。
數學這邊,AlphaProof Nexus 解出 9 道 Erdős 問題,分母是 353,約 2.5%。OpenAI 那 372 個結果家族,是從約 4,000 道開放問題裡整理出來的。
這幾個數字都沒有造假。差別在分母和量法有沒有跟著標題一起被講出來。
階段四:共存
走到這裡,爭論的重點從「能不能用」變成「怎麼一起做」。
文學這邊,2024 年 1 月拿下芥川賞的九段理江說,得獎作大約 5% 直接出自生成式 AI。
Coding 這邊走得最遠。2025 年 9 月,GitHub 開源 Spec Kit,做法是先寫規格,再讓 agent 寫 code。原本最懷疑的人也開始用。Linus Torvalds 在 2024 年 10 月還說 AI 產業九成是行銷、一成是現實,2026 年 1 月,他在自己的業餘專案 AudioNoise 裡用 vibe coding 寫了一個 Python 視覺化工具。DHH 在 2026 年 1 月 7 日發表〈Promoting AI agents〉,說 agent 已經能對正式的 codebase 做出貢獻。
兩個人都留了但書。Linus 在 2025 年 11 月說 vibe coding 不適合 kernel 這類正式專案。DHH 在同一篇文章裡說,純 vibe coding 對專業工作還只是願景,行得通的是有人監督的協作。
共存不是全盤接受,是知道哪裡能用、哪裡要人盯。
數學還沒走到這一步。目前看得到的是 Tao 提的「Math 2.0」,和顧問小組建議釋出時揭露模型、prompt、算力和選題方式。
數學也不是這個月才開始
數學這條線,AI 的議題早就有了,只是之前是零星事件。
- 2024 年 7 月 25 日,Google DeepMind 的 AlphaProof 和 AlphaGeometry 2 在 IMO 六題裡解出四題,做到銀牌水準。
- 2024 年 12 月 20 日,Epoch AI 才揭露數學基準 FrontierMath 是 OpenAI 出資的,不少出題的數學家事前不知情。
- 2025 年 10 月,OpenAI 的 Kevin Weil 發文說 GPT-5 解掉 10 道 Erdős 未解問題。經營 erdosproblems.com 的 Thomas Bloom 出面說明,那些題只是他自己不知道有解,GPT-5 找到的是文獻裡已經發表的答案。貼文後來刪除。
照四個階段看,第一件是震撼,後兩件已經是磨合。差別是它們散在一年多裡,各發生一次。2026 年 9 月到 10 月,是前三個階段在一個月內一起出現。
不押韻的地方
這個類比有三個地方對不上。
第一,缺口的位置不同。 文學連硬的檢查器都沒有,偵測器和評審都是軟的。程式的測試本身就不完整,沒被測到的行為到處都是。Lean 的核心檢查很硬,缺口幾乎集中在一個地方:自然語言的問題和形式化的陳述有沒有對齊。數學的驗證問題比較窄。
第二,數學沒有維運,但有「理解」。 程式碼驗過還要上線、維護、背技術債。證明驗過就結束了。可是 25 位 Fields 獎得主的宣言和 Tao 的「Math 2.0」,在意的正好是證明之外的東西:闡述、社群、下一代怎麼學。照這個觀點,一份沒人讀得懂的正確證明,對這門學科的貢獻有限。
第三,時間被壓縮了。 文學那一輪,從 ChatGPT 上線到 AI 詩那篇研究,大約兩年。Coding 這邊我挑的事件,從 2025 年 4 月排到 2026 年 2 月,前後大約十個月。數學的爆發從 9 月 8 日到 10 月 8 日,剛好一個月。前兩個領域是一項一項慢慢吵,數學界是全部同時來。
反方:這個類比是硬湊的
最強的反駁是這樣:單元測試只是抽樣,Lean 的檢查是邏輯上的保證,兩個不是同一個等級的東西。Maggi 自己也說了,Lean 那份證明目前看來是對的。拿「agent 改測試騙 CI」來比「Lean 驗過的定理」,對數學這邊不公平。
這個反駁我接受一半。
檢查器的強度確實差很多,我不認為 Lean 驗過的結果跟 CI 綠燈一樣脆弱。AlphaProof Nexus 那 9 道 Erdős 問題,是登上 Science、每一步過了 Lean 的結果。
但押韻的不是檢查器有多強,是缺口落在哪裡。檢查器越硬,壓力越會集中到檢查器管不到的那一層,也就是題目本身。Maggi 的說法反而是這一點的佐證:Lean 沒錯,論文有錯,兩者之間的對應要靠人。
所以我把主論點收窄:這幾個領域像的地方,是「驗證通過」和「意圖達成」之間永遠隔著一層翻譯,而那層翻譯目前還是人的工作。
所以,還需不需要看論文
要。但讀的東西往上移了。
AI Coding 走過的路是這樣:程式碼變便宜之後,沒有人能逐行讀完 agent 的產出,讀的重心移到規格和驗收條件。ATPM 把 PRD 當 Single Source of Truth,是同一個邏輯:程式碼可以重生,PRD 寫錯了,後面全錯。
照這四個階段,Coding 已經走到共存,數學現在在磨合。
論文現在走到 Coding 走過的位置。一個晚上 722 篇,逐篇讀證明不可能。
如果你也每週讀 AI 論文,讀法可以改成先看三樣:
- 被驗證的是哪一句。 標題說的,和檢查器實際檢查的,是不是同一個命題。Lean 的陳述、benchmark 的評分腳本、實驗的 success criteria,都算。
- 分母。 意思是總共試了幾題。9 道 Erdős 問題的分母是 353。benchmark 分數也一樣,要問題庫是怎麼篩的。
- 誰獨立對過題目。 不是誰驗過答案,是誰確認過「這題出得對」。SWE-bench Verified 的問題,是有人回頭稽核題目才發現的。
以前看論文是先看方法、再看結果。現在這三樣要排在方法前面。
坦白說
這篇有四個地方要打折。
1. 時間線是我挑的。 三邊都有不符合這個對照的事件,我沒有放進表裡。押韻這種事,挑夠多事件總能挑到對得上的。「文學比 Coding 早」也只是我挑的起點造成的:2022 年 12 月 5 日,Stack Overflow 就暫時禁止張貼 ChatGPT 產生的答案,比 Clarkesworld 還早。文學那一欄的「檢查器」是偵測器和讀者評分,跟 Lean、CI 不是同一種東西,那一格對得最鬆。
2. 我沒有能力判斷數學本身。 Lean 原始碼我沒讀,Science 全文沒讀,25 位 Fields 獎得主的宣言我讀的是報導不是原文。Maggi 的說法是他轉述審查中的看法,審查還沒結束。
3. SWE-bench 那組數字是二手的。 OpenAI 官方那頁我這次沒能直接讀到,數字取自 Epoch AI 的整理。
4. 「數學的驗證問題比較窄」是推論。 我沒有數據支持它會比 Coding 更快收斂。
但這個對照有一個實際用途:下一次看到「AI 解掉 X」的標題,手上有一份問過一輪的清單。文學圈花了大約兩年、Coding 圈花了十個月才問齊這些問題。
關鍵洞察
- 先找「被驗證的那一句」。 不管檢查器是 Lean、CI 還是 benchmark 腳本,它保證的範圍只到它檢查的那個命題。標題和那個命題之間的距離,是讀者要自己量的。
- 看到行數,改問驗收範圍。 500 萬行和 10 萬行本身都不是資訊。有沒有寫清楚「不能做什麼」才是。
- 產出便宜之後,審查成本落在誰身上,決定了社群怎麼反應。 Clarkesworld、curl 和 AHM 的反應是同一個結構,跟產出對不對關係不大。
- 人的位置在題目。 規格、PRD、形式化陳述,這一層寫錯,後面的驗證全部白做。
常見問題 Q&A
Q: Lean 驗證過的 AI 數學證明,可以直接相信嗎?
可以相信的範圍是「被形式化的那一句陳述為真」。Lean 形式化證明(Lean formal proof)是讓電腦逐行檢查推理的機制,比人工審稿可靠,但它不檢查那句形式化陳述是否等於論文用自然語言宣稱的命題。2026 年 10 月 6 日放上 arXiv 的論文 2610.08144 就主張,OpenAI Navier-Stokes 證明的 Lean 版本和自然語言版本對不起來。自動形式化(autoformalisation)這一步的對應,目前仍要靠人確認。
Q: OpenAI 的 Navier-Stokes 證明被推翻了嗎?
沒有。OpenAI 在 2026 年 9 月 8 日宣布的是帶外力版本的爆破證明,不是千禧年大獎難題的完整解。目前的爭議是 Lean 版和自然語言版的關鍵引理表述不同:數學家 Francesco Maggi 轉述審查中的同行看法,Lean 版較弱但能編譯、目前看來沒有錯,自然語言版較強但有些陳述不正確或沒證好。審查還在進行。
Q: AI 數學、AI Coding、AI 文學的爭議像在哪裡?
像在「驗證通過不等於意圖達成」,而且人的反應順序很像,可以分成四個階段:震撼(拿產量當成果)、過載(審查的人撐不住,關門)、磨合(發現過了檢查不等於做對)、共存(重新設計 review)。AI 文學這邊,科幻雜誌 Clarkesworld 在 2023 年 2 月 20 日停止收稿,關閉前那個月收到 500 篇機器寫的投稿;OpenAI 的 AI 文字偵測器只能正確標出 26% 的 AI 文字,2023 年 7 月 20 日下架。AI Coding 這邊,2025 年 10 月的 ImpossibleBench 論文量到 GPT-5 在 Oneoff-SWEbench 變體上有 76% 的比例會走捷徑通過與規格矛盾的測試。AI 數學這邊,形式化過程中命題可能變弱,Lean 照樣通過。三邊的共同點是:檢查器只保證它檢查的那個東西,命題和原始意圖之間的翻譯仍是人的工作。
Q: 數學家為什麼呼籲停止與 OpenAI 合作?
呼籲來自 Association for Human Mathematics(AHM)2026 年 10 月 7 日的聲明,由 Terence Tao 在自己的 blog 以 guest post 轉貼。聲明的重點不是證明對錯,而是程序:OpenAI 在 10 月 6 日一次釋出 700 多個檔案,聲明認為這是展示力量而非學術,並強調沒有數學家要求過這份工作。更早的 9 月 11 日,25 位 Fields 獎得主也聯署過宣言〈A Severe Misalignment of AI in Mathematics〉。
Q: 論文可以量產之後,還需要讀論文嗎?
需要,但順序要改。一個晚上 722 篇手稿,沒有人能逐篇讀證明。比較實際的讀法是先看三樣:被驗證的是哪一句、分母是多少、誰獨立確認過題目出得對。例如 Google DeepMind 的 AlphaProof Nexus 解出 9 道 Erdős 開放問題,分母是 353 道,約 2.5%。這三樣看完,再決定要不要往下讀方法。
來源
- Association for Human Mathematics,AHM Statement on OpenAI’s October 6 Release of Mathematical Documents(Terence Tao blog guest post,2026 年 10 月 7 日)
- Fortune,OpenAI publishes solutions to more than 370 outstanding math challenges
- Bastounis, Circelli, Hansen,Navier-Stokes lost in translation(arXiv 2610.08144)
- Francesco Maggi,2026 年 10 月 10 日貼文
- Tsoukalas et al.,Advancing Mathematics Research with AI-Driven Formal Proof Search(arXiv 2605.22763;Science 版)
- Bartosz Naskręcki,2026 年 10 月 2 日貼文
- Vals AI,Thomson 問題貼文
- Zhong, Raghunathan, Carlini,ImpossibleBench(arXiv 2510.20270)
- The Register,Cursor used agents to write a browser
- Nicholas Carlini,Building a C compiler with a team of parallel Claudes
- Daniel Stenberg,The end of the curl bug bounty
- AlternativeTo,tldraw pauses external contributions
- Epoch AI,SWE-bench Verified benchmark review
- Visual Studio Magazine,GitHub Open Sources Kit for Spec Driven AI Development
- Reuters(Yahoo 轉載),ChatGPT launches boom in AI-written e-books on Amazon
- The Guardian,Sci-fi publisher Clarkesworld halts pitches amid deluge of AI-generated stories
- The Decoder,OpenAI discontinues AI text detector due to lack of accuracy
- Porter, Machery,AI-generated poetry is indistinguishable from human-written poetry and is rated more favorably(Scientific Reports)
- Smithsonian Magazine,This Award-Winning Japanese Novel Was Written Partly by ChatGPT
- TechRepublic,Microsoft CEO Nadella: 20% to 30% of Our Code Was Written by AI
- The Register,Curl project founder snaps over deluge of time-sucking AI slop bug reports
- It’s FOSS,Linus Torvalds Spent Years Dismissing AI, Only to Vouch for It
- DHH,Promoting AI agents
- The Register,Stack Overflow bans ChatGPT
- Google DeepMind,AI achieves silver-medal standard solving International Mathematical Olympiad problems
- TechCrunch,AI benchmarking organization criticized for waiting to disclose funding from OpenAI
- The Decoder,Leading OpenAI researcher announced a GPT-5 math breakthrough that never happened
- 本站:一夜之間,OpenAI 丟出 722 篇數學手稿
- 本站:DeepMind 讓 100 個 agent 開數學會議
- 本站:ATPM: A real production Vibe Coding process