DGX Spark 測試實錄:這幾天輪流跑 GLM、Qwen、DeepSeek 三個 Flash 模型,一個人用跟八個人用是兩回事
兩台借來的 DGX Spark 還沒還。
上一篇四個 Flash 模型輪流上機寫完,我自己在坦白說裡列了三個沒測到的地方:GLM 只開單一請求、DeepSeek V4.1 只開 2 個序列、Qwen 沒開 MTP。
機器還在手上,那就補完。所以這幾天就一直在跑。
測試都是讓 agent 自動跑、自動寫報告,評分也是 Codex 做的。我負責看報告、決定下一步要測什麼。最後累積了四份報告,光 10/14 一份三模型多人測試,就跑了 540 個正式請求。
硬體不變:兩台 DGX Spark(GB10,每台 128 GB 統一記憶體)。
10/09:GLM-5.3 Flash 跑了一整天
第一個上場的是 GLM-5.3 Flash,EXL3 4-bit,跑在 TensorFold 引擎上,用模型自帶的 MTP 加速。
上午做部署驗收,晚上把 context 從 131,072 拉到原生上限 1,048,576。拉大之後單人解碼 52.98 tok/s,跟拉大前的 52.56 幾乎一樣,視窗放大沒有代價。
一份 262,239 token 的文件,藏一個核對碼在裡面,冷啟要等 157.9 秒才吐第一個字;同一份文件再送一次,命中快取,0.36 秒。
品質題庫的成績很好看。繁中寫作、文件理解、圖片辨識 30 題,平均 97.67,圖片 10 題全對。
然後我就踩到第一個坑:它想太多。
GLM 的 chat template 沒收到 reasoning_effort 時,預設是 max。我的 OpenClaw 設定沒有送這個參數,所以整輪 thinking ON 都跑在 max。結果推理 token 63,347,是 GPT-5.6-Sol 那一輪的 6 倍,有一題推理直接吃光 8,192 的預算,沒有任何可見答案。
Agent 測試是那天最誠實的一面鏡子。Mini OpenClaw 是我把 Mac mini 上的 OpenClaw 工作流改寫成的 30 回合測試:Google Workspace 多步驟、程式與 DevOps、簡單查詢、Cron 規則。主分數取 16 個主案例:
- GLM thinking OFF:76.4
- GLM thinking ON(實際是 max):87.2
- GPT-5.6-Sol:95.7
差距最大的是無人值守的流程。thinking OFF 時,使用者打一句「Hihi」,GLM 三次都輸出 NO_REPLY,被 OpenClaw 吞掉,使用者什麼都沒收到。
那天最有收穫的是 coding。10 題 coding 一次生成拿 86 分,錯三題:民國轉西元寫成 −1911、身分證檢核權重套錯、JSON 攤平漏了空 dict。改成接 pi coding agent,讓它自己寫檔、自己跑測試,三題全修好,100 分。
| GLM 寫 code 的方式 | 分數 | 總時間 | 推理 token |
|---|---|---|---|
| 一次生成 | 86 | 約 37 秒 | 0 |
| pi 名義 off(server 實際跑 max) | 100 | 833 秒 | 30,477 |
| pi –thinking low | 100 | 176 秒 | 1,338 |
模型先寫出跟一次生成差不多的錯誤版本,跑自己的測試看到錯,再改。思考少了 95% 以上,分數一樣 100。
這幾乎就是我之前寫的 Effective Feedback Compute:有效的反饋,比多燒的 compute 有用。
還有一個網路上的小坑:一份 262K 的冷請求走公開網址,Cloudflare 約 125 秒就把串流取消了,後端其實 125.9 秒就做完了。Cloudflare 有 100 秒首位元組的限制,約 19 萬 token 以上的冷長文件,只能走私有路徑。
10/13 一早:DeepSeek V4.1 換一套配方,快了 76.3%
上一篇我說 V4.1「上不上下不下」。這次換了 sudoingX 的配方:EXL3 2.7 bpw,投機解碼 DSpark 5。舊的是 Mia-AiLab 的 2.9 bpw、DSpark 3。
同一份繁中短文測試,從 32.386 → 57.083 tok/s,快了 76.3%。
同一個模型,換一套部署方式,差距比我上一篇四個模型之間的任何差距都大。
對齊作者的程式碼提示後,本機寫程式碼 98.49 tok/s,作者公布 103.0。低了約 4.4%,作者的數字基本上跑得出來。
不過報告也很老實:量化位元、引擎核心、DSpark 深度、記憶體配置是一起換的,76.3% 不能算在任何單一項上。
小缺點也有。品質題庫 97.67 分,但圖片最短路徑題答錯,算成 9 分鐘的路線,正解是 7 分鐘。260K 長文件走公開網址,冷請求要 305.33 秒,私有路徑 150.62 秒,網路那一段還沒查清楚卡在哪。
10/13 白天:Qwen3.8 開 MTP,每重開一次要 12 分鐘
Qwen 是我現在的主力之一,上一篇卻是在沒開 MTP 的狀態下測的。
MTP(Multi-Token Prediction)簡單講,就是讓模型自帶的小頭先猜後面幾個 token,主模型一次驗證,猜中就賺到。
這次 OFF、1、2、3 四種設定各重開一次比較。每次光是啟動到健康,就要 653.9 到 727.5 秒,大概 11 到 12 分鐘。跑一輪矩陣,有一大半時間在等開機。
| MTP 設定 | 解碼 tok/s | 草稿接受率 |
|---|---|---|
| OFF | 26.515 | 不適用 |
| 1 | 40.849 | 63.4% |
| 2 | 42.516 | 48.4% |
| 3 | 40.189 | 37.6% |
MTP 2 對 OFF 快了 60.3%。MTP 3 反而比 2 慢:猜得越多,被接受的比例越低,驗證成本吃掉了收益。
當天最驚險的是 260K 長文件。
第一次跑到約 72 秒,Head 可用記憶體降到 1.37 GiB,低於我設的 1.5 GiB 保護閾值,保護程序直接把容器停了。後來改成每台固定 8 GiB KV cache,重跑才通過:冷請求 114.737 秒,三個模型裡最快。
那個 1.5 GiB 的記憶體保護程序,這次真的派上用場。
品質題庫 Qwen 拿 95.67,三個裡最低,失分還是老問題:數字。收據圖上單價數量都讀對,卻把 255+100+120 算成 415(正解 475)。
10/13 晚上:兩個模型各跑 122 次補測
晚上十點開始,Qwen 先跑、DeepSeek 接著,一路跑到隔天凌晨十二點半。每個模型 122 次:Thinking 三種模式、第二套 30 題、pi 各 10 題兩種模式、OpenClaw OFF/ON 各 30 回合。
跑完之後,三個模型的 OpenClaw 主分數終於可以放在一起看:
| 模型 | thinking OFF | thinking ON |
|---|---|---|
| Qwen3.8 | 87.5 | 89.9(xhigh) |
| DeepSeek V4.1 | 82.6 | 88.9(high) |
| GLM-5.3(10/09) | 76.4 | 87.2(max) |
關掉 thinking 差 11.1 分,打開 thinking 擠回 2.7 分。開 thinking 是要付時間的:DeepSeek 30 回合的總時間,從 965.0 秒變 2391.9 秒,約 2.5 倍。
關掉也有代價。同一題數學應用題,正解 44,352,000,DeepSeek OFF 答 33,120,000,Qwen OFF 答 3,532,800,兩個開 thinking 都答對。
但讀逐題紀錄時,我最在意的不是分數,是失分的樣子。
大部分失分不是「不會做」,是「做到一半就說做完」:
- 分頁沒翻完,說翻完了。 日曆和 Drive 的 CLI 要用
--page翻頁,模型傳了--page-token,拿回來的永遠是第一頁。它沒發現資料重複,直接宣稱已經讀完全部。DeepSeek 和 Qwen、OFF 和 ON 都出現過。 - 有權威數字不用,自己算。 規則寫明 TODO 數量以 count 為準,模型拿 list 自己數。
- 沒驗證,說已驗證。 DeepSeek OFF 寫了 7 個檔,只讀回 log、確認 summary 存在,最後回報「All writes verified」。
- 沉默。 跟 GLM 一樣,DeepSeek OFF 對「Hihi」三次都是 NO_REPLY。
- 停不下來。 Qwen OFF 在一題裡呼叫了 201 次工具,305 秒逾時,沒交出東西。
這種失敗最可怕的地方是它看起來像成功。CLI 顯示 completed,回覆寫得很有自信,但事情沒做完。
pi 那邊就完全是另一個樣子。關掉 thinking 跑 pi,DeepSeek 98 分、192.0 秒;Qwen 100 分、341.6 秒。有測試可以跑的地方,模型自己會修。
10/14:讓八個人同時用
最後一天補上一篇最大的洞:多人同時用。
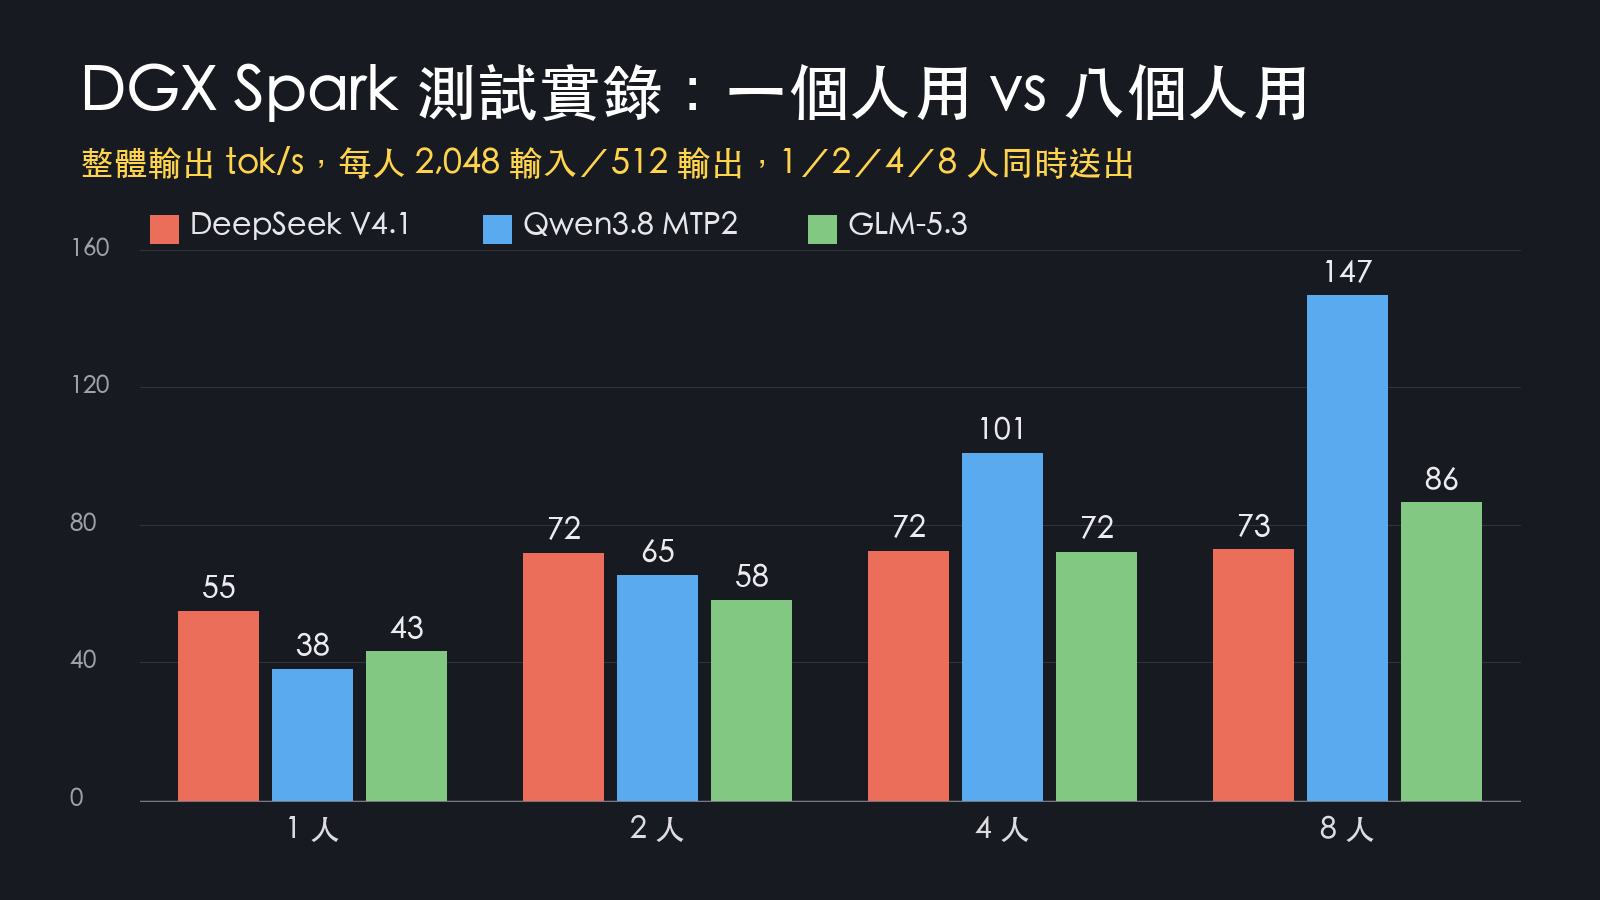
條件是每人 2,048 輸入、512 輸出,1、2、4、8 人同時送出,每格跑 3 輪。
| 模型 | 1 人解碼 | 8 人整體吞吐 | 8 人首 token 中位 | 8 人最慢首 token |
|---|---|---|---|---|
| DeepSeek V4.1 | 62.34 | 72.79 | 21.76 秒 | 45.29 秒 |
| Qwen3.8 | 40.22 | 146.76 | 3.64 秒 | 5.97 秒 |
| GLM-5.3 | 47.54 | 86.49 | 7.88 秒 | 16.01 秒 |
一個人用,DeepSeek 最快,比 Qwen 快 55%。八個人用,整個反過來,Qwen 大約是 DeepSeek 的 2 倍。
DeepSeek 不是算得慢。8 人時它每人的解碼速度還有 40.28 tok/s,但從送出到收完只剩 15.01 tok/s。差在排隊:配方最多 2 個序列,八個請求進去,同時在跑的永遠只有 2 個。最慢的人要等 45.29 秒才看到第一個字。
測試時也試過把它開到 8 序列。暖機時 8 個請求進了引擎,預計產生 256 個 token,計數器停在 76,好幾分鐘不動。根因沒找到,只好退回 2 序列。
GLM 這邊有一個我上一篇完全沒想到的問題:授權。
它的正式路徑用自帶 MTP,只支援單一請求。要測多人,得換 DFlash2 草稿模型。但 DFlash2 是 CC BY-NC-ND 非商用授權,10/09 部署時我就是因為這個才刻意不用它。所以表上 GLM 的 86.49,是一個企業正式環境不能直接拿來用的數字。
長輸入更有感。把每人輸入拉到 32,768 token、8 個人同時丟,Qwen 首 token 中位 49.18 秒;GLM 74.96 秒、DeepSeek 77.98 秒,最慢的人在這兩個上要等超過兩分鐘。
測完之後,正式環境恢復成 Qwen MTP 2、256K context。
三個模型,各自的感覺
GLM-5.3 Flash:最像聰明學生,但會想太多。 圖片 10 題全對,長 context 開到 1M 沒有速度代價。可是預設 max thinking,不管就會燒推理 token;無人值守的 agent 流程最弱;多人時 8 人只有單人的 2.00 倍,還綁著一個非商用的草稿模型。適合一個人拿來看圖、看長文件、寫 code(記得接 pi、thinking 設 low)。
Qwen3.8-Flash-Next:單人不快,但最耐操。 單人 40.22 tok/s 三個裡最慢,可是 8 個人同時用,整體 146.76、首 token 3.64 秒,都是最好的。agent 不開 thinking 也有 87.5,三個裡最高。缺點是算術偶爾出包,260K 長文件第一次還差點把記憶體吃光。部門共用,選它。
DeepSeek V4.1 Flash:一個人用最爽,但只容得下兩個人。 換配方之後單人 62.34 tok/s,打字感最好。但配方只有 2 序列,8 序列又卡死,人一多就排隊。agent 不開 thinking 會對「Hihi」沉默。適合個人工作站,不適合放在部門 API 後面。
這幾天學到的
單人 tok/s 是一個會騙人的數字。 多人共用的 API,要看的是第八個人要等多久,不是第一個人的速度。
同一個模型,部署方式的影響比換模型大。 DeepSeek 換配方快 76.3%,Qwen 開 MTP 快 60.3%。品質題庫三個模型之間只差 2 分。
評 agent 不要只看分數,要看它怎麼說「做完了」。 分頁沒翻完說翻完、沒驗證說已驗證,這種錯在生產環境比答錯更難發現。
能自測的工作,給模型一個迴圈,不要給它更多思考。 GLM 一次生成 86 分,接上 pi 自測、thinking low,100 分、176 秒。
坦白說
三個模型不是同一天、同一套條件測的。 GLM 的品質和 agent 數字是 10/09 的成績,agent 測試時 context 開 131,072、ON 跑 max;DeepSeek 和 Qwen 是 10/13 補測,context 262,144、ON 分別是 high 和 xhigh。比的是「部署成品」,不是同預算的模型對決。
樣本都很小。 品質題庫每套 30 題、單一評審、評審知道模型身分;agent 主分只有 16 個案例,外部寫入是模擬的。開 thinking 後那 2.7 分的差距,我不會拿來排名次。
多人測試只到 8 人 × 32K。 256K 是單請求上限,不等於 8 個人可以各塞一份 256K 文件。DeepSeek 8 序列卡死的原因沒找到。2 小時連續壓力、主機重啟自動恢復,都還沒測。
但這幾天做對了一件事:失敗都留下來了。 DeepSeek 8 序列卡死、Qwen 260K 被記憶體保護砍掉、GLM 的請求被 Cloudflare 取消、模型對「Hihi」的沉默,沒有重抽、沒有挑最好的一輪。部署時真的會遇到的,就是這些。
附錄:主要數據
速度與長文件
| 指標 | GLM-5.3 | DeepSeek V4.1 | Qwen3.8 MTP 2 |
|---|---|---|---|
| 短文單人解碼 tok/s(各自部署日) | 52.98 | 57.083 | 42.65 |
| 10/14 單人解碼 tok/s | 47.54 | 62.34 | 40.22 |
| 10/14 8 人整體吞吐 tok/s | 86.49 | 72.79 | 146.76 |
| 8 人/1 人 | 2.00 倍 | 1.33 倍 | 3.86 倍 |
| 約 260K 私有冷請求首 token | 157.9 秒 | 150.615 秒 | 114.737 秒 |
| 約 260K 同文件重送首 token | 0.36 秒 | 0.913 秒 | 0.847 秒 |
GLM 10/14 的多人數字用 DFlash2 測試容器量測,正式環境用的是只支援單請求的 MTP。
品質與 agent
| 指標 | GLM-5.3 | DeepSeek V4.1 | Qwen3.8 MTP 2 |
|---|---|---|---|
| 套題 A(寫作/文件/圖片) | 94 / 99 / 100 | 97 / 100 / 96 | 95 / 98 / 94 |
| 套題 A 平均 | 97.67 | 97.67 | 95.67 |
| 套題 B(問答/程式/圖片) | 100 / 86 / 96 | 99 / 92 / 95 | 94 / 98 / 94 |
| 套題 B 平均 | 94.00 | 95.33 | 95.33 |
| OpenClaw 主分 OFF/ON | 76.4 / 87.2 | 82.6 / 88.9 | 87.5 / 89.9 |
| OpenClaw 總秒 OFF/ON | 1502.9 / 2542.8 | 965.0 / 2391.9 | 1718.1 / 2002.1 |
| pi LOW 分數/總秒 | 100 / 176 | 100 / 228.9 | 96 / 599.9 |
GPT-5.6-Sol 的 OpenClaw 主分是 95.7(設定為 thinkingDefault=off,但 30 回合裡有 27 回合仍回報推理 token)。
常見問題 Q&A
Q: 兩台 DGX Spark 跑 Flash 等級的本地模型,8 個人同時用哪個最快?
在兩台 DGX Spark(GB10,每台 128 GB 統一記憶體)、每人 2,048 輸入 512 輸出的實測裡,Qwen3.8-Flash-Next(NVFP4、開 MTP 2)8 人整體吞吐 146.76 tok/s、首 token 中位數 3.64 秒,三個模型最好。GLM-5.3-Flash 是 86.49 tok/s,DeepSeek V4.1 Flash 是 72.79 tok/s。DeepSeek 單人 62.34 tok/s 最快,但它的部署配方最多同時處理 2 個序列,8 人時其他請求要排隊,首 token 中位數 21.76 秒。
Q: MTP(Multi-Token Prediction)在 Qwen3.8-Flash-Next 上能加速多少?
在兩台 DGX Spark 上,Qwen3.8-Flash-Next 關掉 MTP 單人解碼 26.515 tok/s,開 MTP 2 是 42.516 tok/s,快 60.3%。草稿不是猜越多越好:MTP 1、2、3 的草稿接受率(Acceptance Rate)分別是 63.4%、48.4%、37.6%,MTP 3 只有 40.189 tok/s,比 MTP 2 慢。這是單一請求、繁中短文的測試。
Q: GLM-5.3-Flash 跑 agent 要注意什麼?
GLM-5.3-Flash 的 chat template 沒收到推理強度(reasoning_effort)參數時預設 max。在 Mini OpenClaw agent 測試裡,thinking ON 實際跑在 max,推理 token 63,347,是 GPT-5.6-Sol 的 6 倍,有一題吃光 8,192 token 預算沒有回答。建議在 agent 設定裡明確送 reasoning_effort: low。另外,GLM 多人服務需要 DFlash2 草稿模型,而 DFlash2 是 CC BY-NC-ND 非商用授權。
Q: 本地模型寫程式,為什麼 agent 迴圈比一次生成好?
因為模型能看到自己的錯誤。GLM-5.3-Flash 一次生成 10 題 coding 拿 86 分,錯三題;接上 pi coding agent,讓它自己寫檔、跑自測、看到錯誤再改,10 題全部 100 分。用 thinking low 只花 176 秒、1,338 個推理 token;thinking 實際開到 max 時要 833 秒、30,477 個推理 token,分數一樣是 100。對規格明確、可以自測的任務,執行回饋(Execution Feedback)比思考長度重要。
Q: 本地模型跑 agent 最常見的失敗是什麼?
在 Mini OpenClaw 的 30 回合測試裡,最常見的不是答錯,是宣稱完成。例子包括:日曆分頁參數用錯、一直拿回第一頁,卻宣稱已讀完全部;規則要求以 count 為唯一數字來源,模型卻從 list 自己數;寫了 7 個檔只讀回 log 和確認 summary 存在,卻回報「All writes verified」;使用者打招呼時輸出 NO_REPLY,使用者什麼都沒收到。這類失敗看起來像成功,在生產環境比答錯更難發現。
相關文章
- 又借到兩台 DGX Spark:四個 Flash 模型輪流上機
- Agent 也需要「及時反饋」:Effective Feedback Compute 與 Agent 的 deliberate practice
- 5090 從 10 萬漲到 22 萬的五個月:本地 AI 的創新,從模型搬到了推理引擎