又借到兩台 DGX Spark:四個 Flash 模型輪流上機,品質全擠在 2 分內,速度差到 70%
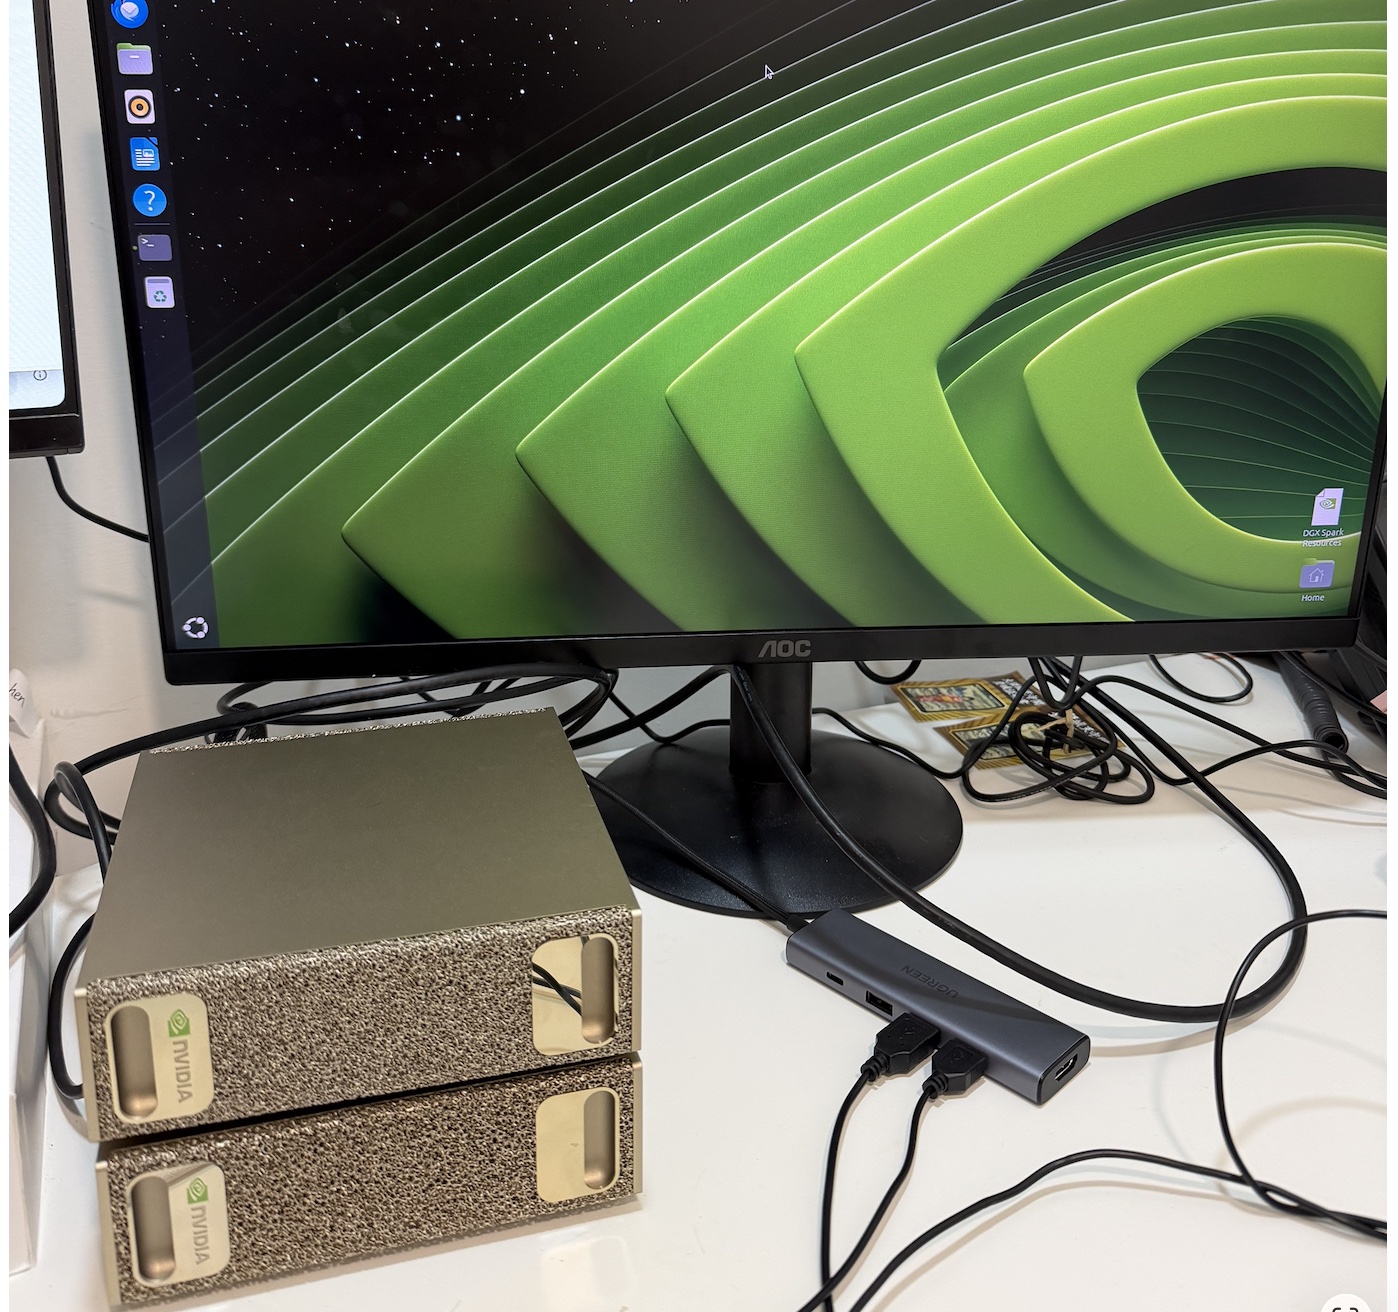
感謝朋友大德,雙十節借我玩具,借到兩台 DGX Spark。
這次不跑一個模型就收工。我用同一套測試腳本,把手上關注的四個 Flash 模型輪流部署上去:DeepSeek V4 Flash、DeepSeek V4.1 Flash、Qwen3.8-Flash-Next,還有 GLM-5.3-Flash。
四個都叫 Flash,都是 MoE,都放得進兩台 Spark。但實際跑完,它們在這兩台機器上的角色完全不一樣。
30 秒定位
| 模型 | 總參數 | 每個 token 激活 | AA 智力指數 v4.3.2 | 我的 30 題評測 | 我這次的部署 |
|---|---|---|---|---|---|
| DeepSeek V4 Flash(0731 系) | 284B | 13B | 34 | 97.3 | Vision-Exp 版,官方 FP4/FP8 混合權重,vLLM |
| DeepSeek V4.1 Flash | 552B | prefill 8B / decode 16B | 39 | 97.7 | Mia-AiLab 的 EXL3 2.9-bit,vLLM |
| Qwen3.8-Flash-Next | 125B | 6B | 40 | 95.7 | NVIDIA 的 NVFP4,vLLM,沒開 MTP |
| GLM-5.3-Flash | 320B | 18B | 42 | 97.7 | EXL3 4-bit,TensorFold,原生 MTP |
硬體是兩台 DGX Spark,每台 GB10、128GB 統一記憶體,兩條 QSFP 直連,RDMA 合計實測 196.06 Gb/s。
速度測試條件統一:每個請求固定輸入 2,048、輸出 512 token,temperature 0,關 thinking,每級跑 3 輪取中位數。測試日期 10 月 8 日到 9 日。
AA 指數要先講一件事:AA 從 v4.1.1 改版到 v4.3.2,題目換了,新舊分數不能直接比。網路上還流傳很多舊版的 50 幾分,這篇一律用新版。
一、DeepSeek V4 Flash 0731:斬殺線的來源
這個模型對我意義特別。
8 月寫北京 AGI Bar 免費請你用 DeepSeek V4 Flash 的時候,它在 AA v4.1 拿約 50 分,每題成本又低到幾乎沒有對手,畫出了那條「斬殺線」。北京那家酒吧在店裡放 DGX Spark 免費送 token,送的就是它。
規格是 284B 參數、每個 token 激活 13B,7 月 31 日發布。這次我跑的是 DeepSeek-V4-Flash-Vision-Exp,也就是 0731 文字模型加上視覺模組的實驗版(305B),官方 FP4/FP8 混合權重。
它落後新一代大概兩個月。GLM-5.3-Flash 8 月、Qwen3.8-Flash-Next 8 月 26 日、V4.1 Flash 9 月,三個都比它晚。AA 智力指數 v4.3.2 上它是 34 分,另外三個都在 39 到 42。8 月那條斬殺線,現在已經有三個後來的 Flash 站在它上面。
但在我的繁中評測裡,它拿 97.3,跟第一名只差一點點。
落後兩個月,但在一般商務任務上,它還是那個神級 Flash 模型。 我還是很喜歡它。
二、DeepSeek V4.1 Flash:升級了,但上不上下不下
V4.1 是能力升級版。AA 從 34 分升到 39 分(max)。
代價是總參數將近翻倍(284B → 552B)。架構也改了:prefill 每個 token 激活 8B、decode 激活 16B,MIT 授權。
這個體量很尷尬。0731 已經能在兩台 Spark 上跑原廠權重;V4.1 要放進同樣兩台,我得用 Mia-AiLab 的 EXL3 2.9-bit 量化,vLLM 最多同時 2 個請求,4 人、8 人沒測。
結果在我的評測裡,V4.1 平均 97.7,0731 系 97.3。測試紀錄裡我自己的判斷是:這個差距不足以證明 V4.1 全面較好。
所以說它上不上下不下:參數翻倍、量化壓得更狠、併發上限更低,換到的是在我的題目上幾乎看不出來的差距。
它真正的位置可能在別的地方。官方的 code agent 分數(Terminal-Bench、DeepSWE v1.1、NL2Repo-Bench、ProgramBench)都是用 DeepSeek Harness 的 Minimal 模式、1M context 跑的。V4.1 的強項,是在 DeepSeek 自家 harness 裡被調出來的。 如果你的工作流就是跑 DeepSeek Harness,它大概是最好的適配;我這次測的是單輪問答,沒測到這一塊。
長上下文有過一關:59,999 token 的文件,中段藏一個值,58.24 秒找回來。
三、Qwen3.8-Flash-Next:同級最快,參數只有別人的零頭
這是我現在的主力模型之一。
它是被 Strata 帶紅的。Strata 把它跑在 RTX 5090 上,一張遊戲卡加 64GB RAM 就開到 1M context,我才認真開始用。現在它跟 Qwen3.8-27B 堪稱我的左右護法。
規格是 125B 參數、每個 token 只激活 6B(另掛 51B 的 n-gram embedding 表和 4B 的 MTP 模組,AA 把全部加起來列 180B)。總參數是另外三個的 1/2 到 1/4。
AA 拿 40 分,比體量大得多的 V4.1 還高 1 分。
速度才是它真正的武器。下面是兩台 Spark 上的併發實測(GLM 這次只開單一請求,所以只有 1 人那列):
| 同時人數 | Qwen 每人 (tok/s) | Qwen 總輸出 | V4 每人 | V4 總輸出 | V4.1 每人 | V4.1 總輸出 | GLM 每人 |
|---|---|---|---|---|---|---|---|
| 1 | 32.08 | 30.79 | 28.37 | 26.55 | 31.76 | 27.88 | 52.56 |
| 2 | 28.98 | 54.94 | 22.30 | 39.58 | 23.49 | 39.90 | 沒測 |
| 4 | 24.53 | 89.09 | 15.48 | 53.54 | 沒測 | 沒測 | 沒測 |
| 8 | 18.88 | 134.57 | 11.50 | 78.80 | 沒測 | 沒測 | 沒測 |
| 同時人數 | Qwen 首字(秒) | V4 首字 | V4.1 首字 | GLM 首字 |
|---|---|---|---|---|
| 1 | 0.603 | 1.270 | 2.279 | 1.126 |
| 2 | 0.929 | 1.916 | 3.386 | 沒測 |
| 4 | 2.077 | 3.646 | 沒測 | 沒測 |
| 8 | 3.238 | 5.605 | 沒測 | 沒測 |
人一多就拉開了:8 人同時用,Qwen 總輸出比 V4 高 70.8%。首字時間也是 Qwen 最短。
這就是標題說的「速度差到 70%」。品質只差幾分,但企業地端是多人共用一個 API,這個差距每天都會被感受到。
它的弱點也很具體。評測裡它平均 95.7,四個裡最低,失分集中在數字。最典型的一題:收據圖上單價數量都讀對,卻把 255+100+120 算成 415(正解 475)。
四、GLM-5.3-Flash:這體量裡最聰明的那個
GLM-5.3-Flash 是 320B 參數、每個 token 激活 18B,1M context。
AA 智力指數 v4.3.2 上它拿 42 分,跟 GPT-5.6 Terra (Max)、Claude Opus 4.8 (Max) 同分。三個的每題成本是:GLM-5.3-Flash $0.25、GPT-5.6 Terra (Max) $1.40、Claude Opus 4.8 (Max) $4.08。
一個開源、兩台 Spark 放得下的 Flash 模型,綜合智力跟幾個月前的旗艦商用模型同級。這是四個裡面最高的 AA 分數。
我這次部署的是 GLM-5.3-Flash EXL3 4-bit(專家 4bpw),TensorFold,原生 MTP,context 開 128K,只開單一請求。權重 175.72 GB。
自己測下來,三件事最明顯。
第一,品質跟 V4.1 並列第一,圖片題全對。 寫作 94、文件 99、圖片 100,平均 97.7,跟 V4.1 同分。10 題圖片全對,包括 Qwen 算錯的收據、V4.1 漏掉的封路路線。前面三個模型在圖片題都有失分,GLM 是唯一一題都沒錯的。
第二,單人速度四個裡最快。 單人 decode 52.56 tok/s,首字 1.126 秒。另外三個單人都在 28 到 32 tok/s,GLM 快 64% 到 85%。激活參數最多的模型反而最快,原因後面講。
第三,長文件順。 60,000 token 的文件找回唯一核對碼,32.77 秒。V4.1 做同樣規模的題目花了 58.24 秒,不過兩者的引擎不同,這個比較只能參考。
它的毛病是格式。9 項功能檢查過 8 項,失敗那題:題目要求只能回「資料不足」,它判斷對了,卻輸出一大段 Markdown 說明。寫作題 4 題扣分,有 2 題跟超字數有關。
這跟社群的觀察一致。X 上大家講 GLM 最多的是長上下文,在 DGX Spark 社群常用的 Spark-Bench 上,最新版 GLM 84.8、Qwen 79.4(vLLM)/ 77.9(TensorFold),長上下文那項是 70.8 對 21.6–27.9;同時作者也說 Qwen 照格式比較精準。
但同一個 bench 8 月底的上一版,結果相反:Qwen 87.02、GLM 85.67。原因之一是 GLM 有 4 份回答陷入重複,一路吐到 26 萬 token 撞上 context 上限,全部判 0 分。那一輪 GLM 整輪輸出 1,207,779 token,Qwen 是 111,726。
我的 30 題把 max_tokens 設在 1,500,30 題全部正常結束,沒有截斷。所以「停不下來」這件事,我的測試設定剛好測不到,還要另外驗。
評測:四個模型全擠在 2 分內
速度之外,我也跑了一套繁中品質評測:繁中寫作、文件理解、圖片辨識各 10 題,共 30 題,Codex 出題兼評審。前三個模型是匿名混排、分數鎖定後才揭盲;GLM 是後來加測的,評審知道是哪個模型,不算盲評。
| 部署版本 | 寫作 | 文件 | 圖片 | 平均 |
|---|---|---|---|---|
| GLM-5.3-Flash EXL3 4-bit | 94 | 99 | 100 | 97.7 |
| DeepSeek V4.1 EXL3 2.9-bit | 95 | 100 | 98 | 97.7 |
| DeepSeek V4(0731 系 Vision-Exp) | 95 | 100 | 97 | 97.3 |
| Qwen NVFP4 | 93 | 98 | 96 | 95.7 |
四個都能做一般商務寫作和文件理解。差距幾乎都來自數字和多步驟條件:Qwen 加法算錯,V4.1 路線題漏掉一條 9 分鐘的路,GLM 則散在字數和措辭。
這跟 AA 的排序不完全一樣。AA 上 Qwen 40 分略高於 V4.1 的 39 分,我的繁中題目是 DeepSeek 領先。兩邊差距都很小,各自的題目又不同,我不會拿這 2 分當結論。
反方:模型的差距,可能小於部署的差距
寫到這裡,有一個反駁我必須正面處理:排這四個模型的名次,可能根本排錯了對象。
最直接的證據就在我自己的表上。GLM 每個 token 激活 18B,是四個裡最多的,照理應該最慢;結果單人 52.56 tok/s,四個裡最快。差別在引擎:GLM 跑的是 TensorFold 加原生 MTP,另外三個都是 vLLM。
社群自報的數字也是同一個方向:
- 同一個 GLM-5.3-Flash,EXL3 4bpw 拿 90.9,NVFP4 拿 78.5。只換量化,差 12 分以上,比四個模型之間的 AA 差距還大。
- 同一份 EXL3 2.9-bit 的 V4.1 權重,換成 TensorFold 引擎:sfxnz 一般文字 56 對 48 tok/s;mmeding 寫 code 83.0 對 42.4 tok/s。
對照我自己 V4.1 在 vLLM 上單人 31.76 tok/s,引擎很可能才是瓶頸。
這呼應了我前幾天寫的本地 AI 的創新從模型搬到了推理引擎。那篇講的是 Strata 讓 125B 的 MoE 跑上遊戲卡,這次在 DGX Spark 上看到同樣的事:權重沒換,換一個引擎,寫 code 的速度快將近 2 倍。
我的回應是:這個反駁成立,所以這篇排的不是「誰最聰明」,是「誰適合什麼工作型態」。速度的絕對數字會隨引擎改變,但結構性差異不會:Qwen 6B 激活量的併發優勢、GLM 的長上下文和圖表推理、V4.1 對自家 harness 的適配,是模型本身決定的。
坦白說
這次的數據有幾個要扣分的地方。
四個模型的部署條件不一樣。 V4 是官方 FP4/FP8 混合,V4.1 是 EXL3 2.9-bit,Qwen 是 NVFP4 沒開 MTP,GLM 是 EXL3 4-bit 跑 TensorFold。量化方式、引擎、speculative decoding 都不同,所以速度表比的是「兩台 Spark 上的實際使用體驗」,不能把差距全算在模型頭上。GLM 單人最快,有很大一部分是引擎的功勞。
併發數據缺兩塊。 V4.1 只開了 2 個併發,GLM 只開單一請求。多人共用時 GLM 會怎樣,我現在完全不知道;這恰好是企業部署最在意的那一欄。
評測只有一個評審、每題跑一次,沒有統計檢定,而且 GLM 不是盲評。 文件題接近滿分,區辨力有限;圖片題是合成的單據和圖表,不含自然照片。GLM 和 V4.1 同分 97.7,不代表兩者真的一樣強,2 分的差距也不代表繁中寫作有穩定差距。
V4.1 的「最佳適配 DeepSeek Harness」是推論,不是實測。 依據只有官方模型卡寫的評測方式,我沒有在 harness 裡跑過任何一題。
但這次做對了一件事:同一套腳本、同一台機器、同一份題目,四個模型輪流上。 公開 benchmark 沒有一個是在兩台 DGX Spark、繁中題目、多人併發這個組合下測的,這份數據是自己的工作型態才有的。
關鍵洞察
多人共用的地端 API,先看併發,不是看品質分數。 品質差 2 分你很難感覺到,8 人同時用總輸出差 70.8% 每天都在感覺。這也是 Qwen3.8-Flash-Next 現在是我主力之一的原因。
圖表、單據、長文件,GLM 是這次最穩的。 10 題圖片全對,60,000 token 的文件 32.77 秒找回答案。但如果你要它嚴格照格式回答,要另外加檢查。
V4.1 值不值得多佔資源,看你用不用 DeepSeek Harness。 單輪問答它跟 0731 幾乎並列;它的官方分數是在自家 harness 裡跑出來的。
換模型之前,先試換引擎。 激活參數最多的 GLM 在 TensorFold 上單人最快;同一份 V4.1 權重換到 TensorFold,社群回報快 17% 到將近 2 倍。在兩台 Spark 這種固定硬體上,引擎和量化的選擇,很可能比換一個模型影響更大。
常見問題 Q&A
Q: 兩台 DGX Spark 可以跑哪些 Flash 等級的開源模型?
兩台 DGX Spark(每台 GB10、128GB 統一記憶體)可以跑 DeepSeek V4 Flash(284B 參數)、DeepSeek V4.1 Flash(552B)、Qwen3.8-Flash-Next(125B)和 GLM-5.3-Flash(320B)。V4 Flash 能直接跑官方 FP4/FP8 混合權重;V4.1 Flash 體量將近翻倍,實測要用 EXL3 2.9-bit 量化(Quantization)才放得進去,而且併發上限只開到 2 個請求;GLM-5.3-Flash 用 EXL3 4-bit,權重 175.72 GB。
Q: Qwen3.8-Flash-Next 為什麼在 DGX Spark 上多人使用時最快?
主因是激活參數少:Qwen3.8-Flash-Next 是 MoE(Mixture of Experts)架構,每個 token 只激活 6B 參數,DeepSeek V4 Flash 激活 13B。在兩台 DGX Spark、每請求 2,048 輸入 512 輸出的測試裡,8 人同時使用時 Qwen 總輸出 134.57 tok/s,DeepSeek V4 是 78.80 tok/s,高 70.8%。不過兩者的量化與推理引擎設定不同,差距不能全部算在模型本身。
Q: GLM-5.3-Flash 的智力相當於哪個商用模型?
在 Artificial Analysis 智力指數(Intelligence Index)v4.3.2 上,GLM-5.3-Flash 拿 42 分,跟 GPT-5.6 Terra (Max) 和 Claude Opus 4.8 (Max) 同分,每題成本分別是 $0.25、$1.40、$4.08。在兩台 DGX Spark 的 30 題繁中評測裡,GLM-5.3-Flash 平均 97.7,跟 DeepSeek V4.1 Flash 同分第一,10 題圖片題全對。要注意 AA 從 v4.1.1 改版到 v4.3.2 後題目換了,網路上流傳的舊版 50 幾分不能拿來跟新版比。
Q: DeepSeek V4.1 Flash 值得從 V4 Flash 升級嗎?
看工作型態。在 30 題繁中評測(寫作、文件理解、圖片辨識)裡,V4.1 Flash 平均 97.7、V4 Flash 系 97.3,幾乎並列;但 V4.1 總參數從 284B 增加到 552B,在兩台 DGX Spark 上得壓到 EXL3 2.9-bit、只能同時處理 2 個請求。V4.1 官方的 code agent 分數是用 DeepSeek Harness 的 Minimal 模式跑出來的,如果你的工作流就在 DeepSeek Harness 裡,升級比較有意義。
Q: 在 DGX Spark 上,換推理引擎(Inference Engine)會差多少?
差距可能比換模型還大。在兩台 DGX Spark 上,每個 token 激活 18B 的 GLM-5.3-Flash 跑 TensorFold 加原生 MTP(Multi-Token Prediction),單人 52.56 tok/s;激活參數更少的 DeepSeek 和 Qwen 跑 vLLM,單人都在 28 到 32 tok/s。社群也回報,同一份 DeepSeek V4.1 Flash EXL3 2.9-bit 權重從 vLLM 換到 TensorFold,寫 code 從 42.4 提升到 83.0 tok/s。量化格式也一樣:同一個 GLM-5.3-Flash,EXL3 4bpw 在 Spark-Bench 拿 90.9 分,NVFP4 只拿 78.5 分。
來源
- Artificial Analysis:GLM-5.3-Flash
- Artificial Analysis:GPT-5.6 Terra (Max) vs GLM-5.3-Flash
- Artificial Analysis:Claude Opus 4.8 (Max) vs GLM-5.3-Flash
- Artificial Analysis:DeepSeek V4.1 Flash vs GLM-5.3-Flash
- Artificial Analysis:Qwen3.8-Flash-Next
- Artificial Analysis:DeepSeek V4 Flash 0731
- DeepSeek-V4.1-Flash 模型卡(Hugging Face)
- DeepSeek V4-Flash-Vision-Exp 發布
- Spark-Bench(Weschera/spark-bench)
- Wësche:GLM-5.3-Flash vs Qwen3.8 Flash-Next(X)
- Wësche:GLM-5.3-Flash EXL3 vs NVFP4(X)
- sfxnz:DeepSeek-V4.1-Flash TensorFold vs vLLM(X)
- mmeding:DeepSeek-V4.1-Flash TensorFold 實測(X)