5090 從 10 萬漲到 22 萬的五個月:本地 AI 的創新,從模型搬到了推理引擎
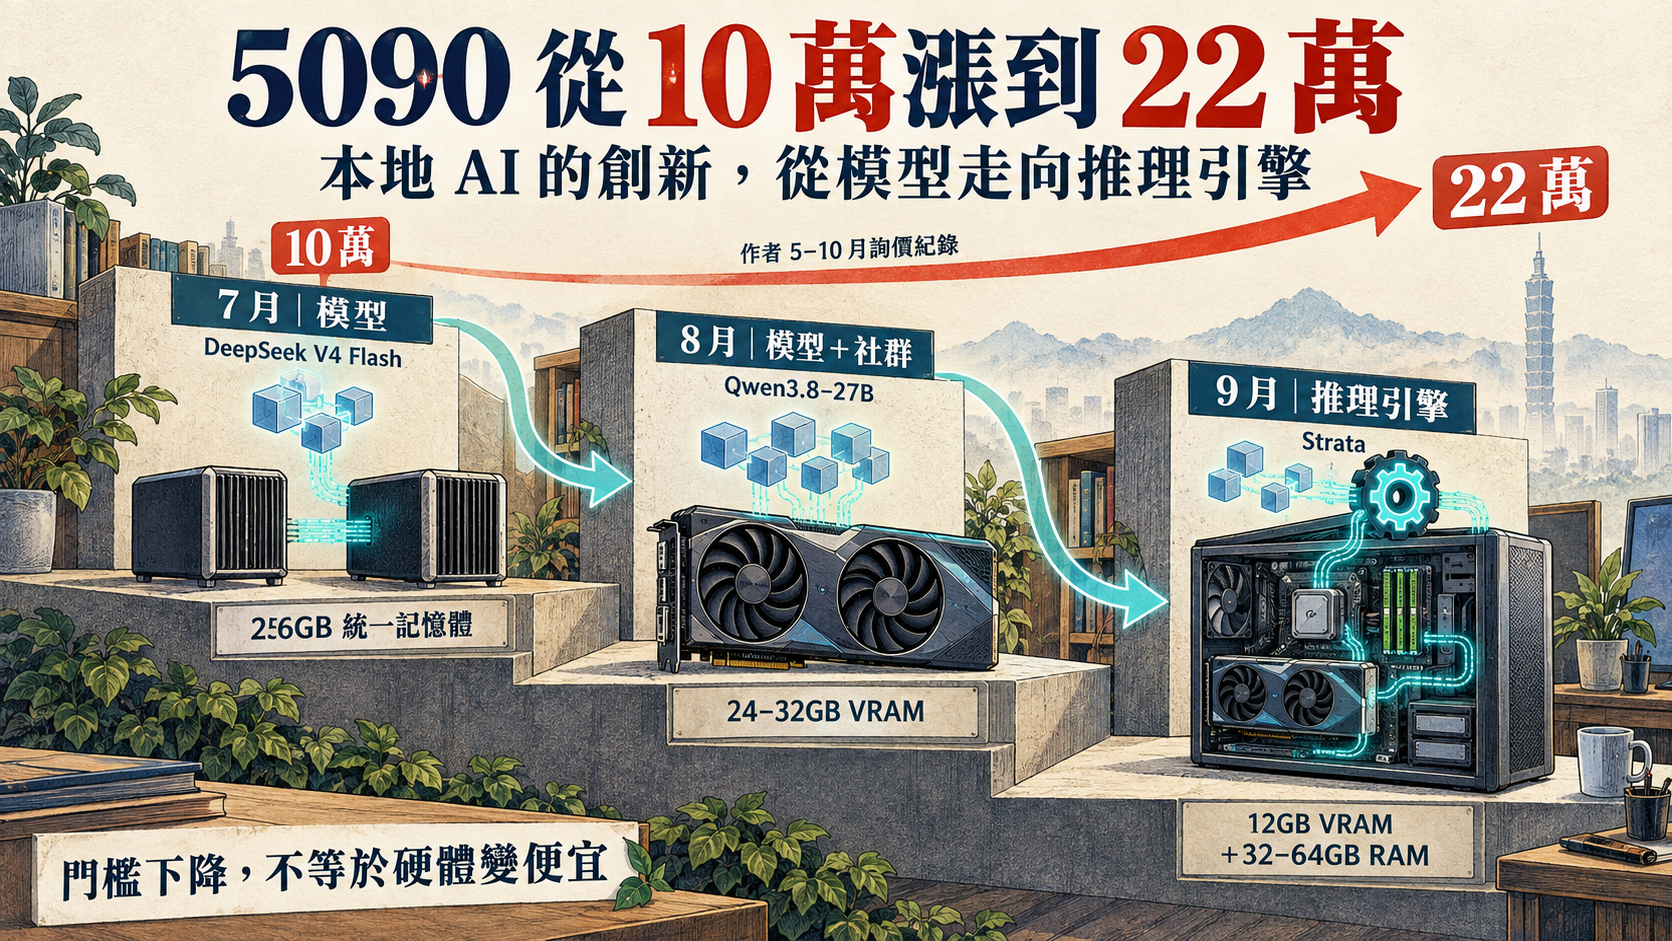
10 月 1 日我查了原價屋,RTX 5090 報價 22 萬。而且暫時買不到,要先跟店家申請。
同一張卡,我自己問到的價格是這樣走的:5 月 10 萬、7 月 12 萬、8 月 17 萬。
五個月,2.2 倍。
最近簡體中文社群流傳一則貼文,標題是「本地 AI 將會把消費級硬體推入全面大漲價時代」,把七月到九月的本地 AI 進展排成一條時間線。我把這條時間線跟自己的報價單疊在一起看,發現一件比漲價更值得記的事:這三個月,創新發生的那一層一直在往下搬。
30 秒定位
| 月份 | 創新在哪一層 | 代表 | 誰做的 | 被拉進「有生產力」的硬體 |
|---|---|---|---|---|
| 7 月 | 模型 | DeepSeek V4 Flash 0731 | 一家實驗室 | 兩台 DGX Spark,256GB 統一記憶體 |
| 8 月 | 模型,加上社群魔改 | Qwen3.8-27B | 一家實驗室加一群人 | 24 到 32GB 顯卡,魔改後 12GB |
| 9 月 | 推理引擎 | Strata | 一個人 | 12GB 顯卡加 32 到 64GB RAM |
七月:創新在模型,兩台小盒子拿到專業級的 token
七月的主角是 DeepSeek V4 Flash 0731。7 月 31 日發布,是 4 月 Preview 版重新 post-train 之後的正式版,MIT 授權,權重開放。
先看分數。Artificial Analysis 的 Intelligence Index(II)上,它落在 49.9 分、每任務 0.027 美元的位置。那張圖上有 128 個模型,比它貴又比它笨的全部落進中文圈說的「斬殺區」,大多數模型都在裡面。分數擠到第一梯隊門口,價格停在最便宜的一檔。
這個位置不是靠堆參數站上去的。我八月拆過,V4 Flash 的創新有三個,每一個都剛好對到本地硬體的一個痛點:
| 模型的創新 | 數字 | 對本地硬體的意義 |
|---|---|---|
| 低激活比例的 MoE | 284B 總參數,每個 token 只激活 13B | 記憶體要夠放 284B,但每個 token 的運算量只有 13B 的份。容量大、算力普通的機器剛好吃這一型 |
| CSA + HCA 雙 attention | KV Cache 降到上一代 V3.2 的 7%,推理計算量降到 10% | 長 context 最吃記憶體的是 KV Cache。它縮小之後,1M context 才不會把記憶體吃光 |
| 兩年的 KV 壓縮路線 | 從兩年前 MLA 把 KV 壓小 93% 開始,一路做到 V4 | 這不是單次的技巧,是整條架構路線都在替記憶體省空間 |
CSA(Compressed Sparse Attention)負責抓重點,HCA(Heavily Compressed Attention)負責看全域,四月那篇有完整拆解。
三個創新指向同一個結果:這個模型要的是記憶體容量,不是頂級算力。 所以它不需要機房。
一台 DGX Spark 有 128GB 統一記憶體,一台 4,699 美元。單台跑 V4 Flash 要壓到 Q2 量化,15 到 20 t/s。兩台接起來 256GB,可以跑 FP8,41 t/s。V2EX 上有人貼出兩台 Spark 跑 0731 版的部署紀錄,單流 60 到 70 tok/s。
8 月 3 日,北京的 AGI Bar 開始對店內客人免費提供無限量的 V4 Flash token,推理全在店裡的 DGX Spark 上跑。一家酒吧,兩台小盒子,供應一個專業級模型。
然後硬體價格跟上來了。同一則 V2EX 帖子記錄了京東上雙機的價格:8 月 7 日 68,000 人民幣,8 月 21 日 72,000,8 月 24 日 75,698,9 月 14 日 79,698。五週多,漲了約 17%。
七月這一步,硬體沒有變。Spark 還是 2025 年推出的那台 Spark。變的是模型:低激活比例的大 MoE,讓一台本來只能玩玩的機器變成生產工具。
八月:創新還在模型,但社群開始接手
8 月 14 日 Qwen3.8-27B 開源,Apache 2.0。官方 SWE-bench Pro 61.7,Claude Opus 4.6 Max 是 53.4。
先看分數。Artificial Analysis 的 Intelligence Index(II)是 52 分,上一代 Qwen3.6-27B 大約 38,四個多月、一代之間加了 14 分。一個 27B 的模型,分數站到七月那顆 284B 的 V4 Flash 旁邊。
七月的路線是「大模型、低激活」,吃的是記憶體容量。八月換了一條路線:27B dense,整顆住進一張顯卡。八月我拆過它的創新點,跟 V4 Flash 很不一樣:
| 模型的創新 | 數字 | 對本地硬體的意義 |
|---|---|---|
| 智力密度 | II 52 分除以 27B,每 B 參數 1.93 分;V4 Flash 用總參數算是 0.18 | 每 B 參數買到的智力決定要多少 VRAM。密度高,一張顯卡就夠 |
| 後訓練,不是新架構 | 底層架構跟 Qwen3.6-27B 幾乎一樣,進步來自 agent 軌跡和 tool calling 的訓練 | 架構沒動,推理引擎、量化方案、kernel 優化全部可以沿用。這是社群能在幾天內開始魔改的前提 |
| Hybrid 架構省 KV | 64 層裡 48 層是 Gated DeltaNet,只有 16 層 full attention 要存隨 context 增長的 KV cache | 長 context 不會馬上把 VRAM 吃光。但 262K 全開,那 16 層的 KV 還是要約 16 GiB |
| 用推理量換分數 | 評測中生成 1.6 億 tokens,受測模型的中位數是 4,300 萬 | 在雲端這是帳單放大器。在本地,多想一點只是多花電和時間 |
第二列最容易被忽略。七月的創新在架構,八月的創新其實在訓練:同一個架構、同一個大小,分數多了 14 分。 對手上已經有顯卡的人,這等於換一個檔案就升級。
Q4_K_XL 是 17.6GB,24GB 的卡放得下,32GB 的 5090 還有空間開並行。我自己在 5090 上測到單人 113.75 tok/s,四人總吞吐 425.44。社群實測整理下來,3090 是 25–57、4090 是 45–97、5090 是 74–153 tok/s。
所以八月被拉進來的是 NVIDIA 的高階遊戲卡。5090 從 7 月的 12 萬到 8 月的 17 萬,是我這條報價線上最陡的一段。
但八月更重要的變化在模型發布之後。
- 開源三天之內,社群做出至少五個無護欄版
- 9 月 17 日 PrismML 發布 Ternary Bonsai 2 27B,把同一個模型壓到 5.93GB,自測保留 98.2%
- 有人把 MTP head 嫁接回三值模型,RTX 3060 12GB 上從 26 拉到 50 tok/s
「誰能跑 27B」這個問題,8 月的答案是 24GB,9 月變成 12GB。
七月的創新是一家實驗室做的。八月的創新,一半是實驗室做的,另一半是一群不認識彼此的人接力做的。
九月:創新搬到了推理引擎
8 月 26 日 Qwen 發布 Qwen3.8-Flash-Next:125B 參數、每個 token 只激活 6B。
模型本身是七月那條「大 MoE」路線的延續。問題是它卡在一個尷尬的大小:一張顯卡塞不下,學界的解法 FreeToken 又要把全部專家放進主機記憶體,論文裡那台 5090 配的是 192GB DDR5,NVFP4 版的 checkpoint 還有 135GB。
9 月 24 日,GitHub 使用者 Niko1221 推了 Strata 的第一個 commit。MIT 授權,一個人寫的。
它沒有發明新模型,也沒有發明新的量化方法。它做的是把記憶體分層:常用的專家快取在 VRAM,全部專家放 RAM,沒命中的由 CPU 就地算,大查表留在 SSD。我在 5090 加 64GB RAM 上實測,IQ3_S 版 41 筆真實請求的生成速度中位數 106.8 tok/s,GPU 專家快取命中率 93.4%。
對硬體的意義是:VRAM 和 RAM 被當成同一個池子來用。 原本不可行的 125B MoE,在一台遊戲機上變得可行。
Strata 的 README(10 月 5 日的版本)寫的支援範圍:
- NVIDIA RTX 20 到 50 系列,12GB VRAM 起
- AMD RX 6800/6900、7700 XT 以上、9060 XT、9070、R9700
- RAM 最低 32GB,建議 64GB
- 實驗性支援 Tesla P40/V100、GTX 10 系列、Radeon VII/MI50、Intel Arc
作者自己在 RTX 5070 12GB 上的數字:IQ3_XXS 62 tok/s、IQ3_S 53 tok/s。那則貼文說「decode 50 token/s 經常都有」,跟這個數字對得上。X 上有人拿 V100 配 2016 年的 Xeon 跑,約 40 tok/s。
GitHub star 的速度也說明了有多少人在等這個東西:10 月 1 日我寫 Strata 那篇時是 2.9k,10 月 3 日約 7,900,10 月 5 日我再看是 10.7k。
七月的創新需要一家實驗室。九月的創新,一個人、一個 repo。
把兩條線疊起來
門檻這條線,三個月是這樣走的:
- 7 月:256GB 統一記憶體(兩台 Spark)
- 8 月:32GB VRAM(一張 5090),魔改後 12GB
- 9 月:12GB VRAM 加 32GB RAM
價格這條線:10 萬、12 萬、17 萬、22 萬。
門檻一路往下,價格一路往上。
這修正了我自己八月寫的一篇文章。〈5090 三個月從 10 萬變 17 萬〉的框架是「硬體在漲,但軟體側有五條技術路徑壓低門檻」。兩個月後回頭看,那五條路徑真的把門檻壓下去了:27B 從 24GB 降到 12GB,125B 的 MoE 從論文裡那台機器的 192GB RAM,降到 32 到 64GB。
可是帳單沒有跟著降。17 萬變成 22 萬。
那篇文章隱含了一個推論:門檻降了,負擔就輕了。這個推論不成立。門檻下降讓更多硬體變成生產工具,它沒有讓任何一樣硬體變便宜。
九月這一步還有一個副作用。Strata 把對 VRAM 的需求壓下去,壓力轉到 RAM。而 RAM 是這半年漲最兇的零件:32GB DDR5 從約 3,000 元漲到近 13,000 元。引擎層的創新,把需求導向了最缺的那個東西。
反方:5090 漲價,不是本地 AI 玩家買出來的
這個反駁是成立的,而且證據比我的主論點硬。
7 月 28 日媒體整理的台灣開價是 159,990 元起,NVIDIA 建議售價是 71,990 元起。同一篇報導給的原因是記憶體:16GB GDDR7 的批量採購價從 80 到 90 美元漲到 200 到 300 美元,AI 伺服器對 HBM 的需求排擠了 GDDR 的產線。我八月那篇引過的數字是記憶體佔顯卡物料成本超過 80%,TrendForce 估要到 2027 到 2028 年供給才正常化。
換句話說,把 5090 推到 22 萬的主力是資料中心,不是在家跑 Qwen 的人。那則貼文的標題把因果講得太滿。我手上沒有任何數據可以拆出「本地 AI 需求」佔這波漲價的幾成。
所以主論點要改寫。
本地 AI 沒有造成這波漲價。它改變的是另一件事:「等降價再買」這個選項的吸引力。
以前顯卡漲價,等就好,反正遊戲不會跑掉。現在每等一個月,手上的硬體能跑的東西就多一級,沒買的人少用一個月。七月 Spark 變成生產工具,八月是 24GB 以上的卡,九月輪到 12GB 的卡。供給端的缺口是資料中心挖的,但需求端願意追價的理由,是這條技術線給的。
京東上雙機 Spark 那四個價格時點,至少說明了一件事:模型出來之後,有人願意在漲價途中下單。
貼文的預測:再往下還有兩級
那則貼文的結尾是一個預測:4 到 8GB 的顯卡、16GB 記憶體的旗艦手機,會因為 Jev 這一類模型的普及而加入戰場,開始大量吞吐「decision token」。
這條線我寫過。Jev 是 9 月 15 日 TypeSafe 發布的模型,不寫字,只在選項裡勾一個。開源社群用 Qwen3.6-35B-A3B 復刻,JevBench 上 95.5% 對 Jev 的 96.3%。更小的那條路是 4.21 億參數的 Laya,我在 5090 上微調,合成測試集從 0.496 升到 0.921。
技術上,這個預測的方向跟前三個月一致:模型不生成,只判斷,參數量可以再往下縮。
但它現在是預測。目前接近 Jev 分數的開源復刻用的是 35B 的底座,不是手機跑得動的大小;4.21 億參數那條路要靠自己的資料微調才能用。4GB 顯卡和手機「具備生產力」這件事,我還沒有看到實測。
這改變了我自己的決策
以前我規劃本地推理的機器,第一個問題是「5090 現在多少錢」。
現在第一個問題變成「手上的機器落在哪一條技術線」:
- 有 24 到 32GB 顯卡:27B dense。整顆住在 VRAM、不吃 RAM、能並行。多人共用的 server 還是這條。
- 有 12 到 16GB 顯卡加 64GB RAM:Strata 加 125B MoE,單人用。或是三值的 27B。
- 有大容量統一記憶體的機器:七月那條路,大 MoE 直接放。
三條線吃的資源不一樣:dense 吃 VRAM,MoE 加引擎吃 RAM,統一記憶體吃容量。22 萬的 5090 只是其中一條線的入場券,而且是目前最貴的那張。
我半年前買的那張 5090 沒有換過。這三個月它跑的東西從 27B 換到 125B,機器還是同一台。如果今天才要進場,我不會從「買一張 22 萬的卡」開始算,會先看桌上那台機器有幾 GB 的 RAM。
坦白說
第一,價格線是我一個人的詢價。 10 萬、12 萬、17 萬、22 萬是我在不同月份問到的報價,不是市場統計。7 月底媒體整理的開價已經是 159,990 元起,比我 7 月問到的 12 萬高,代表同一個月內不同店家、不同型號、不同日期的價差就很大。
第二,「一個月一步」是事後整理出來的敘事。 V4 Flash 是四月發布的,0731 是後來的更新版;Bonsai 2 是九月發的,我把它放在八月那條線上,因為它是 Qwen3.8-27B 的下游。真實的時間軸比表格亂。
第三,京東的價格來自單一使用者的帖子。 那四個時點是 V2EX 一位網友自己記的,我沒有找到第二個來源。貼文裡「三天連漲三次」的說法我查不到佐證,所以沒有採用。
第四,Strata 降低的是「能跑」的門檻,不是「好用」的門檻。 它預設一次只回一個請求。3-bit 量化在第三方的 291 題 MMLU-Pro 上扣約 3 分。舊卡的支援在 README 裡標的是實驗性。12GB 卡上 53 到 62 tok/s 是作者自己量的數字。
第五,因果我證明不了。 這篇把兩條線疊在一起,疊出來的是相關,不是因果。能確定的只有:記憶體供給是漲價的主因,而本地 AI 的技術線讓同一批硬體在漲價期間變得更有用。
但這條技術線本身是實的:三個月裡,同一個問題「什麼硬體能跑有用的模型」,答案從 256GB 掉到 12GB,而最後一步是一個人寫出來的。
關鍵洞察
看創新發生在哪一層,比看哪個模型分數高有用。 七月和八月在模型層,受益的是特定硬體(Spark、高階 N 卡)。九月在引擎層,受益的是所有有 RAM 的機器。下一步如果落在更小的判斷型模型,受益的會是更低階的硬體。
門檻下降不等於變便宜。 門檻每降一級,就多一批硬體從玩具變成工具。對已經有機器的人,這是白拿的升級;對還沒買的人,這不是等待的理由。
規劃機器時,先分清楚自己走的是哪條線。 Dense 吃 VRAM,MoE 加引擎吃 RAM,統一記憶體吃容量。三條線的瓶頸零件不同,漲價的幅度也不同。
硬體的價格是供應鏈定的,硬體的用處是開源社群定的。這三個月,後者跑得比前者快。
常見問題 Q&A
Q: 2026 年 RTX 5090 在台灣漲了多少?原因是什麼?
作者自己的詢價紀錄是 5 月 10 萬、7 月 12 萬、8 月 17 萬,10 月 1 日原價屋報價 22 萬,而且暫時買不到,要先跟店家申請,五個月約 2.2 倍。這是單一買家的報價,不是市場統計。7 月 28 日媒體整理的台灣開價是 159,990 元起,NVIDIA 建議售價是 71,990 元起。主因是記憶體:16GB GDDR7 的批量採購價從 80 到 90 美元漲到 200 到 300 美元,AI 伺服器對高頻寬記憶體(High Bandwidth Memory, HBM)的需求排擠了顯示記憶體的產線。
Q: 本地 AI 的「技術線」從七月到九月是怎麼演進的?
七月的創新在模型:DeepSeek V4 Flash 0731 是 284B 參數、每個 token 只激活 13B 的混合專家模型(Mixture of Experts, MoE),兩台 DGX Spark 共 256GB 統一記憶體就能跑 FP8。八月的創新還在模型,加上社群魔改:Qwen3.8-27B 是 27B 的稠密模型(Dense Model),Q4_K_XL 版 17.6GB,放得進 24 到 32GB 顯卡,之後的三值量化(Ternary Quantization)版把門檻降到 12GB。九月的創新搬到推理引擎(Inference Engine):Strata 讓 125B 的 Qwen3.8-Flash-Next 跑在 12GB 顯卡加 32 到 64GB RAM 上。
Q: Strata 為什麼讓 12GB 顯卡也能跑 125B 的模型?
Strata 是 GitHub 使用者 Niko1221 在 2026 年 9 月 24 日開源的推理引擎,MIT 授權。Qwen3.8-Flash-Next 有 125B 參數,但每個 token 只激活 6B。Strata 把常用的專家(Expert)快取在 VRAM,全部專家放在主機 RAM,沒命中的由 CPU 就地計算,大查表留在 SSD,等於把 VRAM 和 RAM 當成同一個池子。作者在 RTX 5070 12GB 上量到 IQ3_XXS 62 tok/s、IQ3_S 53 tok/s;在 RTX 5090 加 64GB RAM 上,41 筆真實請求的生成速度中位數是 106.8 tok/s。限制是預設一次只回一個請求,而且 3-bit 量化在第三方的 291 題 MMLU-Pro 測試上扣約 3 分。
Q: 本地 AI 的門檻降低了,為什麼硬體反而更貴?
因為門檻下降和價格是兩件事。三個月內,能跑有用模型的硬體門檻從 256GB 統一記憶體降到 12GB VRAM 加 32GB RAM,同期作者問到的 RTX 5090 報價從 12 萬漲到 22 萬。漲價的主因是記憶體供給被資料中心吃掉,不是本地 AI 玩家。門檻下降做的事是讓更多硬體從玩具變成生產工具,它不會讓任何一樣硬體變便宜;而且像 Strata 這類引擎把需求從 VRAM 導向 RAM,32GB DDR5 這半年已經從約 3,000 元漲到近 13,000 元。
Q: 現在想跑本地模型,一定要買 RTX 5090 嗎?
不一定,要看走哪一條技術線。有 24 到 32GB 顯卡,適合跑 Qwen3.8-27B 這種稠密模型,整顆放在 VRAM、能多人並行。有 12 到 16GB 顯卡加 64GB RAM,可以用 Strata 跑 125B 的 Qwen3.8-Flash-Next,但只適合單人使用。有大容量統一記憶體的機器(例如兩台 DGX Spark 共 256GB),可以直接放大型 MoE 模型。三條線的瓶頸零件不同:稠密模型吃 VRAM,MoE 加引擎吃 RAM,統一記憶體吃容量。
延伸閱讀
- 5090 三個月從 10 萬變 17 萬:五條技術路徑壓低地端 AI 的硬體門檻
- 北京一家酒吧免費請你用 DeepSeek V4 Flash:兩台地端 DGX Spark,token 無限量
- Qwen3.8-27B 開源:SWE-bench Pro 61.7 贏過 Opus 4.6 Max
- Ternary Bonsai 2 27B:三值量化到底是什麼
- Qwen3.8-Flash-Next 跑在 RTX 5090 + 64GB:Strata 實測 IQ3_XXS vs IQ3_S
- 一張原價屋估價單,看懂 Token 經濟學如何把 DDR 打到天價