Strata 兩週發了 44 版,模型一個都沒換:CPU 一起算、IQ3 量化、只認一個模型,GLM 已經有人照抄
9 月 24 日到 10 月 7 日,Strata 14 天發了 44 個 release。
硬體支援一直加:AMD、RTX 20、Pascal、Strix Halo、Intel Arc,社群分支還跑上了 ARM 架構的 DGX Spark。
模型一個都沒加。從第一版到現在,它只跑 Qwen3.8-Flash-Next。
10 月 8 日我查是 16,952 個 star、1,497 個 fork。10 月 1 日我寫第一篇 Strata 實測的時候是 2.9k。
30 秒定位
| 項目 | 內容 |
|---|---|
| 專案 | Strata,Niko1221 開源,MIT 授權 |
| 版本 | 9/24 v0.1.0 → 10/7 v0.1.40.3,共 44 個 release |
| 模型 | 只有 Qwen3.8-Flash-Next:125B 參數、每個 token 只激活 6B |
| MoE 結構 | 48 層、每層 512 個專家,共 24,576 個,每個 token 只叫 10 個 |
| 作者的基準機 | RTX 5070 12GB、Ryzen 5 7600、64GB DDR5 |
| 速度(短聊天) | Q2_0 94 tok/s、IQ3_XXS 62 tok/s、IQ3_S 53 tok/s |
| 跟進者 | lighttransport/Strata,9 月 30 日建立,同一套思路改跑 GLM-5.3-Flash |
兩週的進展
先把 release notes 裡比較大的幾步排出來:
| 日期 | 版本 | 做了什麼 |
|---|---|---|
| 9/24 | v0.1.0 | Windows、RTX 30/40/50 |
| 9/26 | v0.1.3 | 對話快取:7.7K 的對話,追問從 12.9 秒等到 0.3 秒 |
| 9/26 | v0.1.4 | 支援 ISTA-DASLab 的 IQ3_S;Strata 自己量 HumanEval,IQ3_S 95.1%、Q2_0 92.1% |
| 9/27 | v0.1.5 | KV 串流:Q2_0 開 262K,生成從 50.9 拉到 62.6 tok/s |
| 9/28 | v0.1.13 | 長 prompt 讀取快約 2 倍:IQ3_S 讀 32K 從 383 到 1,208 tok/s |
| 9/29 | v0.1.25 / v0.1.27 | AMD Radeon(實驗性)、RTX 20 |
| 10/6 | v0.1.40 | Strix Halo(實驗性)、Pascal/Volta 用的 CUDA 12 版(實驗性)、統一記憶體的可用量計算 |
| 10/7 | v0.1.40.2 | Intel Arc 正式支援;DGX Spark 讀 prompt 最高快 10 倍 |
整張表看下來,速度、記憶體、硬體覆蓋三條線同時在推,模型那一欄始終是同一個。
DGX Spark:跑得起來,但走社群分支
DGX Spark 是 NVIDIA 的 GB10 小主機,CPU 是 ARM(10 顆 Cortex-X925 加 10 顆 Cortex-A725),128GB 統一記憶體,一台 4,699 美元。
Strata 的 release 只出 x86-64 版。讓它在 ARM 上 build 起來的是社群 PR #409,作者 eelgaev。他在一台 Spark 上跑 IQ2_XS、開 128K context,讀 prompt 928 到 1,515 tok/s,生成 54.9 到 62.0 tok/s。
接著 uncle daddy 用同一個分支跑 IQ3_S,發現讀 prompt 只有 91 tok/s。追下去,32 個搬資料的執行緒全綁在 core 0 上空轉,而 GB10 的 core 0 剛好是小核。修好之後,8K prompt 從 91 變 1,222 tok/s,30K 從 88 變 1,388 tok/s,生成 41 到 43 tok/s。這個修正(#1057)進了 10/7 的 v0.1.40.2。
有兩件事要講清楚:
- 主線沒有正式支援 Spark。 PR #409 已經關閉,主線只吸收了統一記憶體那一塊,aarch64 的 build 修改沒有進主線。GB10 支援的 issue 還開著,作者的回覆是:”We do not have a GB10 here to test on.”
- Spark 上,CPU 一個專家都沒算。 PR #409 寫得很明白:24,576 個專家全部放得進 GPU 快取(33.0 GiB),所以 CPU 不用接手任何專家。
第二點很重要,後面會用到。Spark 跑得起來,靠的是 128GB 統一記憶體把三層記憶體壓成一層,不是 ARM CPU 在幫忙算。
成功思路一:讓 CPU 一起算,而不是只靠搬
MoE 塞進小顯卡,傳統的直覺是:專家放 RAM,要用的時候搬過 PCIe 給 GPU 算。瓶頸就卡在 PCIe。
Strata 的論文第一段就點出通用引擎的問題:
works but leaves most of the machine idle most of the time
能跑,但整台機器大部分時間都在閒置。
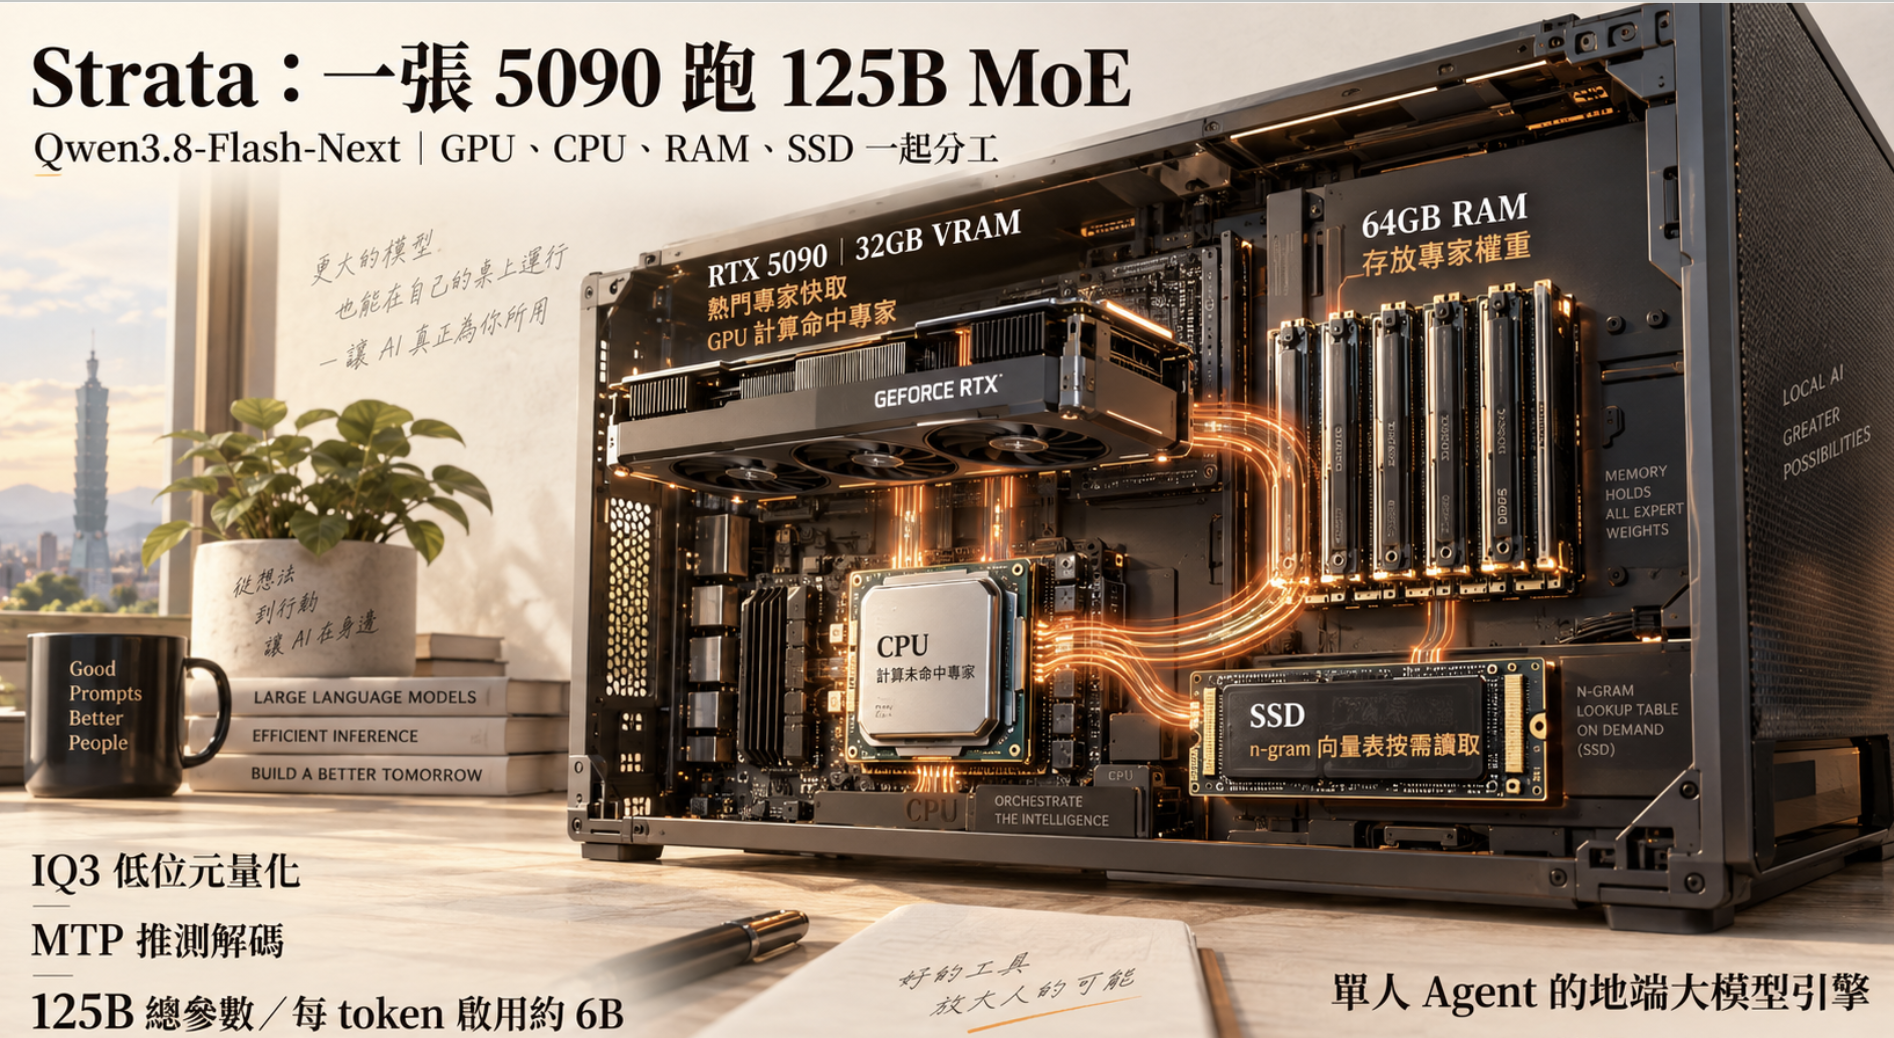
Strata 的做法是每一層讓三方同時開工:
- GPU 跑 attention 和 router,算出這個 token 要哪 10 個專家
- 已經在 VRAM 快取裡的專家,GPU 直接算
- 沒命中的專家,i-quant 檔有 55%、Q2_0 有 20% 透過 PCIe 送去 GPU,剩下的由 CPU 在 RAM 旁邊就地算
- CPU 把結果寫回,GPU 加總,進下一層
用餐廳來想:主廚(GPU)只有一張小檯面,放得下最常點的菜的料。客人點到冷門菜,舊做法是派人去倉庫把料搬到主廚檯面,主廚等料。Strata 的做法是在倉庫旁邊放一組二廚(CPU),冷門菜直接在倉庫做,跟主廚同時出菜。主廚檯面還是越大越好,但檯面小不再等於整間店卡住。
這修正了我 10/1 那篇的一句話。那篇我寫「Strata 的做法是不搬,CPU 就地算」,不夠精確。看完論文,正確的說法是:沒命中的專家一部分照樣搬,一部分 CPU 就地算,比例照量化格式調;讀 prompt 的時候則反過來,專家串流過 PCIe 給 GPU 批次算。重點不在「不搬」,在搬和算同時發生,誰都不閒著。
作者自己在 X 上講得更直白:
You can now buy old cheap DDR3 machine with 128GB or 64GB RAM connect 8GB+ GPU and run Qwen3.8-Flash-Next at 70tps+
More cores/threads in CPU - faster it will go
舊的 DDR3 機器、128GB 或 64GB RAM、接一張 8GB 以上的顯卡,就能跑 70 tok/s 以上;CPU 核心越多越快。這則貼文有兩千多個讚、二十多萬次瀏覽。70 tok/s 是作者自己的說法,我沒有查到第三方用 DDR3 機器複現的數字。
快多少?X 上 David Hendrickson 轉述作者的數字:同一台 RTX 5070,llama.cpp 大約 15 tok/s,Strata 最高 65.1 tok/s(128K、Q2_0)。這是二手轉述,llama.cpp 那邊用什麼參數也沒寫,當量級參考就好。
llama.cpp 本身也能把專家放到 CPU 算,我七月寫 MoE Offload 完全拆解時用的就是 --n-cpu-moe。所以「CPU 參與算專家」本身不是 Strata 發明的。Strata 的差別在三件事疊在一起:同一瞬間並行、會跟著對話調整的 VRAM 熱專家快取、為這一個模型手寫的排程。
成功思路二:IQ3 這個名字會騙人
Strata 用的量化檔來自 ISTA-DASLab,方法叫 GSQ-RCO。檔名寫 IQ3_XXS、IQ3_S,看起來是 3-bit,但它跟一般 llama.cpp 的 3-bit 不是同一回事。
X 上有人專門出來澄清:
GSQ-RCO IQ3_XXS is not equivalent to i-matrix 3-bit.
差在哪?一般量化整個檔案用同一種格式。GSQ-RCO 先把每個 tensor 用各種格式都量化一遍,再用梯度搜尋決定每個 tensor 該用哪一種,總大小卡在預算內。這個模型搜了 352 個 tensor,可搜尋的權重有 95% 在專家裡,所以精度主要在專家之間分配,每一層指定一種格式。IQ3_XXS 平均 3.00 bit,IQ3_S 平均 3.50 bit。
官方卡上的分數(對照 BF16 原版):
| 版本 | 平均 bit | 檔案大小 | AIME25 | GPQA-Diamond | LiveCodeBench v6 | 三項平均 |
|---|---|---|---|---|---|---|
| BF16 原版 | 16.00 | 354 GB | 100.00 | 91.92 | 87.43 | 93.12 |
| IQ3_XXS | 3.00 | 75.8 GB | 100.00 | 91.41 | 86.29 | 92.57 |
| IQ3_S | 3.50 | 83.6 GB | 100.00 | 92.93 | 86.86 | 93.26 |
IQ3_XXS 拿到原版三項平均的 99.4%。IQ3_S 的平均還略高於原版,但卡片自己也說,超過原版的部分要讀成打平,不是變強。
那接近 Q6 嗎?證據分兩邊
社群裡流傳「IQ3_S 接近 Q6」。我查了一輪,證據不一致。
支持的一方:X 使用者 FHILY 拿 IQ3_S 跟 Unsloth 的 UD-Q4_K_XL、UD-Q6_K_XL 比:
So far, IQ3_S is landing within the margin of error of UD-Q6_K_XL.
但他自己接著說:
I’d still want more tests before calling it definitive.
反對的一方:我 10/1 那篇引過的 Nigel Hungerford-Symes,用 291 題 MMLU-Pro 比:
1
2
3
IQ3_S on Strata, 84 GB:     65.3%
UD-Q4_K_XL, 111 GB:         68.4%
UD-Q6_K_XL, 169 GB:        68.7%
The 3.5-bit does cost ~3 pts, and it’s real (p=0.02 vs Q6).
我的解讀:推理和程式題(AIME、GPQA、LiveCodeBench),IQ3_S 跟原版打平;知識型的 MMLU-Pro,扣 3 分是真的。說「接近 Q6」要加條件,看你考的是哪一種題。
為什麼 IQ3 是 Strata 成功的必要條件
這跟第一個思路是綁在一起的。Strata 要求全部專家放進 RAM。
- UD-Q6_K_XL 是 169.2 GB,64GB 的 PC 放不下
- IQ3_S 要常駐的部分是 54.8 GB,IQ3_XXS 是 47.0 GB,64GB 剛好放得下
沒有 GSQ-RCO 把 125B 壓到 64GB 放得下、分數又守得住,「CPU 就地算 RAM 裡的專家」這個設計根本沒有舞台。引擎和量化是同一件事的兩半。
成功思路三:只服務一個模型
論文摘要裡有一句話,我覺得是整個專案的核心:
Strata is an inference engine written for this one model
Strata 是為這一個模型寫的推理引擎。
只認一個模型,能做什麼通用引擎做不到的事?看 Qwen3.8-Flash-Next 的形狀(論文 Table 1,Q2_0 檔):
| 模型的部分 | 存了多少 | 每個 token 讀多少 | Strata 放哪 |
|---|---|---|---|
| 路由專家(48 層 × 512) | 34.0 GB | 0.66 GB(2%) | 全部在 RAM,最常用的快取到 VRAM |
| Mixer、attention、共享專家、router 等 | 約 3.5 GB 合計 | 每個 token 都讀 | VRAM |
| N-gram embedding 表 | 28.8 GB | ≤ 23 KB | SSD 加作業系統快取 |
再加上兩個結構特性:
- 48 層裡 36 層是 Gated DeltaNet,記憶體是固定大小的狀態,不會隨 context 長大;另外 12 層的 attention 最多只看約 2,048 個位置
- n-gram 表用最後三個 token 定址,查哪幾列在用到之前就知道,可以提前從 SSD 讀
每個 token 只碰到 2% 的專家權重、查表可以預讀、長 context 不吃記憶體。這三個特性決定了「VRAM 放熱的、RAM 放全部、SSD 放查表」這個分層可以成立。通用引擎要照顧幾百種模型,不會為一個模型的查表寫預讀。
44 個 release 也照這個邏輯走。模型選單裡的東西全是同一個 base 的變體:原版、Swift 1.5(fine-tune,想得比較短)、Coder(留 512 個專家中的 256 個,作者量 SWE-bench Verified 是完整版的 91%,32GB RAM 放得下)、Unsloth 的 4-bit 版。所有力氣都花在「同一個模型,讓更多硬體跑得動、跑得快」。
這跟 FDE 是同一種打法
我寫 FDE 系列的時候引過一句話:「在規模上做不擴展的事情」。駐場工程師不做通用 SaaS,就鑽進一個客戶的現場,把那個現場做透。
Strata 就是對一個模型做 FDE。不追求支援所有模型,鑽進一個模型的形狀裡,把每一個位元組的去向算清楚。
FDE 那篇還有後半句:要把現場知識 update 回產品,不然只是高級外包。Strata 的現場知識也在往外流:release notes 裡好幾項加速是從 Eddoursul 的 fork 合回來的,而最新的流向,是有人把整套思路帶去另一個模型。
開始有人照抄:lighttransport 把它搬到 GLM-5.3-Flash
lighttransport/Strata 在 9 月 30 日建立,做的事很單純:沿用 Strata 的引擎,改跑 GLM-5.3-Flash。一樣只服務一個模型。
做法比原版更極端。路由專家在生成時全部在 CPU 從 RAM 算,主專家快取直接設成 0;GPU 只負責固定層、批次讀 prompt 和 MTP 推測。
兩台機器的實測:
| 機器 | 生成速度 |
|---|---|
| 舊伺服器:2× Tesla V100 32GB、2× Xeon Gold 6240、160 GiB RAM | 29.06 tok/s(4K C++ benchmark 中位數) |
| 桌機:Threadripper 1950X、160GB DDR4、RTX 5060 Ti 16GB | 7.33 tok/s(短聊天中位數) |
它讓模型寫了一個 C++17 的數字 parser,通過 400,532 個測試案例。
思路搬得過去,速度搬不過去
同樣是 Strata 的引擎,Qwen 在 12GB 卡上短聊天 53 到 94 tok/s,GLM 在 16GB 卡加 160GB RAM 的桌機上只有 7.33 tok/s。差在模型形狀:
| Qwen3.8-Flash-Next(Q2_0) | GLM-5.3-Flash(UD-Q2_K_XL) | |
|---|---|---|
| 每層專家 | 512 選 10 | 288 選 8 |
| 每個 token 要讀的專家權重 | 0.66 GB | 2.751 GB |
| 建議 RAM | 64GB 放得下全部 size | 160 到 192 GB |
每個 token 要搬的專家位元組差了大約 4 倍(兩邊量化檔不同,只能看量級)。CPU 就地算,吃的是記憶體頻寬,每個 token 多讀 4 倍,速度就掉下來。
Strata 的成功一半在引擎,一半在 Qwen 團隊把模型設計成「每個 token 只碰 2%」。換一個比較不稀疏的模型,同一套引擎思路照樣能跑,但跑不出同樣的數字。
GLM 這個 fork 也還很早:9 個 star,API 只支援 greedy、不重用對話前綴,tool call 的解析還沒做,所以還不能接 coding agent。
反方:為一個模型寫引擎,下一代模型出來不就白寫了?
這是最強的反駁。通用引擎的價值就在於模型換代不用重寫,Strata 綁死 Qwen3.8-Flash-Next,Qwen 下一版換了架構,44 個 release 的調校可能大半作廢。
我的回應分兩層。
第一,被綁死的是調校,不是思路。 lighttransport 從 9 月 30 日建立到現在,就把它改到 GLM-5.3-Flash 上跑起來,而且有驗證過的程式輸出。分層記憶體、CPU 同時算、MTP 推測這些想法都帶得走。
第二,這筆帳算的是時間。 一個模型被大量使用的期間,專用引擎能讓 12GB 卡的使用者從跑不動變成天天能用。兩週 44 個 release 換來的是一整群原本跑不動的人跑得動。下一代出來再重寫一次,代價是一段時間的工程,不是整個生態從頭來過。
但反方有一點我同意:專用引擎的天花板是模型給的。 GLM 的例子已經說明,模型不夠稀疏,引擎再專精也只有 7 tok/s。所以專用引擎這條路能不能複製,要先看模型的形狀,不是看引擎寫得多好。
這改變了誰的什麼決策
個人開發者、想在家跑大模型的人。 以前問「想跑大 MoE,要買多大的 VRAM」,答案指向 5090,而 5090 在台灣這半年從 10 萬漲到 22 萬。現在第一個問題要換成「RAM 夠不夠放全部專家」,第二個是「CPU 有幾個核心」,VRAM 排第三。手上有一台 RAM 很大的舊工作站或舊伺服器,值得先拿來試,不要急著買新卡。
在 DGX Spark 和遊戲機之間猶豫的人。 兩邊條件不同(prompt 長度、設定都不一樣),只能看量級:Spark 跑 IQ3_S 生成 41 到 43 tok/s,作者的 RTX 5070 12GB 跑 IQ3_S 短聊天 53 tok/s,我的 5090 加 64GB 跑真實 agent 請求中位數 106.8 tok/s。Spark 的優勢是 128GB 統一記憶體放得下整個模型、不用分層;劣勢是它在 Strata 這邊走的是社群分支,作者手上沒有機器可以測。
坦白說
這篇有幾個要扣分的地方。
第一,所有速度數字都是作者或社群自己量的。 release notes 寫得很誠實,常常註明「the author’s number」「we have not run it on …」,但沒有任何一個數字經過獨立實驗室複現。DDR3 機器跑 70 tok/s 是作者的一句話,我沒查到別人跑出來的紀錄。
第二,「IQ3 接近 Q6」我沒辦法給定論。 官方卡的三項推理題打平原版,一位使用者說落在 Q6 的誤差範圍內,另一位用 291 題 MMLU-Pro 量出扣 3 分、p=0.02。這三份資料題型不同、樣本都不大。
第三,DGX Spark 那段是社群在一台機器上的結果。 主線沒有收 aarch64 的 build,作者沒有機器測。今天能跑,不代表下一版還能直接跑。
第四,Strata 的單一模型策略能維持多久,現在不知道。 一個人主導、兩週 44 版,迭代速度很驚人,也代表每一版都可能改掉上一版的行為。
但它做對了一件事:它示範了「模型形狀 × 專用引擎 × 精挑的量化」三者對齊時,一台普通的 PC 能做到什麼。 這個組合現在有人開始複製了。
關鍵洞察
- MoE 本地推理的瓶頸,已經從「VRAM 塞不塞得下」變成「整台機器有沒有同時在動」。 評估硬體時,RAM 容量決定能不能跑,CPU 核心和記憶體頻寬決定冷專家算多快,VRAM 決定熱專家的比例。三個一起看。
- 量化檔名的「3-bit」已經不代表品質等級。 GSQ-RCO 的 IQ3_S 在推理題上打平原版,但知識題扣 3 分。選量化版本,要看它在你的任務類型上的分數,不要看檔名。
- 要判斷「Strata 模式」能不能複製到下一個模型,先算每個 token 要讀多少專家權重。 Qwen3.8-Flash-Next 是 0.66 GB,GLM-5.3-Flash 是 2.751 GB,速度差距就從這裡來。
常見問題 Q&A
Q: Strata 是什麼?它跟 llama.cpp 差在哪?
Strata 是 GitHub 使用者 Niko1221 在 2026 年 9 月 24 日開源的推理引擎(Inference Engine),MIT 授權,只服務 Qwen3.8-Flash-Next 一個模型。它把 24,576 個專家(Expert)全部放在主機 RAM,最常用的快取到 VRAM,每一層讓 GPU 算快取命中的專家,同時把沒命中的一部分透過 PCIe 送去 GPU、其餘由 CPU 就地計算。llama.cpp 也能用 --n-cpu-moe 把專家放到 CPU,但它是通用引擎,Strata 的論文形容通用做法「能跑,但整台機器大部分時間閒置」。作者的 RTX 5070 12GB 加 64GB RAM 上,IQ3_S 短聊天生成 53 tok/s。
Q: Strata 能在 DGX Spark 上跑嗎?
可以,但走社群分支。DGX Spark 用 NVIDIA GB10,CPU 是 ARM 架構(aarch64),Strata 官方 release 只有 x86-64 版。社群 PR #409 讓它在 ARM 上 build 起來,IQ2_XS 版讀 prompt 928 到 1,515 tok/s、生成 54.9 到 62.0 tok/s;另一位使用者修好執行緒綁核問題後,IQ3_S 讀 8K prompt 從 91 提升到 1,222 tok/s,生成 41 到 43 tok/s。PR #409 已關閉,主線只吸收了統一記憶體(Unified Memory)的可用量計算,作者表示手上沒有 GB10 可以測。Spark 的 128GB 統一記憶體放得下全部專家,所以在 Spark 上 CPU 並不參與計算專家。
Q: GSQ-RCO 的 IQ3_S、IQ3_XXS 品質真的接近原版嗎?
要看題型。ISTA-DASLab 用 GSQ(Gumbel-Softmax Quantization)和 RCO(Riemannian Constrained Optimization)替每個 tensor 分配不同量化格式,IQ3_XXS 平均 3.00 bit、75.8 GB,IQ3_S 平均 3.50 bit、83.6 GB,原版 BF16 是 354 GB。官方的 AIME25、GPQA-Diamond、LiveCodeBench v6 三項平均,原版 93.12、IQ3_XXS 92.57(99.4%)、IQ3_S 93.26,可以視為打平。但第三方用 291 題 MMLU-Pro 測,IQ3_S 65.3%、UD-Q6_K_XL 68.7%,約扣 3 分且統計顯著(p=0.02)。推理與程式題接近原版,知識題有損失。
Q: 為什麼 Strata 只支援一個模型?這樣不會很快過時嗎?
因為專精讓它能利用 Qwen3.8-Flash-Next 的結構:每個 token 只碰 2% 的專家權重(Q2_0 檔每 token 讀 0.66 GB)、48 層裡 36 層是記憶體固定大小的 Gated DeltaNet、28.8 GB 的 n-gram 查表可以提前從 SSD 預讀。通用引擎不會為單一模型寫這些優化。過時的風險是真的,但思路可以移植:lighttransport/Strata 在 9 月 30 日建立,把同一套引擎改跑 GLM-5.3-Flash。
Q: 同一套 Strata 思路搬到 GLM-5.3-Flash,效果如何?
能跑,但慢很多。lighttransport 的 fork 在 Threadripper 1950X、160GB DDR4、RTX 5060 Ti 16GB 的桌機上,短聊天生成 7.33 tok/s;在 2 張 Tesla V100 32GB 加 2 顆 Xeon Gold 6240、160 GiB RAM 的舊伺服器上,4K C++ benchmark 生成 29.06 tok/s。主因是模型形狀:GLM-5.3-Flash 的 UD-Q2_K_XL 每個 token 要讀 2.751 GB 專家權重,大約是 Qwen3.8-Flash-Next Q2_0 檔 0.66 GB 的 4 倍,而且建議 160 到 192 GB RAM。這個 fork 目前只支援 greedy 解碼,還不能解析 tool call。
延伸閱讀
- Qwen3.8-Flash-Next 跑在 RTX 5090 + 64GB:Strata 實測 IQ3_XXS vs IQ3_S
- 5090 從 10 萬漲到 22 萬的五個月:本地 AI 的創新,從模型搬到了推理引擎
- MoE Offload 完全拆解:為什麼 671B 模型只吃 17GB VRAM 還能跑
- 北京一家酒吧免費請你用 DeepSeek V4 Flash:兩台地端 DGX Spark,token 無限量
- FDE 模式全解析:駐場工程師才是落地關鍵
來源
- Strata(GitHub, Niko1221) 與 Releases
- Strata 論文:Running a 125-Billion-Parameter Model on a Normal PC
- PR #409:aarch64 / NVIDIA DGX Spark (GB10)
- Issue #1056:DGX Spark prompt 讀取慢 10 倍
- Issue #774:Support for Nvidia GB10
- ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF(Hugging Face)
- lighttransport/Strata(GLM-5.3-Flash fork)
- Niko Veit(@coldniko)X 貼文
- David Hendrickson(@TeksEdge)X 貼文
- FHILY(@Oluwaphilemon1)X 貼文
- wd(@populartourist)X 貼文
- Nigel Hungerford-Symes(@VectorCrossProd)X 貼文