RED-SNOW:GLM-5.3 資安實力接近 Mythos,社群做出了專業紅隊武器
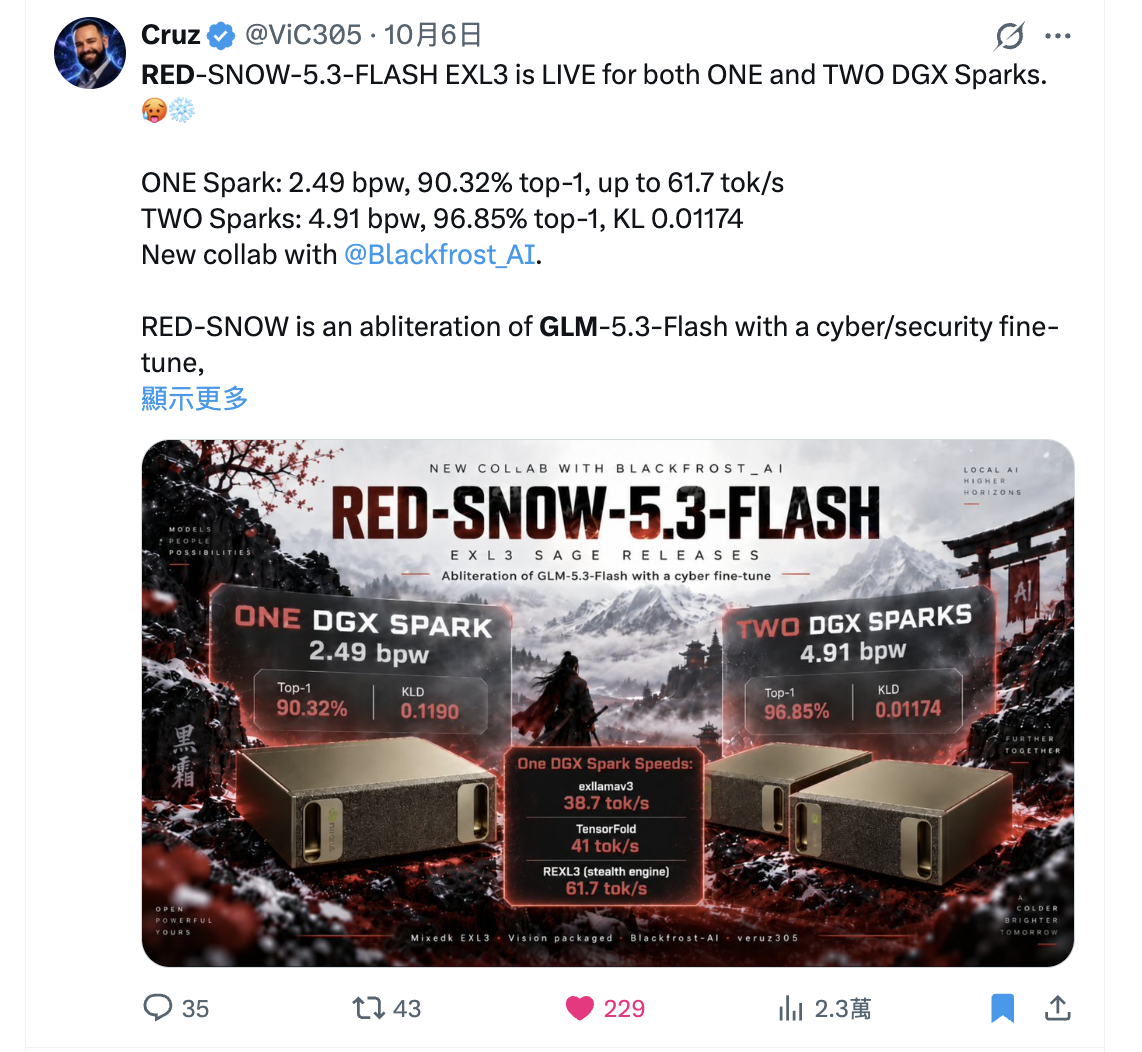
幾週前,Anthropic 發布了一份評測,GLM-5.3 在部分滲透測試任務的表現接近 Claude Mythos Preview。
社群很興奮:等於是官方認證 GLM 做資安很強。
但 Mythos 沒有開源。所以下一個想法很自然——既然 GLM-5.3 資安底子好,那我們拿它來後訓練魔改,尤其是那隻 320B 總參數的 GLM-5.3-Flash,總行吧?
RED-SNOW 就是這個想法的產物。
RED-SNOW 是什麼
| 項目 | 內容 |
|---|---|
| 模型 | RED-SNOW-5.3-FLASH,Blackfrost-AI 製作 |
| 底模 | GLM-5.3-Flash(320B 總參數、每 token 啟動 18B,MoE,MIT 授權) |
| 做了什麼 | abliteration(移除拒答行為)+ 17,132 筆訓練資料的資安 LoRA fine-tune,85.8% 是攻擊性資安內容 |
| 發布日 | 10 月 5 日 |
| 授權 | 標示只給授權的紅隊作業用 |
| 格式 | BF16 / FP8 / NVFP4(Blackfrost 官方)、EXL3(Cruz 社群版) |
Blackfrost 對 GLM-5.3-Flash 做了兩件事:消融(abliteration)讓它不再拒絕回答資安類問題,再用大量攻擊性資安資料做 fine-tune 讓它更懂攻防。
網友實測
發布之後,馬上有數個網友回報成功找出自己 app 的弱點。
Viktor:3 個 critical
Viktor 拿單台 Spark 的 2-bit 版,對自己做了 10 個月的 vibe-coded 網站做黑箱滲透測試,跑出 3 個 critical 問題。重點在三個字:自己的 app——不給原始碼、只給網址,讓模型像外部攻擊者一樣探,整個過程跑在他自己桌上。
Yume_X:21/22
測得最完整的是 Yume_X,12 項資安任務 judge 評分拿 21/22。唯一失分的一題不是不會做,是把 token 全花在想,最後沒寫出答案——GLM-5.3 關不掉 thinking,max_tokens 設太小的話,模型在思考區塊裡就把預算花光。
我自己跑了一輪
剛好上週有兩台 Spark,我就啟動雙機推理跑 RED-SNOW。
部署設定
| 項目 | 設定 |
|---|---|
| 模型 | RED-SNOW 5.3 Flash,EXL3 SAGE 4.91 bpw |
| 推理框架 | ExLlamaV3 雙機推理 + 自訂 API 相容層 |
| Context 上限 | 262,144 tokens(256K) |
| KV cache | 4-bit |
| 雙機分層 | Head:第 0–22 層;Worker:第 23–44 層 |
| 雙機通訊 | NCCL |
| 同時請求 | 1 個,忙碌回 429 |
| Thinking | 關閉(enable_thinking=False) |
| 前綴快取 / MTP | 未啟用 |
速度
生成速度約每秒 15 個 token,輸入長度主要影響首字等待:
| 輸入長度 | 首字等待 | 生成速度 | 輸出 160 tokens 總時間 |
|---|---|---|---|
| 223 tokens(第 1 次) | 1.23 秒 | 15.37 tok/s | 11.57 秒 |
| 223 tokens(第 2 次) | 1.23 秒 | 15.31 tok/s | 11.62 秒 |
| 9,006 tokens | 26.00 秒 | 14.88 tok/s | 36.69 秒 |
DeepSeek harness 帶約 9K 的對話與工具定義時,光等第一個字就要約 26 秒。開始輸出後仍約 15 tok/s,不太受 context 長度影響。
15 tok/s 有點慢。社群回報調整 serving 設定可以做到約 40 tok/s,但那時候 Spark 要還朋友了,沒辦法好好調——只能先測 RED-SNOW 的滲透能力。
掃描比較:RED-SNOW vs ZAP
拿 RED-SNOW 對兩個我自己的 VibeCoding 環境跑主動掃描,再用 ZAP 出來的被動掃描報告做比對:
| ZAP 被動掃描 | RED-SNOW 主動掃描 | |
|---|---|---|
| 原始告警 | 84 | 80 |
| 誤報 | 1 | 33 |
| 淨發現 | 83 | 47 |
兩次掃描互相印證:HSTS 缺失、nosniff 缺失、防嵌入缺失、CSP 的發現完全一致,可信度高。
RED-SNOW 掃出超過十幾個 ZAP 沒有的東西,包含 Spring Boot Actuator 暴露——這是被動掃描抓不到的,需要主動探測才會發現。
但誤報率是 41%(33/80)。33 個誤報的主因是 SPA fallback——前端對未知路徑一律回傳 index.html,掃描器把 /config.php、/admin 這些路徑當成可存取。這是 harness 的問題,不是模型的問題。
專業地端紅軍模型:新時代的資安標配
我之前寫過,我用 Huihui(Qwen 的無護欄版)幫一個要上線的朋友做了一次紅軍測試。測完之後,他去找專業資安團隊做付費掃描。結果他說:感謝我的紅軍模型,被掃出的問題比想像中少很多。
那次的經驗讓我確認一件事:地端紅軍模型,是有實際價值的防禦工具。
我之前寫過,有了 AI,等於人人都有了槍,你家裡就被迫也要放一把。就算不攻擊別人,也要好好定期弱點掃描一下。
Huihui 是一個選項,但它不是專門為紅隊設計的。RED-SNOW 是這個資安品類的專業特化版——abliteration 加上一萬七千筆攻擊性資安資料的 fine-tune,從訓練資料到模型行為都是為了滲透測試最佳化。
很有可能是接下來每個有產品要顧的團隊必備的工具。你不是拿它去攻擊別人,是先用攻擊者的武器打自己一遍,在對方之前找到洞。
坦白說
「Anthropic 評測顯示 GLM-5.3 資安接近 Mythos」這個說法,我看到社群討論提到但目前沒有拿到原始評測報告的連結。如果有讀者找到出處歡迎補充。
RED-SNOW 是 abliterated 模型,abliteration 會傷到長任務和 tool use。適用場景集中在中短 context 的 agent loop。
我自己的測試樣本很小:速度測了三次、掃描對照了兩個 app。掃描器誤報率 41%,主因是 SPA fallback 的邏輯沒做好,反映的是 harness 的成熟度,不是模型能力。速度只跑到 15 tok/s,社群回報調整設定可以做到 40 tok/s 以上,但我沒來得及調。
Huihui 的紅軍測試案例來自我自己之前的實作記錄。那次測試的細節和限制在原文裡交代過,這篇不重複展開。
「先打自己一遍」不等於「不用做其他防禦」。紅軍 AI 是一層,不是全部。
關鍵洞察
-
GLM-5.3 的資安底子夠好,社群才有動力去魔改。 沒有底模的資安能力,再多後訓練也補不回來。RED-SNOW 的存在本身就是對 GLM 資安實力的一次社群投票。
-
專業特化的紅隊模型,跟通用無護欄模型是不同品類。 Huihui 能做紅軍測試,但它的訓練資料不是為資安最佳化的。RED-SNOW 的 17,132 筆訓練資料裡 85.8% 是攻擊性資安內容——這是 fine-tune 在做的事。
-
地端紅軍測試的最大價值:在專業資安團隊來之前先掃一遍。 不是取代付費掃描,是在付費掃描之前把明顯的洞先補好。我朋友的經驗就是最好的例子。
-
部署方式的影響比換模型大。 我的 4.91 bpw 雙機版跑出 15 tok/s,社群報到 40 tok/s 以上。同一個模型,serving 設定的差距比換一個模型還大。
常見問題 Q&A
Q: RED-SNOW-5.3-FLASH 跟原版 GLM-5.3-Flash 差在哪?
RED-SNOW 是 Blackfrost-AI 在 GLM-5.3-Flash(320B 總參數、每 token 啟動 18B 的 MoE 架構)上做了兩件事:消融(Abliteration)移除模型的拒答行為,加上 17,132 筆訓練資料的資安 LoRA fine-tune,其中 85.8% 是攻擊性資安內容。結果是一個不會拒絕資安類問題的紅隊模型(Red Team Model),10 月 5 日發布,標示只給授權的紅隊作業用。
Q: 跑 RED-SNOW 一定要 DGX Spark 嗎?
不用。DGX Spark(GB10、128 GB 統一記憶體)可以跑 2-bit 單台版或 4.91 bpw 雙台版,但不是唯一選項。社群也有在 RTX Pro 6000(租用約一小時 1.5 美金)和 Apple Silicon MLX 上跑的版本。
Q: RED-SNOW 跟 Huihui 這類通用無護欄模型有什麼不同?
Huihui(abliterated Qwen)是通用無護欄模型(Uncensored Model),什麼都能做但不特別擅長資安。RED-SNOW 在消融之外多了 17,132 筆資安專用訓練資料的 fine-tune,85.8% 是攻擊性資安內容——它是為滲透測試(Penetration Testing)特化的紅隊模型(Red Team Model)。差別在訓練資料的深度,不只是護欄有沒有拆。
Q: 「授權紅隊」跟「用無護欄模型做壞事」的界線在哪?
三個字:你自己的。紅隊測試(Red Teaming)的核心是你對自己擁有的系統做攻擊模擬。Viktor 的案例很清楚:測的是自己做了 10 個月的 app、模型跑在自己桌上、結果不離開本地。用無護欄模型去探別人的系統,那是未授權入侵。
Q: 地端紅軍測試能取代專業資安團隊嗎?
不能,但能大幅降低專業掃描的發現數量。我之前幫朋友用 Huihui 做完紅軍測試後,他去找專業資安團隊做付費掃描,回來說被掃出的問題比想像中少很多。地端紅軍是「大考之前的模擬考」——先把明顯的洞補好,讓專業團隊把時間花在真正難找的問題上。