Codex 降智、Sol 6.1 慢、Astra 疑似量化:reset 再多也救不回來,因為算力就是智力
兩天前,我把大部分的 coding job 從 Codex 的 Astra 換到 Opus 5.5。
原因只有一個:太慢了。慢到是一週前的兩倍。
換過去之後,Opus 5.5 甚至可以後發先至:同一個 job,比 Astra 晚開始,比 Astra 早做完。
切換本身很簡單,因為我的 coding orchestration 機制已經做完整了,所以切過去沒什麼成本。真正讓我停下來想的是另一件事:我不是唯一一個在搬家的人。
10 月 15 日,一個叫 Robinson Honour 的開發者在 X 上發了這段:
“after this month i don’t think i’ll be subbing my codex again, their models seems to be getting dumber by the day.”
這個月結束就不續訂 Codex 了,模型一天比一天笨。
同一天,OpenAI Codex 負責人 Tibo 發了 28 天挑戰的 Day 11:加了算力,大幅減少「Selected model is at capacity」這個錯誤。底下有人直接回:
“Why codex or specifically 6.1 sol is feeling dumber today?”
一邊在加算力,一邊在問為什麼又變笨。這兩句話放在一起,是這篇要講的事。
30 秒定位
| 抱怨 | 代表說法 | 證據等級 |
|---|---|---|
| Sol 6.1 很慢 | 一個回應等 25 到 30 分鐘;個人 log 裡 15 個模型排最後 | 個人量測,沒有公開 benchmark |
| Codex 變笨 | “Can’t solve simple logic, takes for ever.” | 使用者體感 |
| Astra 疑似量化 | “Astra is quantized and nerfed instead” | 傳聞,OpenAI 沒有確認過 |
| Reset 救不回來 | reset 之後額度掉得快將近兩倍 | 個人觀察 |
| Pro 500 不值得 | “500$ plan 25x is just not worth it with its limits.” | 使用者評價 |
先講清楚:這張表裡沒有一項是嚴格量測。但五個方向的抱怨同時出現,指向的是同一個東西。
一、Sol 6.1:慢到不知道它是卡住還是在想
GPT-6.1 Sol 是 9 月 30 日 DevDay 發的,主打智力打到五分之一價。
Sol 系列的慢,在 6.1 出來之前就有人抱怨。9 月 29 日,Codex 的 GitHub 上有人開了 issue #49296,標題就叫「GPT-6-sol is extremely slow」。開 issue 的人是 Pro 20x 用戶,最後切回 gpt-5.6-sol。6.1 上線後,同一串有人貼出一次 GPT-6.1 Sol 跑 10 分 29 秒、每秒 15.2 token 的紀錄,10 月 9 日回來留言:「Terminated both subscriptions」。
9 月 30 日,J A Z I I 寫:
“tested model alot last night and it was super fast, but now it feels like the slowest model out there”
昨晚超快,今天像最慢的模型。
之後兩週有兩份比較像樣的個人數據:
- Harshith 量了 Codex 裡的 Sol:一般模式平均每秒 22 個 token、Fast 模式 43。同一個人量 Claude Code 裡的 Opus 5.5,一般模式 83 到 110、Fast 200 到 250。
- Tyler 叫 agent 翻自己的 log:從 8 月到 10 月初、大約 65,000 次呼叫、用過的 15 個模型裡,6.1 Sol 排最後。他自己標註:「Not a benchmark, just my real usage.」
最直接的描述來自 Connor Brewer,10 月 14 日。他說一個 session 等一個回應等了 25 到 30 分鐘,而且看不到模型在做什麼,不知道它是卡住了、往錯的方向跑了 30 分鐘,還是在寫一個傑作。
慢本身可以忍。看不到它為什麼慢,才是讓人抓狂的地方。
二、Codex 變笨,Astra 疑似量化
速度之外是品質。
Hemali Tanna 10 月 13 日:
“Codex is completely nerfed. Can’t solve simple logic, takes for ever. Pro plan feels useless.”
Gatsby.ts 10 月 14 日點名兩個模型:
“Codex 6.1-Sol and Astra have been getting worse over the past few days. … Burned through tokens all day hallucinating”
J.P Mishra 說同一個任務丟給 Claude,大約四分之一的時間做完。
Astra 的部分比較複雜。X 上一直有人說它被偷偷量化(Quantization,簡單講就是把模型權重壓成更少 bit,省記憶體、省算力,代價是精度),10 月 15 日 Vishnu 的說法最短:
“Astra is quantized and nerfed instead”
但要老實講:這類貼文讚數都很低,沒有一則拿得出證據。Grok 在 9 月 11 日的回覆寫得很中肯,發布一週後品質下滑的對比圖確實在流傳,但 OpenAI 從沒確認過量化、換模型或砍能力。
我覺得最值得看的一則,反而是 Astra 發布前五天的預言。Prabh 8 月 29 日寫:
“1-2 weeks of release something like q8 so we can all feel the AGI and then will drop down to q4-q6 quality.”
這是臆測,不是證據。但它說明了一件事:使用者已經把「發布兩週後變弱」當成預設劇本了。 還沒發布,就先預期它會變弱。這個信任赤字,比任何一次量化都難補。
三、Reset 再多,也救不回一個用不滿的模型
Tibo 10 月 4 日立了一個規則:
“Over the next 28 days, each day we’ll either ship one thing that is a clear improvement and relevant for most codex/work users or ship a full reset.”
接下來 28 天,每天要嘛出一個明確的改進,要嘛把大家的額度全部重置。
Day 1 把 Astra 跟 Sol 的預設速度調快約 50%,Tibo 自己的說法是從每秒 30 token 到 50。之後依社群整理,前 11 天裡有 5 天是 reset。Day 10 的 reset 貼文拿了一萬六千個讚,隔天宣布加算力的 Day 11 是 8,605 個。
問題是 reset 解決的是「額度不夠」,可是大家抱怨的是「模型不好用」。
10 月 15 日 reset 落地之後,Codex Tracker 說同樣的模型、同樣的工作量,reset 之後額度掉得快將近兩倍。另一個極端是 Satyam:
“Because of Tibo resets, I’m unable to utilize the Codex usage.”
reset 太頻繁,他根本用不完。
這兩則放在一起看很有意思。一個人覺得燒太快,一個人覺得用不完。但兩種人碰到的是同一件事:一個又慢又笨的模型,額度不是瓶頸。 每個回應要等 30 分鐘,一天能跑幾輪?做一半就停下來說做完了,給再多額度也只是多幾次重來的機會。
額度是時間的上限,算力才是時間裡能做多少事。reset 給的是前者。
四、買了 $500,能換到一個沒被量化的 Astra 嗎?
DevDay 推出了 $500 的 Pro 500,多篇整理寫是 25 倍 Plus 用量,外加 Ultrafast。
這兩週 X 上對它的評價很一致。Moriarty 10 月 13 日:
“500$ plan 25x is just not worth it with its limits. 10x also.”
embw_l0x 給了另一種 $500 的花法:兩個 $200 的 Claude Code,加一個 $100 的 Codex 只拿來做 review。同一週 Theo 那則拿了 4,826 個讚:
“The $200 Claude Code sub is one of the best values in software right now.”
但我想問的不是值不值得,是一個更根本的問題:$500 買到的是更多額度、更快的速度,有沒有任何一個方案,保證你拿到的是發布那一天的 Astra?
沒有。我查到的 Pro 500 整理裡沒有這一條,其他家的訂閱方案也沒有。你可以付錢買倍數、買 Ultrafast、買 Dots,唯獨買不到「明天的 Astra 跟今天一樣」。
五、這個循環,我們已經看過了
把時間拉長,這不是 OpenAI 一家的事。
9 月 7 日我寫 Anthropic vs OpenAI 算力對決的時候,開場講的是 Fable 5:剛出來多強,用了一陣子很多人覺得變弱了,很有可能不是模型降級,是推理需求暴增,電跟不上。Anthropic 過去十一個月簽了至少 14.8 GW,是在補這個洞。
然後劇本換到 OpenAI:
- 9 月 3 日,GPT-6 Astra 發布,驚艷大家
- 9 月 10 日,OpenAI 暫停 $200 Pro 新訂閱,同時 X 上已經有人說 Astra 變慢變笨,Tibo 當時否認智力被削弱
- 9 月 30 日,DevDay 發布 Sol 6.1,五分之一價,大家轉過去
- 10 月,Sol 6.1 慢、Astra 被懷疑量化、使用者回頭找 Claude
Elaina 當時那句話,現在看幾乎是整個循環的摘要:
“We went from an astonishing Astra launch to degradation, limits, overload, and paused subscriptions in a matter of days.”
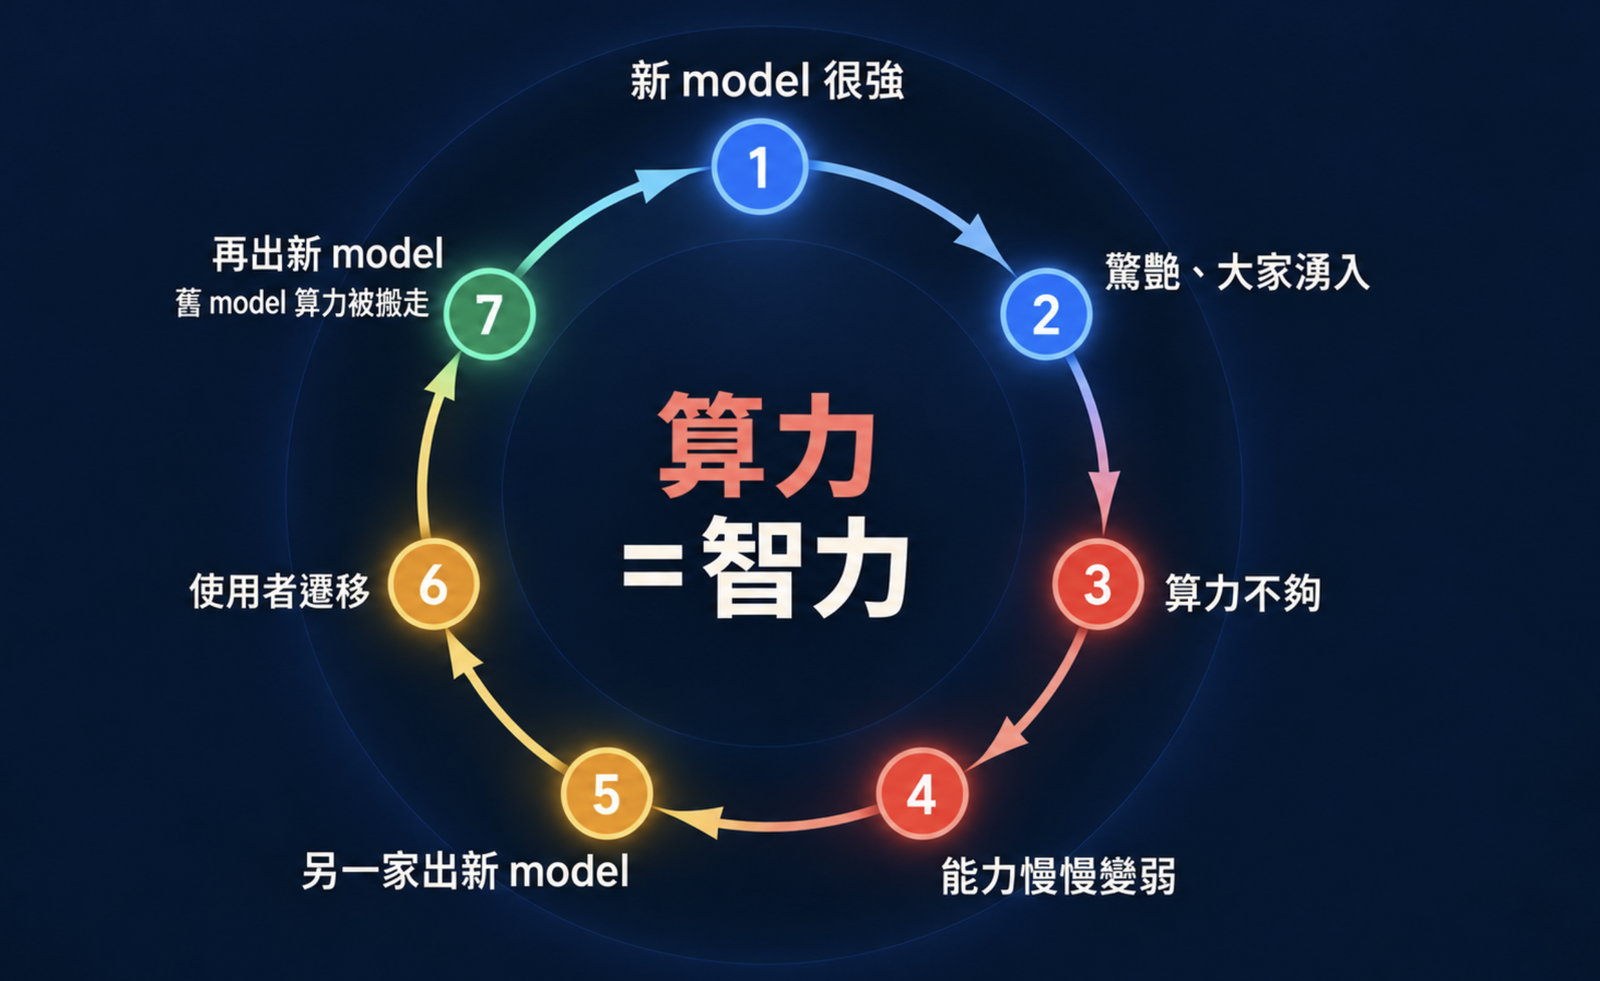
把它畫成一個圈:
- 新 model 很強
- 驚艷大家,很多人湧入
- 算力不夠,能力慢慢變弱
- 另一家出新 model,再驚艷一次
- 大家遷移過去
- 原廠只好再出一個新 model,把舊 model 的算力移過去,舊 model 徹底被廢掉
然後回到 1。
我們已經厭倦這樣的循環了。
六、算力就是智力
這整件事的根因只有一個:算力不足。
這不是比喻。在推理端,「算力 = 智力」是字面上的意思。
最直接的證據是 effort 設定。Jacob Beers 說他把 Sol 的 effort 從 Max 降到 Medium,理由是速度跟成本的差距,值得犧牲一點智力。同一個模型、同一組權重,給它想得久一點就比較聰明,給它想得短一點就比較笨。reasoning effort 本身是一個「用算力換智力」的旋鈕。
那廠商後台有沒有同樣的旋鈕?當然有,而且不只一個:
- 量化幾 bit
- 預設的 reasoning 長度
- 每張卡同時塞多少個 request(batch size)
- 速度優先還是品質優先
Day 1 那個「預設速度快 50%」怎麼做出來的,Tibo 沒講細節。但不管用哪種方法,都是在動這些旋鈕。Day 11 說得更直白:「more compute」。
所以我一直覺得,算力儲備才是雲端大廠真正的護城河,不是模型。Google 把 TPU 賣給競爭對手那篇的結論是:模型的營收天花板可見,算力的需求上限不可見。這一個月的 Codex 把後半句演了一遍:需求一湧進來,算力撐不住,智力就跟著往下掉。
再補一個帳面上的角度。巴克萊拆帳那篇算出來,推理毛利一年跳到 65%,量化(Quantization)是壓低推理成本的手段之一。毛利率是財報上的好消息,換到使用者這端,意思是每個 request 分到的算力被精打細算過。
縮水式通膨
我覺得最貼切的類比是縮水式通膨(shrinkflation)。
洋芋片一包還是同樣價錢,包裝一樣大,裡面的洋芋片變少了。廠商沒有說謊,包裝上寫的克數是對的,只是你沒注意到它改過。
$200 還是 $200,模型名字還是 Astra,裡面每個 request 分到的算力變少了。
所以使用者的懷疑是有道理的:也許今天的 Astra,能力差不多等於過去的 GPT-5.5。 不是權重變回 5.5,是後台把算力調到差不多的位置,解題能力也就落在差不多的位置。X 上 zuphr1n 的說法是「even astra feels lobotomized compared to 5.5」;更早之前,Flask 作者 Armin Ronacher 也說過 Astra 很驚艷,但做軟體工程他退回去用 5.6。
這個假說我沒辦法證明。但它解釋了一件事:為什麼每一代新模型發布時都比上一代強很多,用了一個月後,體感卻總是落回差不多的地方。
七、反方:也許降智只是感覺
這段要認真寫,因為反方很強。
第一,蜜月期效應。 新模型剛出來,大家拿它做最擅長的事,覺得驚艷。用久了開始丟各種邊角任務,失敗率自然變高。不是模型變笨,是你的期待變高了。
第二,設定差異。 上面那則 Max 降 Medium 是一個例子,很多抱怨沒有附上 effort 設定。也有人反駁 Tyler 那張圖:DeepSeek 這種模型同一個任務吐的 token 多很多,比「等多久」不公平,應該比「每秒完成幾個任務」。DevDiary 就說他開 extra high 用起來還行。
第三,就算真的變差,也不一定是故意的。 這有前例。2025 年 9 月,Anthropic 發過一篇 postmortem,承認那段時間 Claude 的品質確實掉了,原因是三個基礎設施 bug,最糟的一小時有 16% 的 Sonnet 4 請求被送錯伺服器。他們在同一篇裡寫:
“To state it plainly: We never reduce model quality due to demand, time of day, or server load.”
使用者感覺到的降智是真的,原因卻不是使用者猜的那個。
這三點我都接受。但它們推不翻主論點,反而補強了一件事。
同一篇 postmortem 裡還有一句:
“The evaluations we ran simply didn’t capture the degradation users were reporting”
連廠商自己的 eval 都抓不到品質下滑,使用者更不可能抓到。 不管是故意量化、是 bug、還是算力被稀釋,在使用者這一端看到的結果都一樣:同一個模型名字,今天跟上週不是同一個東西,而你沒有任何工具可以確認。
所以問題不是「OpenAI 有沒有偷偷量化」。這題我們回答不了,可能永遠回答不了。問題是:你的工作流能不能建立在一個不可重現、不可稽核的東西上面?
八、到頭來,地端還是最穩定的解
講地端之前,先把話講清楚:地端不會比較聰明。
我 10 月 9 日到 14 日在兩台 DGX Spark 上輪流跑了三個 Flash 模型,品質題庫都在 94 到 97.67 分之間,打不過 Astra,也打不過 Sol 6.1 的巔峰狀態。
而且地端一樣受「算力 = 智力」這條定律管。同一次測試裡,一個人用最快的 DeepSeek,八個人同時用時變成最慢的。Strata 能把 MoE 塞進遊戲顯卡,靠的也是 IQ3 量化。地端也在量化,也會因為人多而變慢。
差別在於:量化是你自己選的,你知道它是 IQ3;人多變慢,你看得到是八個人在用。
地端「穩定」的真正意思在這裡。不是不會變慢,是你看得到儀表:
- 你知道它是幾 bit
- 你知道今天跟上週跑的是同一個檔案
- 你知道它慢是因為幾個人在用
- 明天早上打開,它跟今天一樣
雲端給的是一個比較聰明、但會在你不知道的時候縮水的模型;地端給的是一個沒那麼聰明、但不會偷偷改變的模型。對 demo 來說前者比較好。對要天天跑的 production 工作流,可預測性比巔峰智力更值錢。
代價當然有。RTX 5090 從 5 月的 10 萬漲到 10 月 1 日的 22 萬,而且還買不到。大家都想通了同一件事,硬體就跟著漲。
坦白說
這篇的證據大部分是 X 上的個人貼文跟一個 GitHub issue。Tyler 跟 Harshith 的數字是個人量測,不是公開 benchmark;「Astra 被量化」到今天為止仍是傳聞,OpenAI 沒有承認,我也拿不出證據。X 上抱怨的人本來就比滿意的人更會發文,這個樣本有偏差。
「今天的 Astra ≈ 過去的 GPT-5.5」是一個假說。要驗證它,需要同一組固定題目在不同日期重跑,我手上沒有這份數據。
也有反例:10 月 15 日 Deependra Solanky 說前一天超慢、今天正常了。Tibo 的 Day 11 可能真的改善了一部分。這篇寫的是過去兩週的狀態,不保證兩週後還成立。
地端那段,我的測試是兩台借來的 DGX Spark、三個 Flash 模型,八個人以內的同時使用。它證明的是「可預測」,不是「夠用」。很多任務地端模型做不了,還是得回到雲端。
我自己的「兩倍慢」也一樣。那是我自己跑 job 的觀察,不是控制變因的實驗。而且 Opus 5.5 現在快,不代表它不會走進同一個循環——Fable 5 就走過一次。我搬過去,是換到循環裡目前比較順的那一格,不是跳出循環。
但這篇做對了一件事:把「最近好像變笨了」這種模糊感覺,對回同一個循環和同一個根因。下一次新模型驚艷大家的時候,你大概已經知道一個半月後會發生什麼事。
關鍵洞察
reset 解決的是額度,不是智力。 判斷一個訂閱值不值得,先看模型這週的速度跟品質,不是看倍數。又慢又笨的模型,25 倍也用不滿。
沒有任何方案賣「明天跟今天一樣」。 付再多錢買到的是額度和速度,不是固定的算力分配。工作流要是依賴雲端模型的巔峰狀態,就要接受它隨時會縮水。
能換,比換到哪一家重要。 我這次從 Astra 搬到 Opus 5.5 沒什麼成本,是因為 coding orchestration 早就做完整了。下一輪循環輪到哪一家變慢,誰也猜不到;底層模型可以隨時抽換的人,每一輪都能站在比較順的那一邊。
留一個你看得到儀表的基準。 一台地端機器,或一組固定題目每週重跑。不是為了取代雲端,是為了在雲端縮水的時候,你有東西可以比、有地方可以退。
新模型發布的那一刻,就把一個半月後的劇本算進去。 驚艷期是真的,但它不是穩態。
常見問題 Q&A
Q: Codex 最近真的降智了嗎?
沒有官方承認,也沒有公開 benchmark 證明。證據來自使用者:2026 年 10 月 X 上大量抱怨 Codex 和 GPT-6.1 Sol 變笨、變慢,GitHub 上 openai/codex 的 issue #49296 有 Pro 20x 用戶說 Sol 慢到切回 gpt-5.6-sol;一位使用者分析自己 8 月到 10 月初約 65,000 次呼叫,在 15 個模型裡 Sol 6.1 最慢。這些是個人量測,不是嚴格實驗,但方向一致。
Q: 為什麼說「算力 = 智力」?
在推理端這是字面意思。同一組權重,推理努力程度(Reasoning Effort)調高就比較聰明、調低就比較笨,effort 設定本身是用算力換智力的旋鈕。廠商後台還有量化(Quantization)位元數、預設推理長度、批次大小(Batch Size)等旋鈕。需求暴增而算力沒跟上時,每個請求分到的算力變少,使用者感受到的就是「降智」。
Q: 降智一定是廠商故意量化模型嗎?
不一定。2025 年 9 月 Anthropic 發布 postmortem,承認 Claude 品質下滑是三個基礎設施 bug 造成的,最糟的一小時有 16% 的 Sonnet 4 請求被送錯伺服器,並聲明從不因需求或伺服器負載降低模型品質。同一篇也承認內部評測沒抓到使用者回報的下滑。所以故意與否很難判斷,但使用者端結果相同:同一個模型名字,品質不可重現、也無法稽核。
Q: ChatGPT Pro 500 能解決 Codex 變慢變笨的問題嗎?
不能保證。Pro 500 是每月 $500,依多篇整理為 25 倍 Plus 用量並附 Ultrafast 速度,買到的是額度和速度,沒有任何條款保證你拿到的模型品質固定。2026 年 10 月 X 上不少重度用戶認為不值得,常見替代配置是兩個 $200 的 Claude Code 方案加一個 $100 的 Codex 方案只用來做程式碼審查。
Q: 地端模型比雲端模型好嗎?
地端模型通常沒有雲端旗艦模型聰明,也一樣會因量化和多人同時使用而變慢。它的優勢是可預測:量化等級(例如 IQ3)是你自己選的,今天跟上週跑的是同一個檔案,變慢時你看得到原因。適合需要天天穩定執行的生產工作流(Production Workflow)當基準和備援;需要最高智力的任務仍要用雲端。
來源
- Robinson Honour:https://x.com/honour_can_code/status/2110727703296880935
- Tibo,28 天規則:https://x.com/thsottiaux/status/2106845241357824205
- Tibo,Day 1:https://x.com/thsottiaux/status/2107158998495748264、https://x.com/thsottiaux/status/2107159119107146237
- Tibo,Day 10:https://x.com/thsottiaux/status/2110595484180214059
- Tibo,Day 11:https://x.com/thsottiaux/status/2110750421367287996
- Dev__F:https://x.com/Dev__F/status/2110750533879546326
- openai/codex issue #49296:https://github.com/openai/codex/issues/49296
- Tyler 個人 log:https://x.com/btsouth/status/2106716850130399672
- Harshith TPS 量測:https://x.com/HarshithLucky3/status/2106393718777577671
- 社群整理 Day 1–11:https://x.com/gadi_neelesh/status/2110757266492399743
- Codex Tracker:https://x.com/CodexResets1/status/2110702087507988741
- Prabh:https://x.com/arora2992/status/2093797586217980104
- Grok 回覆:https://x.com/grok/status/2098401893168845205
- Anthropic postmortem(2025-09-17):https://www.anthropic.com/engineering/a-postmortem-of-three-recent-issues