Git 為什麼撐不住每天 3 萬次合併?拆開 git 的三個設計假設,看 Anthropic 和 Google 怎麼繞過去
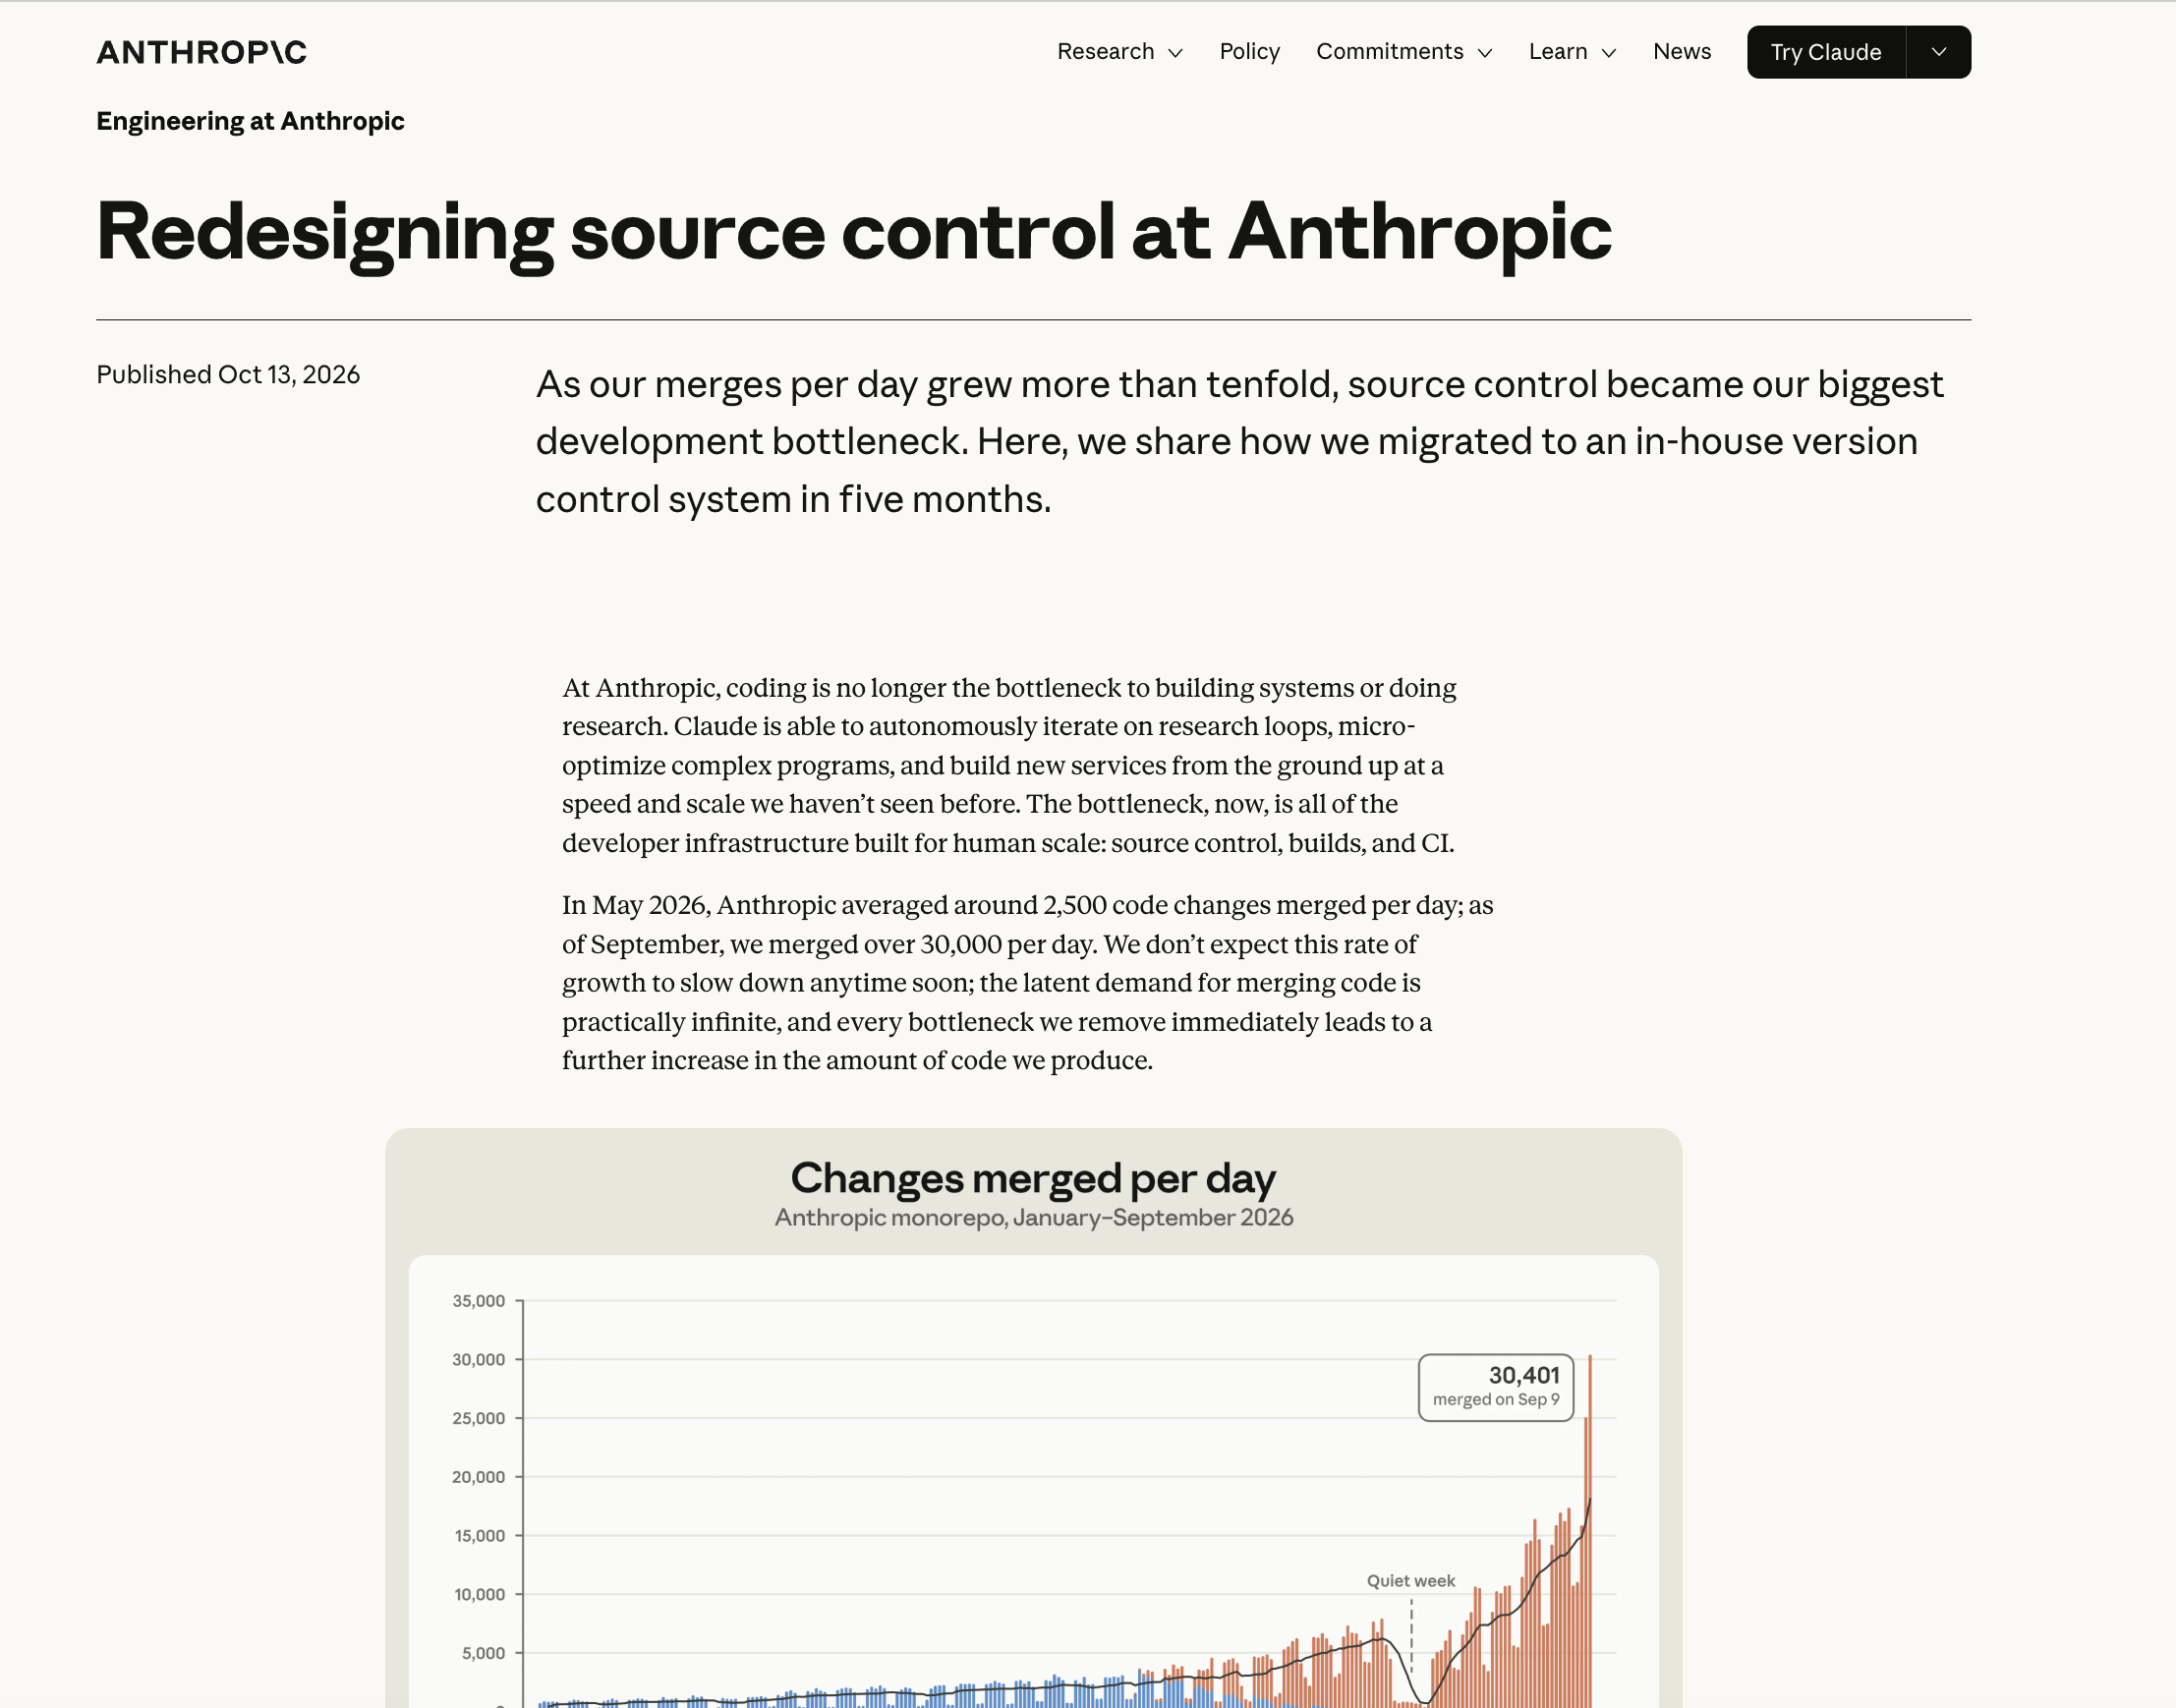
10 月 13 日,Anthropic 在工程 blog 貼了一篇 Redesigning source control at Anthropic。
他們的 monorepo,五月每天合併約 2,500 筆變更,九月每天超過 30,000 筆。四個月,約十二倍(原文的說法是超過十倍)。
七個人、五個月,他們自己寫了一套版本控制系統叫 Scion,把整個 monorepo 從 git 搬走。
社群吵的是「誰讀得完 3 萬個 diff」。我比較想回答另一個問題:git 到底是哪裡撐不住?
git 是多數工程師每天都在用的工具。說它在某個量級撐不住,要講得出是哪個機制、在哪個數字、為什麼繞不過去。這篇就做這件事,然後並排看 Anthropic 和十年前的 Google 各自怎麼解。
先講清楚素材:Scion 的數字全部是 Anthropic 自述,沒有第三方驗證,Scion 也沒有開源。Google 的部分來自 2016 年 Communications of the ACM 的論文。git 的機制我引用 git 官方文件。
30 秒定位
| 項目 | 內容 |
|---|---|
| 來源 | Anthropic Engineering blog,10 月 13 日,Redesigning source control at Anthropic |
| 合併量 | 五月每天合併約 2,500 筆,九月每天超過 30,000 筆 |
| Repo 規模 | main 的歷史將近 100 GB,壓縮後的 working copy 超過 25 GB |
| 讀取量 | CI 每天約 2,500 萬次 checkout;照 git 的方式整包抓,一天超過 600 PB |
| 試過的繞路 | shallow clone、sparse checkout、promisor remote、seed 快照,高峰期數百台內部 git mirror |
| 新系統 | Scion(版本控制)加 Antique(code review),七個人、五個月完成遷移 |
| 自述成果 | 基礎設施的 CPU 與記憶體需求縮小 200 倍;checkout 從分鐘級變成秒級;CI 省下 25% 的 CPU |
| 前例 | Google Piper(2016 年論文公開)、Meta Sapling,原文自己列為 prior art |
git 當初是為誰設計的
要講 git 為什麼撐不住,先看它當初要解決什麼。
2005 年,Linux kernel 社群跟 BitKeeper 的公司鬧翻,免費授權被收回。kernel 社群只好自己寫一套。Pro Git 列了當時的設計目標:
- Speed
- Simple design
- Strong support for non-linear development (thousands of parallel branches)
- Fully distributed
- Able to handle large projects like the Linux kernel efficiently (speed and data size)
翻成場景:全世界的貢獻者各自在自己電腦上寫,可能在飛機上、可能沒網路,寫完再用 patch 或 pull 的方式交給 maintainer 合併。
從這個場景長出三個設計假設。
假設一:commit 是整棵樹的快照,main 是一條線。
“every time you commit, or save the state of your project, Git basically takes a picture of what all your files look like at that moment and stores a reference to that snapshot.”
每次 commit,git 都替所有檔案拍一張當下的照片,存一個指向這張快照的參考。
每個 commit 指向它的 parent。main 就是一個指標,指著最新那張快照。
假設二:每個 clone 都是完整副本。
clone 下來的不是最新版,是整個歷史。這是「離線也能工作」的前提。
假設三:運算在 client 本機做。
“Because you have the entire history of the project right there on your local disk, most operations seem almost instantaneous.”
因為整個專案歷史就在你的硬碟上,多數操作幾乎是瞬間完成。
diff、blame、log、切版本,全部在本機算,不用問 server。
對 2005 年的 kernel 社群,這三個假設全部正確。Anthropic 原文也是這樣說的:
“For the vast majority of repositories, this is the right design”
對絕大多數 repo,這是對的設計。
問題是,當 client 從「會離線的人」變成「永遠在線、跑完就消失的 job」,光 CI 一天就 checkout 約 2,500 萬次,加上每天 30,000 筆合併,這三個假設各自撞到一面牆。
第一道牆:寫入——main 只能一條線往前
先看寫入。
git 的 main 只接受 fast-forward 更新。意思是你要 push 的 commit,它的祖先裡必須包含 main 現在指的那個 commit。git push 文件寫得很清楚:
“The command by default does not allow an update that is not a fast-forward to prevent such loss of history.”
push 預設不允許非 fast-forward 的更新,避免歷史遺失。
被拒絕之後怎麼辦?文件給的流程是先 fetch,再 merge 或 rebase,然後重新 push。
一個人一天 push 幾次,這個流程無感。
換成每天 30,000 筆。平均不到三秒一筆。
假設合併前的測試跑 10 分鐘(這是我假設的數字,原文沒給),這段時間 main 已經往前走了大約 200 筆。你測完要 push,main 早就不是你測試時的那個 main。被拒絕,rebase,重測,再 push,這時 main 又往前走了 200 筆。
這是一場在 client 端進行、永遠追不上的賽跑。
業界的標準解法是 merge queue:不讓每個人自己搶 main,改成排隊,server 一次放一筆(或一批)進去,測過才放下一筆。它靠的是一把全域鎖。
Anthropic 原文直接說,這把鎖他們複製不了:
“We haven’t been able to effectively replicate the industry standard of a global repository lock on the merge queue”
我們沒辦法有效複製業界標準的做法:在 merge queue 上加一把全域的 repo 鎖。
寫入端還有一個比較少人注意的成本:ref。
每個 agent 開一條 branch,ref 數量就跟著 agent 數量長。Anthropic 原文說 Scion 除了 main 和 release branch 之外不鼓勵 ref,理由是:
“global state that every server has to agree on is a looming scaling problem.”
每台 server 都要同意的全域狀態,是一個正在逼近的擴展問題。
git 的設計目標裡有一條是「thousands of parallel branches」。在 agent 的量級,branch 本身變成要管理的全域狀態。
第二道牆:讀取——每個 clone 都是整包
寫入的牆還能用 queue 擋一陣子。讀取的牆更大。
Anthropic 的 main 歷史將近 100 GB,壓縮後的 working copy 超過 25 GB。CI 每天約 2,500 萬次 checkout。照 git「每個 clone 都完整」的方式抓,一天超過 600 PB。
把兩個數字相除:2,500 萬次 checkout 對 3 萬筆合併,大約 830 次。
這個比值要加但書。兩個數字不一定是同一個月份,裡面包含沒合併成功的變更和重跑的 job,不能讀成「一筆變更固定跑 830 次」。而且原文說這 2,500 萬次只算 CI,開發環境、agent sandbox、研究任務都還沒算進去。但量級夠清楚:每多一筆寫入,後面跟著幾百次讀取。
換成日常場景。CI job 要查一個函式最後是誰改的。git 的做法是先把 repo 連同歷史抓下來,再在本機跑 git blame。對一台筆電上的工程師,這很合理:抓一次,之後在高鐵上沒網路也能查。對一個跑完就消失的 CI job,這等於為了查一行字,先搬一次家。
Anthropic 原文的判斷是:
“like most companies, we were using git as a centralized system with one authoritative copy, but nearly all of our clients were agents and jobs that are online by definition.”
我們跟多數公司一樣,把 git 當中心化系統在用,只有一份權威副本。但幾乎所有 client 都是 agent 和 job,它們本來就一直在線上。
git 為離線付的成本,沒有人在用。原文用的詞是這些離線假設 “actively undermining our ability to scale as the repo grew”,隨著 repo 變大,主動在扯後腿。
第三道牆:運算在 client——每個 job 都自己算一次歷史
第三個假設的代價最容易被忽略:git client 的工作量,跟 repo 的大小成正比,不是跟你實際碰到的檔案成正比。
這面牆 Anthropic 原文沒有給細部數字。但 Microsoft 在 2017 年公開過一組,剛好可以補上。
Microsoft 把 Windows 的程式碼搬到 git 時,官方 blog 寫的規模是:超過 350 萬個檔案、超過 270 GB。用原生 git 操作,clone 要 12 小時以上,checkout 最久 3 小時,連 git status 都要將近 10 分鐘。
git status 只是問「我改了哪些檔案」,卻要 10 分鐘,因為 git 要掃過整棵 working tree。
Microsoft 的解法是 GVFS(Git Virtual File System):檔案看起來都在,實際上第一次打開才下載。結果 clone 變幾分鐘、checkout 30 秒、status 4 到 5 秒。
注意這個解法的方向:它保留了 git 的指令,但把「每個 clone 都完整」這個假設拿掉了。
Anthropic 碰到的是同一類問題的另一個面向。blame 和 diff 要讀歷史,歷史不在本機就算不出來。原文說,為了讓 diff 和 blame 在 partial clone 上繼續能用,要花的心力越來越多。
為什麼繞路越來越難:所有 workaround 都是快照
Anthropic 不是沒努力。git 能用的招他們都用了:shallow clone、sparse checkout、promisor remote、把 repo 快照(seed)放在 blob storage,高峰期養了數百台內部 git mirror。
然後原文描述了這些繞路怎麼一個個失效:
“Seeds fell further from the tip of main between refreshes”
每次刷新之間,seed 離 main 的最新點越來越遠。
“they became harder to operate as our merge rate increased.”
合併速度越快,mirror 越難維運。
“it took more and more care to keep operations that depend on history, like diff and blame, working on partial clones.”
要讓 diff、blame 這種依賴歷史的操作在 partial clone 上繼續能用,要花的心力越來越多。
這三句話背後是同一個結構:每一個繞路,都是 main 在某一刻的快照或副本。
seed 是某一刻的快照。mirror 是某一刻的副本。shallow clone 是砍掉歷史的副本。main 走得越快,這些副本跟真相之間的距離就拉得越開,要花越多力氣把距離補回來。
每天 2,500 筆的時候,副本落後一小時,差一百多筆。每天 30,000 筆的時候,同樣一小時,差一千多筆。繞路的維護成本跟著合併速度一起長。
這就是「大量 commit 下 git 無法維持」的完整答案:
- 寫入在 client 端搶一條 main,合併速度一快就追不上。
- 讀取要整包搬,讀取次數是寫入的幾百倍。
- 運算在每個 client 上重做一次,成本跟 repo 大小成正比。
- 所有繞路都是快照,main 越快,快照越快過期。
前三個是假設撞牆,第四個是你沒辦法靠加機器把牆推遠。
Anthropic 怎麼做:Scion 換掉三個假設
原文列了六條設計原則。對回 git 的三個假設:
| git 的假設 | Scion 的做法 | |
|---|---|---|
| 寫入 | client 本機 commit,push 時搶 fast-forward | changeset 在 server 端建立;移動 ref 是 Spanner 上單一列的 compare-and-swap,跟建立 changeset 分開 |
| 讀取 | 每個 clone 都完整 | client 永遠在線,要用再抓;working copy 可以沒有,要的話是 sparse 或 virtualized |
| 運算 | diff、blame 在本機算 | history、blame、commit、merge、rebase 全部在 server;全部開成 API,很多 job 根本不需要 repo |
| Ref | branch、tag 是日常 | 除了 main 和 release branch 之外不鼓勵 |
幾個細節值得拆開看。
寫入變便宜。 Scion 的工作單位叫 changeset,是 write-ahead log 裡的一筆。git 的 commit 指向整棵樹的快照;changeset 只記「相對於 first parent 改了哪些檔案」,外加指向 blob storage 的 content-addressed 指標。原文的描述是:
“there are no packfiles to accept, no locking or cross-server coordination, and no refs to move around.”
沒有 packfile 要收,沒有鎖、沒有跨 server 協調,也沒有 ref 要搬。
歷史變成衍生資料。 changeset 只記改了什麼,沒辦法直接回答「這行最後誰改的」。所以 blame、路徑歷史、commit graph 的 skip list,都是從 changeset 遞迴算出來的 derived data,可以選擇預先算或延後算。算一次,所有 client 共用,不再每個 job 各算一次。
讀取變成按需。 fetch 時只協商 client 要的那些 tree 和 blob,先遞迴抓缺的 tree,再抓 blob,請求可以續傳。原文特別寫了一句 “there is no single multi-gigabyte packfile response”,不會有一個幾 GB 的 packfile 一次砸回來。
快照問題用 content-addressed 解掉。 讀取端是三層快取:節點上的 scion-daemon,區域的 scion-cache,最上面是權威的 scion-server。所有資料都是 content-addressed,一個物件存進去就不會變,任何一層快取都能直接回答,不會「過期」。這正好對上前面那個結構問題:seed 和 mirror 會過期,是因為它們存的是「main 在某一刻長怎樣」;content-addressed 的物件存的是「這段內容長怎樣」,不會因為 main 往前走而失效。原文說每一層命中率超過 99%。
寫入的搶 main 問題,改用放棄全域鎖來解。 這是 Scion 最激進的一步。Anthropic 不再保證 main 每一刻都是綠的,改投資 post-merge 和 pre-deploy 的自動化測試。同時合併的變更會互相衝突,原文的說法是 Claude 修這些衝突的速度,通常比人類發現它們還快。
要講精確一點:原文沒有說合併前完全不測,文中還提到有一隻專門盯 Antique merge queue 的 Claude,所以某種形式的 queue 還在。被放棄的是「全域鎖、嚴格排隊」這個保證。
審查端,Antique 可以表達語意層級的核准規則,把「只改註解」和「動到敏感邏輯」分開,再加上目錄層級的權限,讓敏感程式碼留在同一個 monorepo 裡也有保護。
成果(自述):基礎設施的 CPU 與記憶體需求縮小 200 倍,checkout 從分鐘級變成秒級,CI 省下 25% 的 CPU。
Google 怎麼做:Piper、CitC 和一條 trunk
Anthropic 這套架構不是新發明,原文自己把 Google 的 Piper 列為 prior art。Google 在 2016 年的 Communications of the ACM 發過一篇 Why Google Stores Billions of Lines of Code in a Single Repository,把整套做法寫得很完整。
先看規模(2015 年 1 月的統計):約 10 億個檔案、約 3,500 萬次 commit、86 TB、約 20 億行程式碼。超過 25,000 名開發者,每個工作日人提交 16,000 筆、自動化系統提交 24,000 筆。讀取尖峰約 80 萬 QPS,工作日平均約 50 萬,多數來自 build-and-test 系統。
Google 為什麼不用 git。 論文裡有一段直接回答:
“A Git-clone operation requires copying all content to one’s local machine, a procedure incompatible with a large repository.”
git clone 要把所有內容複製到本機,這跟大型 repo 不相容。
要搬到 git,就得把 repo 拆成數千個小 repo。Google 用 git 的 Android 就拆成 800 多個 repo。Google 判斷拆 repo 不划算。論文也說,他們實驗了好幾年,找不到任何商用或開源的版本控制系統撐得住這個規模。
所以 Google 走了另一條路,同樣是一個一個換掉 git 的假設。
Piper:server 是唯一真相。 Piper 先建在 Bigtable、後來搬到 Spanner,分散在 10 個資料中心,用 Paxos 保持副本一致。在 Piper 之前,Google 用一台單機 Perforce 加自建快取,撐了十年以上。1999 年從 CVS 搬到 Perforce 時就選了單一 repo,之後沒有改過。
CitC:working copy 不用複製。 多數 Google 工程師透過 CitC(Clients in the Cloud)使用 Piper。CitC 是一個 FUSE 檔案系統:工程師看到的是整個 Piper repo,自己改過的檔案疊在上面。workspace 只存改過的檔案,平均一個 workspace 不到 10 個檔案。超過 80% 的 Piper 使用者用 CitC。論文也寫明了代價:
“gaining the full benefit of Google’s cloud-based toolchain requires developers to be online.”
要拿到 Google 雲端工具鏈的完整好處,開發者必須在線。
這跟 Anthropic 的「client 永遠在線」是同一個假設,只是早了十年。
Trunk-based development:main 由 server 排序。 Google 的變更是這樣進 repo 的:
“Changes are made to the repository in a single, serial ordering.”
變更以單一的序列進入 repo。
注意,Google 也是一條線。差別在排序發生在 server 上,不是讓每個 client 自己 fetch、rebase、搶 push。Branch 在 Google 很少見,主要是 release branch:從某個版本切出來,修正先進 mainline,再 cherry-pick 過去。新功能不開 branch,用設定 flag 讓新舊路徑並存。
閘門放在哪裡。 Google 的做法是兩段:
- 合併前:所有程式碼合併前都要有人審過。每個目錄有 owners,決定改動能不能進來。Critique 是 code review 工具,presubmit 跑自動測試和分析,Tricorder 做靜態分析。
- 合併後:幾乎每筆 commit 都會觸發重建所有受影響的相依;如果某筆變更造成大範圍 build 壞掉,系統自動把它撤掉。
大規模重構另外有 Rosie:把一個橫跨整個 repo 的大 patch,沿著目錄邊界拆成小 patch,分別測試、送給對應的 owners 審、通過後自動提交。
機器 commit 比人多,十年前就發生了。 論文寫,2012 年換成自建系統之後,自動化的 commit 開始往上長,之後的成長主要來自自動化。到 2015 年,每天 40,000 筆裡有六成是機器提交的。
兩家並排:換掉的假設一樣,閘門不一樣
| git | Google Piper(2016 年論文) | Anthropic Scion(2026 年自述) | |
|---|---|---|---|
| 每日變更 | — | 人 16,000 筆+自動化 24,000 筆(每工作日) | 超過 30,000 筆 |
| 誰排 main | client 搶 fast-forward | server 單一序列 | server 端 compare-and-swap |
| Working copy | 完整副本 | CitC 疊加層,平均不到 10 個檔案 | 可以沒有;要的話 sparse 或 virtualized |
| 歷史運算 | 每個 client 本機算 | server 端,配 CodeSearch 等工具 | server 端,blame 等是 derived data,全部開 API |
| Branch | 日常 | 很少,主要是 release branch | 除了 main 和 release branch 之外不鼓勵 |
| Client 假設 | 可能離線 | 要在線 | 永遠在線 |
| 合併前閘門 | 看團隊 | 所有程式碼都要人審+owners+presubmit | 人看意圖+語意核准規則;不做全域鎖 |
| 合併後閘門 | 看團隊 | 重建受影響相依,大範圍壞掉自動撤回 | post-merge、pre-deploy 測試,Claude 修衝突 |
上半張表,兩家答案幾乎一樣:server 做運算、client 按需取檔、main 由 server 排序、branch 盡量少。這不是巧合,是同一組 git 假設在同一種負載下撞牆,解法自然收斂。
下半張表才是差異。
Google 2016 年還守著「合併前每筆都有人審」。這在每天 16,000 筆人提交的規模撐得住,因為審的人也是 25,000 名開發者。Anthropic 的合併量裡,人已經不是提交的主體,「每筆都讀」守不住,所以改成人看意圖、規則分級、全域鎖放掉。
這修正了我二月寫的那篇 Make CI/CD Great Again。
二月那篇的論點是:只有機器的高速能匹配 AI 的高速,你的 test 有多硬,AI 就能跑多快。這個論點我認為還成立。但那篇默認閘門的位置在合併前。
Google 的論文提醒我,合併後的自動撤回早就是大規模 monorepo 的標配,不是 Anthropic 發明的。Anthropic 做的是把重心整個往後移:合併前的鎖拿掉,靠合併後和部署前接住。
所以那句話要補一半:你的 test 有多硬,加上你的 revert 有多快。
網友吐槽「這不就是 SVN」:對,這正是重點
Hacker News 那一串,到我 10 月 15 日查的時候 861 分、959 則留言。很多吐槽是同一句話的變體:
“So… Anthropic reinvents SVN?”
另一則講得更完整:
“So it’s a SVN/Perforce style server based VCS with a more modern design.”
所以這是 SVN、Perforce 那種以 server 為中心的版本控制,只是設計比較現代。
X 上也有人酸:”So they invented working on the main with ftp?”
這些吐槽都對。把它們跟前面的分析放在一起看,可以看出比吐槽本身更有意思的東西。
版本控制繞了一圈。 Google 自己的歷史是一條完整的路線:1999 年從 CVS 搬到 Perforce,單機 Perforce 撐了十年以上,再換成自建的 Piper。從頭到尾都是中心化。git 在 2005 年把世界推向分散式,是因為當時的 client 是會離線、各自開 branch 的人。現在 Anthropic 的 client 變成永遠在線的 job,鐘擺又擺回中心化。
決定往哪邊擺的不是技術潮流,是 client 是誰。
「working on main」也不是笑話。 Google 論文寫的 trunk-based development,指的是絕大多數人直接在 head 上工作,branch 只用在 release。這是 Google 寫進 CACM 的正式做法,跑了十年以上。
那「more modern」到底新在哪? 我的看法是:Scion 是 SVN 的拓樸,加上 git 的物件模型。
拓樸是中心化的:server 是唯一真相,client 不存完整副本。這點跟 SVN、Perforce 一樣。
但它沒有丟掉 git 最好的那個設計:content-addressed。Pro Git 的描述是:
“Git stores everything in its database not by file name but by the hash value of its contents.”
git 存東西不是用檔名,是用內容的 hash。
Scion 的 changeset 指向的也是 content-addressed 的 blob。前面講過,正是這個特性讓三層快取不會過期:內容不變,hash 就不變,任何一層快取都能直接回答。
Google 的前一代系統,中心是一台機器:Piper 之前的 Perforce 跑在單機上。HN 上有人留言說那台機器有超過 100 萬美元的 DRAM(這是留言者的說法,我查不到第二來源),接著說:
“Its centralized design was not a setup one would want to copy.”
那種中心化的架構,不是你會想照抄的。
Piper 和 Scion 的「現代」,在於中心那一端不再是一台機器。Piper 建在 Spanner 上、分散在 10 個資料中心;Scion 的權威層在 Spanner 和雲端儲存上,前面擋著兩層快取,原文的設計原則是每一層都能水平擴展。
最強的反駁在同一串裡。 一位自稱當年在 Google 的留言者 mike_hearn 說:
“I mean 30k CLs per day isn’t much. That’s one every few seconds. Well within what a decent perforce setup can do with enough replicas.”
每天 3 萬筆不算多,幾秒一筆而已。一套像樣的 Perforce 加上足夠的副本就扛得住。
如果真是這樣,Anthropic 為什麼不直接買 Perforce?原文沒回答,我也回答不了:我手上沒有 Perforce 在每天 2,500 萬次 checkout、加上 agent 要求全面 API 化這種條件下的公開數據。能說的是,這個反駁打的是「要不要自己造」,不是「要不要中心化」。在後面這個問題上,吐槽的人和 Anthropic 的答案一樣。
中心化的代價也是真的。 另一則留言:
“Until the server goes down. Subversion going down at work stopped everything.”
直到 server 掛掉。以前公司的 Subversion 一掛,所有人都停工。
git 的分散式設計,在 server 掛掉時還能讓人在本機繼續工作。Scion 放棄了這一點。對 Anthropic 這不算損失,因為 agent 和 CI job 連不上 server 本來就做不了事。對一個有很多工程師需要離線工作的團隊,這個代價就要算進去。
坦白說
這篇有五個地方要扣分。
第一道牆的推演是我的。 「client 端搶 main、rebase 永遠追不上」是我根據 git push 的 fast-forward 規則推出來的,10 分鐘測試是我假設的數字。Anthropic 原文講的是「複製不了全域鎖」,沒有用賽跑這種說法描述他們的痛點。830 這個比值也是我拿兩個原文數字相除算的。
git 其實還能撐更久。 Microsoft 的路證明,保留 git 指令、換掉檔案系統,Windows 這種量級也能用。這是對本文主論點最強的反駁。我的回應是:GVFS 解的是讀取和 client 運算,解不了 main 的寫入排隊;而且它的做法正是拿掉「每個 clone 都完整」這個假設。git 的指令留下來了,git 的設計假設沒有。
全部是廠商自述。 30,000 筆、200 倍、25%,都是 Anthropic 自己的數字。Scion 不開源,沒有人能重現。原文也沒給缺陷率、revert 率、事故數。合併數不是產出,這 30,000 筆裡有多少是 agent 在修 agent 造成的衝突,原文沒說。
成本沒寫。 原文自己承認:
“Anthropic is unique in that our ability to spend tokens for internal use far exceeds what any other business would realistically want to spend.”
Anthropic 的特殊之處在於,我們能花在內部用途的 token,遠超過任何其他企業實際上願意花的量。
七個人、五個月是人力,token 帳單不在裡面。
多數團隊不會先撞這面牆。 X 上 Ping-Lin Chang 的回應我很認同:
“I think most teams hit the review wall well before the source control one.”
多數團隊會先撞到 review 這面牆,不是版本控制這面牆。Anthropic 原文自己也寫了:
“Scion is by no means a suitable replacement for git for general use.”
它把建議留給 git 生態:git server 不必長得跟 git client 一樣;forge 可以提供完整的 server-side RPC;sparse 和 shallow 那些功能可以做到能互相組合。這三條不需要任何人換掉 git。
關鍵洞察
1. git 撐不住的是假設,不是演算法。 三個假設:main 由 client 搶著往前推、每個 clone 都完整、歷史在本機算。判斷你的團隊離牆多遠,就看這三件事各自的量:每天多少筆合併搶 main、CI 一天 checkout 幾次每次抓多少、有多少 job 只是為了查一個 blame 就 clone 整個 repo。
2. 繞路的成本跟著合併速度長。 seed、mirror、shallow clone 都是快照,main 越快越快過期。如果你發現維護這些東西的人力在增加,那是牆在靠近的訊號。
3. 能問 server 的,不要 clone。 查 diff、查 blame、查兩個 commit 的關係,GitHub 和 GitLab 的 API 現在就能回答一部分。agent 變多的時候,先問這個 job 真的需要一份 working copy 嗎,再決定要不要加 runner、加 mirror。
4. 閘門往後移之前,先有 revert。 Google 和 Anthropic 都有合併後的自動撤回。合併前的綠燈撐不住的那一天,接手的是 post-merge 測試加自動 bisect 和 revert。這條 pipeline 不存在,閘門就沒有地方可以移。
5. 不要搬離 git。 這是 Anthropic 自己說的。
最後補一個對照。
git 自己就是這樣來的。2005 年 4 月 7 日,Linus Torvalds 做了 git 的第一個 commit,起因是 kernel 社群不能再用 BitKeeper。一個工作負載撐爆了手上的工具,於是自己寫一個。
21 年後 Anthropic 做了同一件事。差別是這次撐爆工具的是 agent,寫新工具的也是。
常見問題 Q&A
Q: git 為什麼在大量 commit 下會撐不住?
git 有三個 2005 年為 Linux kernel 社群設計的假設:main 只接受 fast-forward 更新、每個 clone 都是完整副本、diff 和 blame 在本機算。合併量一大,三個假設各撞一面牆。寫入端,每個 client 要自己 fetch、rebase 再 push,main 動得太快就追不上。讀取端,Anthropic 的 working copy 壓縮後超過 25 GB,CI 每天約 2,500 萬次 checkout,整包抓一天超過 600 PB。運算端,git client 的工作量跟 repo 大小成正比,Microsoft 2017 年在超過 350 萬個檔案的 Windows repo 上,git status 要將近 10 分鐘。seed、mirror、淺層複製(Shallow Clone)這些繞路都是 main 的快照,合併越快越快過期。
Q: Anthropic 的 Scion 是什麼?是不是重新發明了 SVN?
Scion 是 Anthropic 內部自建的版本控制系統(Version Control System),2026 年 10 月 13 日公開。它跟 git 的差別在三個假設:commit 在 server 端建立,移動 main 是 Spanner 上單一列的 compare-and-swap;client 永遠在線、要用再抓,working copy 可以沒有;history、blame、merge、rebase 都在 server 算並開成 API。Hacker News 上很多人說它等於 SVN 或 Perforce,這在拓樸上是對的:一樣以 server 為中心。差別在兩處:它保留了 git 用內容 hash 定址(Content-Addressed)的物件模型,讓三層快取不會過期,每層命中率超過 99%;中心那一端建在 Spanner 和雲端儲存上,可以水平擴展,不像 Google 當年的 Perforce 跑在一台機器上。Anthropic 自述基礎設施 CPU 與記憶體需求縮小 200 倍。七個人、五個月完成,沒有開源。
Q: Google 為什麼不用 git?Piper 怎麼運作?
Google 2016 年的 CACM 論文說,git clone 要把所有內容複製到本機,跟大型 repo 不相容;改用 git 就得把 repo 拆成數千個,Google 用 git 的 Android 就拆成 800 多個。Google 自建 Piper,建在 Spanner 上、分散在 10 個資料中心。工程師透過 CitC(Clients in the Cloud)這個 FUSE 檔案系統看到整個 repo,只存改過的檔案,平均一個 workspace 不到 10 個檔案。變更以單一序列進入主幹(Trunk-based Development),branch 主要只用在 release。合併前所有程式碼都要有人審、跑 presubmit;合併後自動重建受影響的相依,大範圍壞掉會自動撤回。
Q: 一般團隊需要搬離 git 嗎?
不需要。Anthropic 自己寫 Scion 不適合一般用途;Google 和 Anthropic 的規模都是每天數萬筆變更、單一程式庫(Monorepo)數十 GB 以上。一般團隊能拿走的是做法:量 CI 的 checkout 次數與耗時、讓 agent 透過 GitHub 或 GitLab 的 API 查 diff 和 blame 而不是 clone 整個 repo、在把閘門往合併後移之前先建好自動撤回。如果 repo 本身太大,Microsoft 的 GVFS 證明可以保留 git 指令、改用按需下載的檔案系統。
Q: 每天 3 萬筆合併,merge queue 怎麼辦?
合併佇列(Merge Queue)靠一把全域鎖讓變更依序進 main。Anthropic 原文說他們沒辦法有效複製這把鎖,所以不再保證 main 每一刻都是綠的,改投資合併後與部署前的自動化測試,同時合併造成的衝突交給 Claude 修。這不代表合併前完全不測,被放棄的是全域鎖和嚴格排隊。Google 2016 年的做法是兩段式:合併前人審加 presubmit,合併後重建受影響的相依並自動撤回壞掉的變更。
來源
- Anthropic Engineering, Redesigning source control at Anthropic
- Rachel Potvin, Josh Levenberg, Why Google Stores Billions of Lines of Code in a Single Repository, Communications of the ACM, 2016
- Pro Git, What is Git?、A Short History of Git
- Git documentation, git-push: Note about fast-forwards
- Microsoft DevOps Blog, Announcing GVFS (Git Virtual File System), 2017
- GitHub Blog, Git turns 20: A Q&A with Linus Torvalds
- Hacker News 討論串:news.ycombinator.com/item?id=50073633