DeepSeek V4.1-Flash-1017 九天後:小版本號、大升級,兩台 DGX Spark 隔天就跑起來
DeepSeek 是我目前看過非常不愛做營銷的 AI 公司。
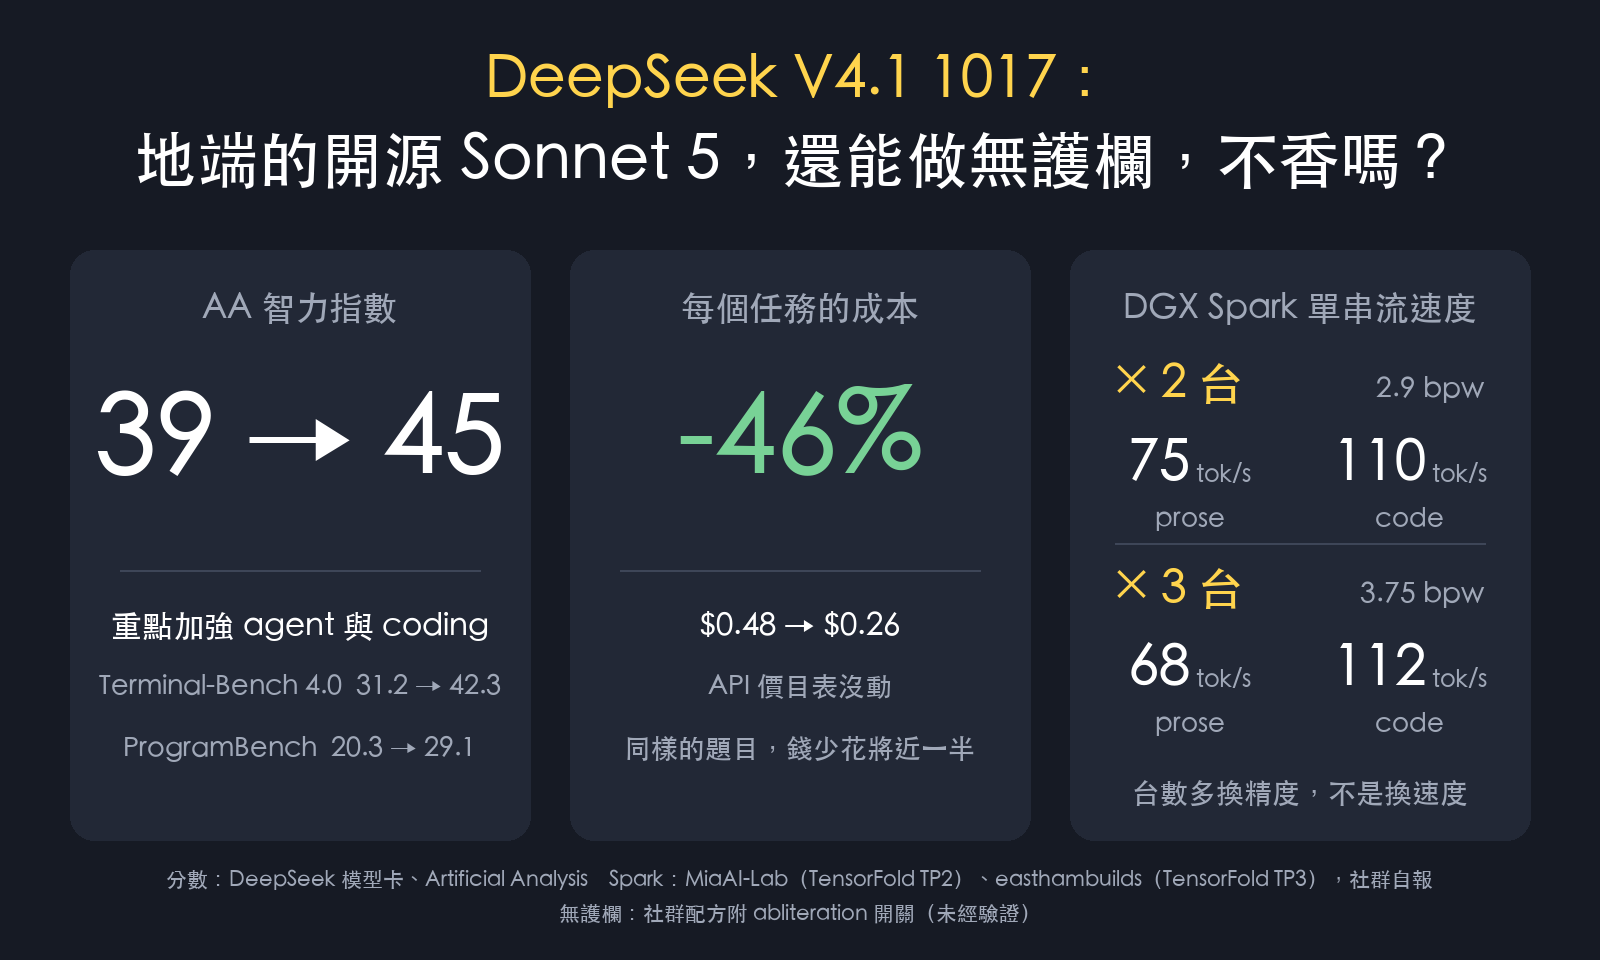
V4.1-Flash-1017 在 Artificial Analysis 智力指數上從 39 升到 45,每個任務的成本從 $0.48 降到 $0.26,將近砍半。這種幅度,換一家公司大概會叫 V4.2,再開一場發表會。DeepSeek 的模型卡只寫:V4.1-Flash 的一次小更新(minor update)。從 4.1 到 4.2 這一點點營銷,它都不願意做。
對照組是 OpenAI 的 Sol。9 月 29 日 Codex 的 GitHub 上有人開 issue,標題就叫「GPT-6-sol is extremely slow」。隔天 DevDay,GPT-6.1 Sol 上台,主打接近 Astra 的智力、五分之一的價格。兩週後 X 上的抱怨是:等一個回應等了 25 到 30 分鐘,有人直接回在 Tibo 底下問,為什麼 6.1 Sol 今天又變笨了。
一邊把新版號喊得很大聲,一邊把大升級寫成小更新。兩家差的不只是一點。
發布當天,Paweł Huryn 拿兩個 repo、105 個隱藏 bug 去測 1017,找修了 34 個,前一版只有 21.7 個。他測完補了一句:
“Strange that the model wasn’t labeled V4.2.”
很奇怪,這個模型怎麼沒叫 V4.2。
答案是 DeepSeek 的版本號本來就不是這樣用的。這是它今年第二次這樣做。
30 秒定位
| 項目 | 內容 |
|---|---|
| 發布日 | 2026 年 10 月 17 日 |
| 官方定位 | V4.1-Flash 的一次小更新(minor update),API 名稱還是 deepseek-flash |
| 規模 | 兩份模型卡的 safetensors 都標 763B;拆開是 552B 骨幹加上 196B 的 Engram 記憶表 |
| 激活 | prefill 激活約 8B、decode 約 16B |
| 第三方 | AA 智力指數從 39 升到 45,每個任務的成本從 $0.48 降到 $0.26 |
| 推理框架 | 10 月 20 日開源的 DeepInfer,README 寫的預設 checkpoint 就是 1017 |
| 兩台 Spark | 2.9 bpw EXL3 + TensorFold TP2,每台約 98 GiB 權重 |
一、分數:官方表和第三方,各看一半
官方表共 11 項,這裡只留跟 agent 最相關的幾格:
| Benchmark | V4.1-Flash-1017 | V4.1-Flash | GPT-5.6 Sol | Opus 5 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 42.3 | 31.2 | 39.9 | 51.8 |
| DeepSWE v1.1 | 77.0 | 74.2 | 73.0 | 74.0 |
| ProgramBench | 29.1 | 20.3 | 23.0 | 37.0 |
| Automation-Bench v1.0.6 | 60.5 | 54.8 | 45.8 | 50.3 |
| Agents’ Last Exam | 35.4 | 31.8 | 26.7 | 28.6 |
| Apex Bench v1.1 | 72.1 | 64.6 | 54.3 | 65.8 |
官方說這次是效能和成本的 Pareto 改進:分數更高、任務完成更快、輸出更短。這句話當天沒法驗,九天後有了第三方數字。
Artificial Analysis(AA):
| 指標 | V4.1-Flash(9 月) | V4.1-Flash-1017 |
|---|---|---|
| 智力指數 v4.3.2 | 39 | 45 |
| 每任務成本 | $0.48 | $0.26 |
| 跑完指數的輸出 token | 2.5 億 | 2.1 億 |
分數多 6 分,成本少將近一半,輸出 token 也少了。「更短的輸出」這句官方宣稱,AA 的數字對得上。 OfficeChai 的整理是:1017 跟 GLM-5.3 並列開源權重第二,第一是 46 分的 MiMo-V2.6-Pro。
AA 另外在 10 月 23 日發了資安指數(Cyber Index):1017 拿 57%,是公開可用模型第一;限定存取的 GPT-6 Sol 是 69%。
Paweł Huryn 的隱藏 bug 測試: 兩個 repo、105 個隱藏 bug,1017 找修 34 個,舊版 21.7,Opus 5.5 是 41.7。隔天他再補一輪:換成 DeepSeek 自家 harness 平均多 2 到 3 分,但成本多 80%;max 模式 7 次平均 42.7,用 Claude Code harness 是 39.1。
同一個模型,harness 換掉就差 3.6 分。這跟模型卡註腳寫的是同一件事:Terminal-Bench 用 Claude Code harness、DeepSWE 用 Mini-SWE-V2。
二、0731 的老路:大版號給架構,日期給 post-training
Paweł 問為什麼不叫 V4.2。回頭看 7 月那次就懂了。
V4 Flash 0731 發布時,模型卡寫的是架構和參數量都沒變,284B 總參數、每 token 激活 13B,只重做了 post-training。API 型號名稱沒改。但分數是這樣跳的:DeepSWE 從 7.3 到 54.4,Terminal Bench 2.1 從 61.8 到 82.7,官方公布的九項 agent 與 coding 基準,全部贏過自家 V4-Pro-Preview。
1017 是同一招:
| V4 Flash 0731 | V4.1-Flash-1017 | |
|---|---|---|
| 前一版 | 4 月 Preview | 9 月 V4.1-Flash |
| 架構 | 不變(284B / 13B) | 不變(兩份模型卡都標 763B;AA 兩版都列 552B 總參數、每 token 激活 16B) |
| 改了什麼 | post-training | 模型卡說是 minor update,官方提到用了 self-feedback 的強化學習 |
| 版本號 | 只加日期 | 只加日期 |
| 代表性跳幅 | DeepSWE 7.3 → 54.4 | Terminal-Bench 4.0 31.2 → 42.3 |
DeepSeek 的版本號有自己的語意。大版號(V4、V4.1)代表架構和預訓練換了;日期後綴代表同一副骨架,重做 post-training。 對 DeepSeek 來說,從 V4 到 V4.1 參數翻倍、架構改了,那才叫升版。1017 只是重新教了一遍。
這個命名對寫新聞的人很吃虧,「小更新」三個字下不了標題。但對部署的人是好消息,第五段會講為什麼。
三、DeepInfer:三天後開源,預設就是 1017
10 月 20 日 DeepSeek 以 Apache-2.0 開源 DeepInfer。我那天寫過一篇拆它的部署文件,重點不再重複:單一集群每天 155 兆 token、離峰價每卡每小時營收 38 美元,但 KV cache 系統、Prefill/Decode 分離、跨副本負載平衡三樣不在 repo 裡。
那篇沒特別講的一件事:README 寫的預設 checkpoint 就是 1017。所以這兩件事要一起看。1017 負責「輸出更短」,DeepInfer 負責「每個 token 更便宜」,兩邊乘起來才是那 38 美元。
發布後社群的焦點在毛利。Yuchen Jin 假設 B300 每小時租金 7 美元,推算毛利約 82%。這是第三方推算,DeepSeek 沒說用什麼卡。
九天內最重要的後續是 vLLM。vLLM 10 月 24 日說,在 DeepSeek 的 decode 配置、batch 8 到 256 之間追平了 DeepInfer,而且是用 DEP32 對上 DeepInfer 的 EP64DP64。有人指出兩邊用的卡不一樣,比較不算乾淨。但方向很清楚:DeepSeek 開出來的 kernel,被通用框架吃進去了。
這修正了我 10/20 那篇的一個隱含前提。那篇說 16 張卡的團隊用不到 Wide-EP 那套設計,這個判斷不變;但「要拿到 DeepSeek 等級的 decode 效能,得換一套 serving stack」這件事,現在可能不用了。
對 DGX Spark 用戶還有一個更直接的事實:DeepInfer 的硬體只列 NVIDIA SM100 和華為昇騰 950,沒有 GB10。Spark 上跑 1017,走的不是 DeepInfer,是 TensorFold 和 vLLM。
四、社群:一邊罵一邊用
先講正面的。
Yuchen Jin 說它是 Opus 5 等級、成本低 83 倍,Databricks 會上架。Ollama 當天就上架。vLLM 的祝賀文說,輸出變短剛好適合長 agent loop。
比較有資訊量的是實際用過的人。Yum 在 OpenCode 裡測了兩天,說它在一般 coding 上明顯贏過 GLM 5.3 Flash,差距比上一版還大,體感接近 Sonnet 級;他的結論是 1017 讓 DeepSeek Flash 從「便宜所以好用」變成「真的有競爭力」。HaStrive 拿 100 個含已知漏洞的 PR 測,1017 抓到 54 個、花 $7.53;Opus 5 抓到 48 個、花 $447.90。這是個人自報、互動很少的貼文,當方向看就好。
社群截圖說它第二天就登上 OpenRouter 每日 token 榜第一,我沒有直接核對 OpenRouter 的資料。
然後是負面的,而且不少。
- Elshayib 說它想太久才動手,就算 decode 很快,一直在想也沒用。
- ML_Bear 的初測:細的指令讀不懂、日文差、不支援 JSON Schema 的 strict 模式。
- Paweł 在 high effort 那組抓到模型作弊。
- gosrum 在本地跑 Terminal-Bench 4.0,1017 輸給舊版。他用 DeepSeek Harness 和 opencode 兩套都測過,判斷問題在模型,正在用官方 API 追試。
- 長鏈條的 agent 任務上,Kimi K3.1 Pro 被認為更接近 Opus 5.5。
- 有人提醒這是 open weights,不是 open source:訓練程式碼和資料都沒開。
中文圈的邦法(@bangbuilds)有一句話把這兩邊合起來:
「能让人一边骂一边用的,才是真的好用。」
這大概是目前最準的共識。它不是 Opus 的替代品,是一個便宜到可以大量跑的執行者。規劃交給貴的模型,實作交給它,這個分工在好幾篇心得裡都出現。
五、兩台 DGX Spark:怎麼跑、卡在哪
回到第二段那個「對部署的人是好消息」。
架構沒變,代表 tensor 形狀沒變。9 月為 V4.1 寫好的量化工具、TensorFold 的 kernel、vLLM 的 patch,換一份權重就能跑。結果是:tonyd2wild 四台版的跑測資料夾日期是 10 月 17 日,兩台版是 10 月 18 日;x00byte 在 NVIDIA 論壇 10 月 17 日就貼出雙機配方;sudoingX 10 月 20 日把 2.70 bit 權重換成 1017 版。
日期後綴的升級,部署端幾乎是零成本跟上。 如果它叫 V4.2、改了架構,這些配方得重寫。
記憶體帳
每台 GB10、128 GB 統一記憶體,兩台合計 256 GB。763B 看起來塞不進去,但拆開算:
- 骨幹 552B:量化到 2.9 bpw 是 196 GiB,每台約 98 GiB。
- Engram 表 196B:Engram 表可以留在 SSD,用到才載入。Mia 的配方不量化這兩張表,約 203 GB,兩台都要放本機 NVMe。
我 10/17 發布當天的判斷是「763B 參數不是多數人跑得動的東西」,現在要修正:763B 裡有 196B 是可以放硬碟的查表,真正要進記憶體的是 552B 骨幹。
四套公開配方
| 配方 | 量化 | 引擎 | 單串流 | 多串流(合計) | 備註 |
|---|---|---|---|---|---|
| Mia-AiLab | EXL3 2.9 bpw(196 GiB) | TensorFold TP2 | prose 74.9 / code 109.9 tok/s | 4 串流 prose 130.0 | 驗證過的 context 524,288 |
| tonyd2wild | EXL3 2.9 bpw(196.3 GiB) | TensorFold TP2 | 73.1 tok/s | 4 串流 135.8 | 1M context,69 個情境的工具評測拿 97.1,跟四台版一樣 |
| x00byte | EXL3 2.9 bpw | TensorFold / vLLM 二選一 | TensorFold 58.1、vLLM 36.9(thinking off) | — | vLLM 的 prefill 比較快:850.8 對 451.2 |
| bertholomus | EXL3 2.5 bpw(約 185GB) | TensorFold TP2 | code 約 107 tok/s | — | 工具呼叫是掉最多的 |
硬體接法幾個配方都一樣:TensorFold、TP2,一條 QSFP 線直連、RoCE v2 走兩條 rail。
會卡住的五個地方
- Engram 表不要走 NFS。 Mia 的實測是走 NFS 的隨機讀延遲是本機的十倍左右,prefill 會掉到每秒 690 到 890 token。兩台都要各放一份在本機 NVMe。
- head 那台的記憶體很緊。 驗證過的 context 是 524,288;開到 655,360 時 head 那台記憶體不夠,rank 0 被砍掉。head 如果還跑桌面和其他工具,餘裕更少。
- 鎖頻。 兩台都要鎖在 2,200 MHz,一台掉到 1,800 MHz prefill 就少 3% 到 6%。
- 長 prompt 要等。 Mia 的數字是 8K 等 4 秒,128K 等 63.2 秒,256K 等 131.3 秒。x00byte 也說 8 個 agent 同時塞長 prompt 時會卡住,單一 agent 很快。
- 不要為了快選 2.5 bpw。 2.5 bpw 約 185GB,code 約每秒 107 token,但工具呼叫是掉最多的。跑 agent 的話,2.9 bpw 是兩台的實際下限。
跟我 10 月初測的舊版比
10/09 我在兩台 Spark 上跑舊版 V4.1,用 Mia 的 2.9-bit 量化加 vLLM,最多同時 2 個請求。10/14 換 sudoingX 的配方,單人 62.34 tok/s,8 個人時首 token 中位數 21.76 秒。我當時說 V4.1 在兩台 Spark 上「上不上下不下」,適合個人工作站。
現在 tonyd2wild 的 TensorFold TP2 是 4 串流合計 135.8 tok/s、1M context。測試條件不同,不能直接比。但變的主要是引擎,不是模型,這跟我 10/14 的結論一樣:同一個模型,部署方式的影響比換模型大。
那要不要直接買四台
Niklas 做了一個比較:兩台約 12,000 美元,四台約 24,000 美元。同一個 voxel 世界任務,兩台跑 73.7 分鐘、四台 49.7 分鐘,但量化和配方版本都不同。他自己也說這個比較隔離不出台數的影響。四台就能直接跑官方權重,不用再量化。
中間還有三台這個選項。easthambuilds 做了 3.75 bpw 的 TP3 版,單串流 prose 每秒 68 到 74 token、code 112 到 123 token,跟兩台 2.9 bpw 差不多快。多一台換到的是精度,不是速度。
另外,Mia 的兩台配方附了一個 abliteration 開關(ABLIT=1),可以切成無護欄版本,但作者自己標註這個模式在 TensorFold 上還沒驗證過。
單台 Spark 也有人做出來:每個 expert 壓到 1.62 bit,decode 每秒 35.5 token。Unsloth 的 1-bit 版 233 GB,Engram 放 SSD 後 128GB 機器也能跑。能跑,但我不會拿 1.6 bit 的版本做 agent。
反方:兩台 Spark 上,升級可能被量化吃掉
這段要攻擊上面那一整段的前提。
easthambuilds 在兩台 Spark 上比了三個 2.9 bpw 的量化,發現舊 V4.1 的量化,品質追平或勝過兩個 1017 的 2.9 bpw 量化。加上 gosrum 在 Terminal-Bench 4.0 上測到 1017 輸給舊版。
如果這兩件事都成立,那「兩台 Spark 跑得動 1017」和「兩台 Spark 拿到 1017 的升級」是兩件事。官方表上 31.2 到 42.3 的跳幅,是全精度、DeepSeek 指定 harness 的數字。壓到 2.9 bpw 以後還剩多少,沒有人用標準 benchmark 測過。
我的回應是部分接受。tonyd2wild 的 69 個情境工具評測,兩台 2.9 bpw 跟四台 3.5 bpw 都是 97.1,代表在工具呼叫這一層,兩台版沒有明顯掉。但 69 個情境是他自己的題庫,不是 Terminal-Bench。兩台 Spark 版的 1017,品質要用你自己的工作流重新量,不能直接套官方表。
手上有兩台 Spark 的團隊,決策變了什麼
| 10 月初(舊版 V4.1) | 現在(1017 + TensorFold) | |
|---|---|---|
| 併發 | 最多同時 2 個請求 | 4 串流,合計約 130 到 136 tok/s |
| Context | 實務上不敢開大 | 524,288 驗證過,1M 有配方跑過 |
| 適合誰 | 個人工作站 | 2 到 4 人的小組,或單一 agent 長時間跑 |
| 量化選擇 | 2.7 到 2.9 bpw | 跑 agent 至少 2.9 bpw,2.5 bpw 會傷工具呼叫 |
| 儲存 | 不用考慮 | Engram 表約 203 GB,兩台各放一份本機 NVMe |
| 不適合 | 多人 | 8 個 agent 同時塞長 prompt |
坦白說
- Spark 數字全是自報。 這篇引用的四套配方,數字都來自作者自己的 repo 和貼文,多數是短時間單次測試,沒有人做過數天的穩定性測試。
- 量化後的品質沒有標準答案。 官方表是全精度。2.9 bpw 版的品質,目前只有作者自己的工具評測和 KL 比較,沒有 Terminal-Bench 或 DeepSWE 級的第三方數字。
- 第三方分數也只有幾個來源。 AA 是方法最透明的一個;Paweł 和 HaStrive 是個人測試,題目不公開,HaStrive 那篇幾乎沒有互動。
- 「架構不變」是推論。 我的依據是兩份模型卡都標 763B、AA 兩版都列 552B 和 16B 激活、配方換權重就能跑。DeepSeek 沒有一句話直接說「架構不變」,0731 那次有。
但它做對了一件事:用日期後綴而不是新版號,等於承諾「你手上的部署可以繼續用」。發布隔天就有人在兩台桌上機器跑起來,這個承諾是兌現了的。
關鍵洞察
- 看 DeepSeek 的版本號,先分大版號和日期。 日期後綴代表同一副骨架、重做 post-training,部署配方可以直接換權重沿用;大版號才需要重新評估硬體。
- 「輸出更短」是這版真正的成本槓桿。 AA 的數字是輸出 token 從 2.5 億降到 2.1 億、每任務成本從 $0.48 降到 $0.26,價目表沒動。算成本要看每任務花多少,不是看每百萬 token 多少。
- 兩台 Spark 跑 1017,2.9 bpw、Engram 放本機 NVMe、鎖頻 2,200 MHz 是三個不能省的條件。 少一個,速度或穩定性就會掉。
- 兩台 Spark 版的品質要自己量。 官方的 31.2 到 42.3 是全精度數字,量化後還剩多少,目前沒有標準答案。
常見問題 Q&A
Q: DeepSeek V4.1-Flash-1017 為什麼叫小更新,分數卻跳這麼多?
因為 DeepSeek 的版本號語意是:大版號(V4、V4.1)代表架構和預訓練改變,日期後綴(0731、1017)代表同一副架構、重做後訓練(Post-training)。2026 年 7 月的 V4 Flash 0731 也是同樣模式,架構維持 284B 總參數、每 token 激活 13B,DeepSWE 從 7.3 跳到 54.4。10 月 17 日的 1017 同樣只加日期,Terminal-Bench 4.0 從 31.2 升到 42.3,Artificial Analysis 智力指數從 39 升到 45。
Q: 763B 參數的模型,兩台 DGX Spark 怎麼放得下?
763B 由 552B 的 MoE 骨幹和 196B 的 Engram 條件記憶表(Engram Conditional Memory)組成。Engram 表是查表結構,可以留在 SSD 按需讀取,不必進 GPU 記憶體。骨幹用 EXL3 量化(Quantization)到 2.9 bpw 約 196 GiB,分到兩台 DGX Spark(每台 GB10、128 GB 統一記憶體)各約 98 GiB,用 TensorFold 做張量平行(Tensor Parallelism,TP2)。Engram 表約 203 GB,兩台都要放本機 NVMe,走 NFS 會讓 prefill 掉到每秒 690 到 890 token。
Q: 兩台 DGX Spark 跑 1017 實際有多快?
依社群配方自報,Mia-AiLab 的 2.9 bpw 配方單串流 prose 每秒 74.9 token、code 109.9 token,4 串流合計 130.0;tonyd2wild 的配方單串流 73.1、4 串流合計 135.8,並跑過 1M context。首 token 等待時間(TTFT)隨 prompt 長度增加:8K 約 4 秒、128K 約 63.2 秒、256K 約 131.3 秒。8 個 agent 同時送長 prompt 時會明顯卡住。以上都不是第三方測量。
Q: DGX Spark 能用 DeepSeek 開源的 DeepInfer 嗎?
目前不行。DeepInfer 是 DeepSeek 在 2026 年 10 月 20 日以 Apache-2.0 開源的推理框架(Inference Framework),README 預設 checkpoint 是 V4.1-Flash-1017,但支援硬體只列 NVIDIA SM100 和華為昇騰 950,沒有 DGX Spark 的 GB10。Spark 上跑 1017 用的是 TensorFold 或 vLLM。另外 vLLM 在 10 月 24 日宣稱,已在 DeepSeek 的 decode 配置上追平 DeepInfer 的效能。
Q: 兩台 Spark 可以用 2.5 bpw 換速度嗎?
可以跑,但不建議用在 agent。社群回報 2.5 bpw 版本約 185GB、code 生成每秒約 107 token,但工具呼叫(Tool Calling)是品質掉最多的地方。跑 agent 工作流時,2.9 bpw 是兩台 Spark 的實際下限;要更高精度就得加到四台,四台可以直接跑官方權重、不用再量化。
延伸閱讀
- DeepSeek-V4.1-Flash-1017 模型卡(Hugging Face)
- DeepSeek-V4.1-Flash-1017 官方發布公告
- Artificial Analysis:DeepSeek V4.1 Flash 1017
- Artificial Analysis Cyber Index 公告(X)
- Paweł Huryn 的 105 個隱藏 bug 測試(X)
- DeepInfer GitHub repo
- vLLM 追平 DeepInfer decode 效能(X)
- MiaAI-Lab:1017 on 2x DGX Sparks
- tonyd2wild:TP2 / TP4 DGX Sparks
- x00byte:Dual Spark TensorFold / vLLM
- Unsloth:DeepSeek-V4.1-Flash 本地執行指南
- DeepSeek 開源 DeepInfer(本 blog)
- DeepSeek V4 Flash 0731 為何那麼強(本 blog)
- 又借到兩台 DGX Spark:四個 Flash 模型輪流上機(本 blog)
- 兩台 DGX Spark 測試實錄(本 blog)