用 Claude 打穿 OpenAI 內部 Repo:三個人、$3,000、72 小時的資安經濟學
事件還原:72 小時 Exploit Chain
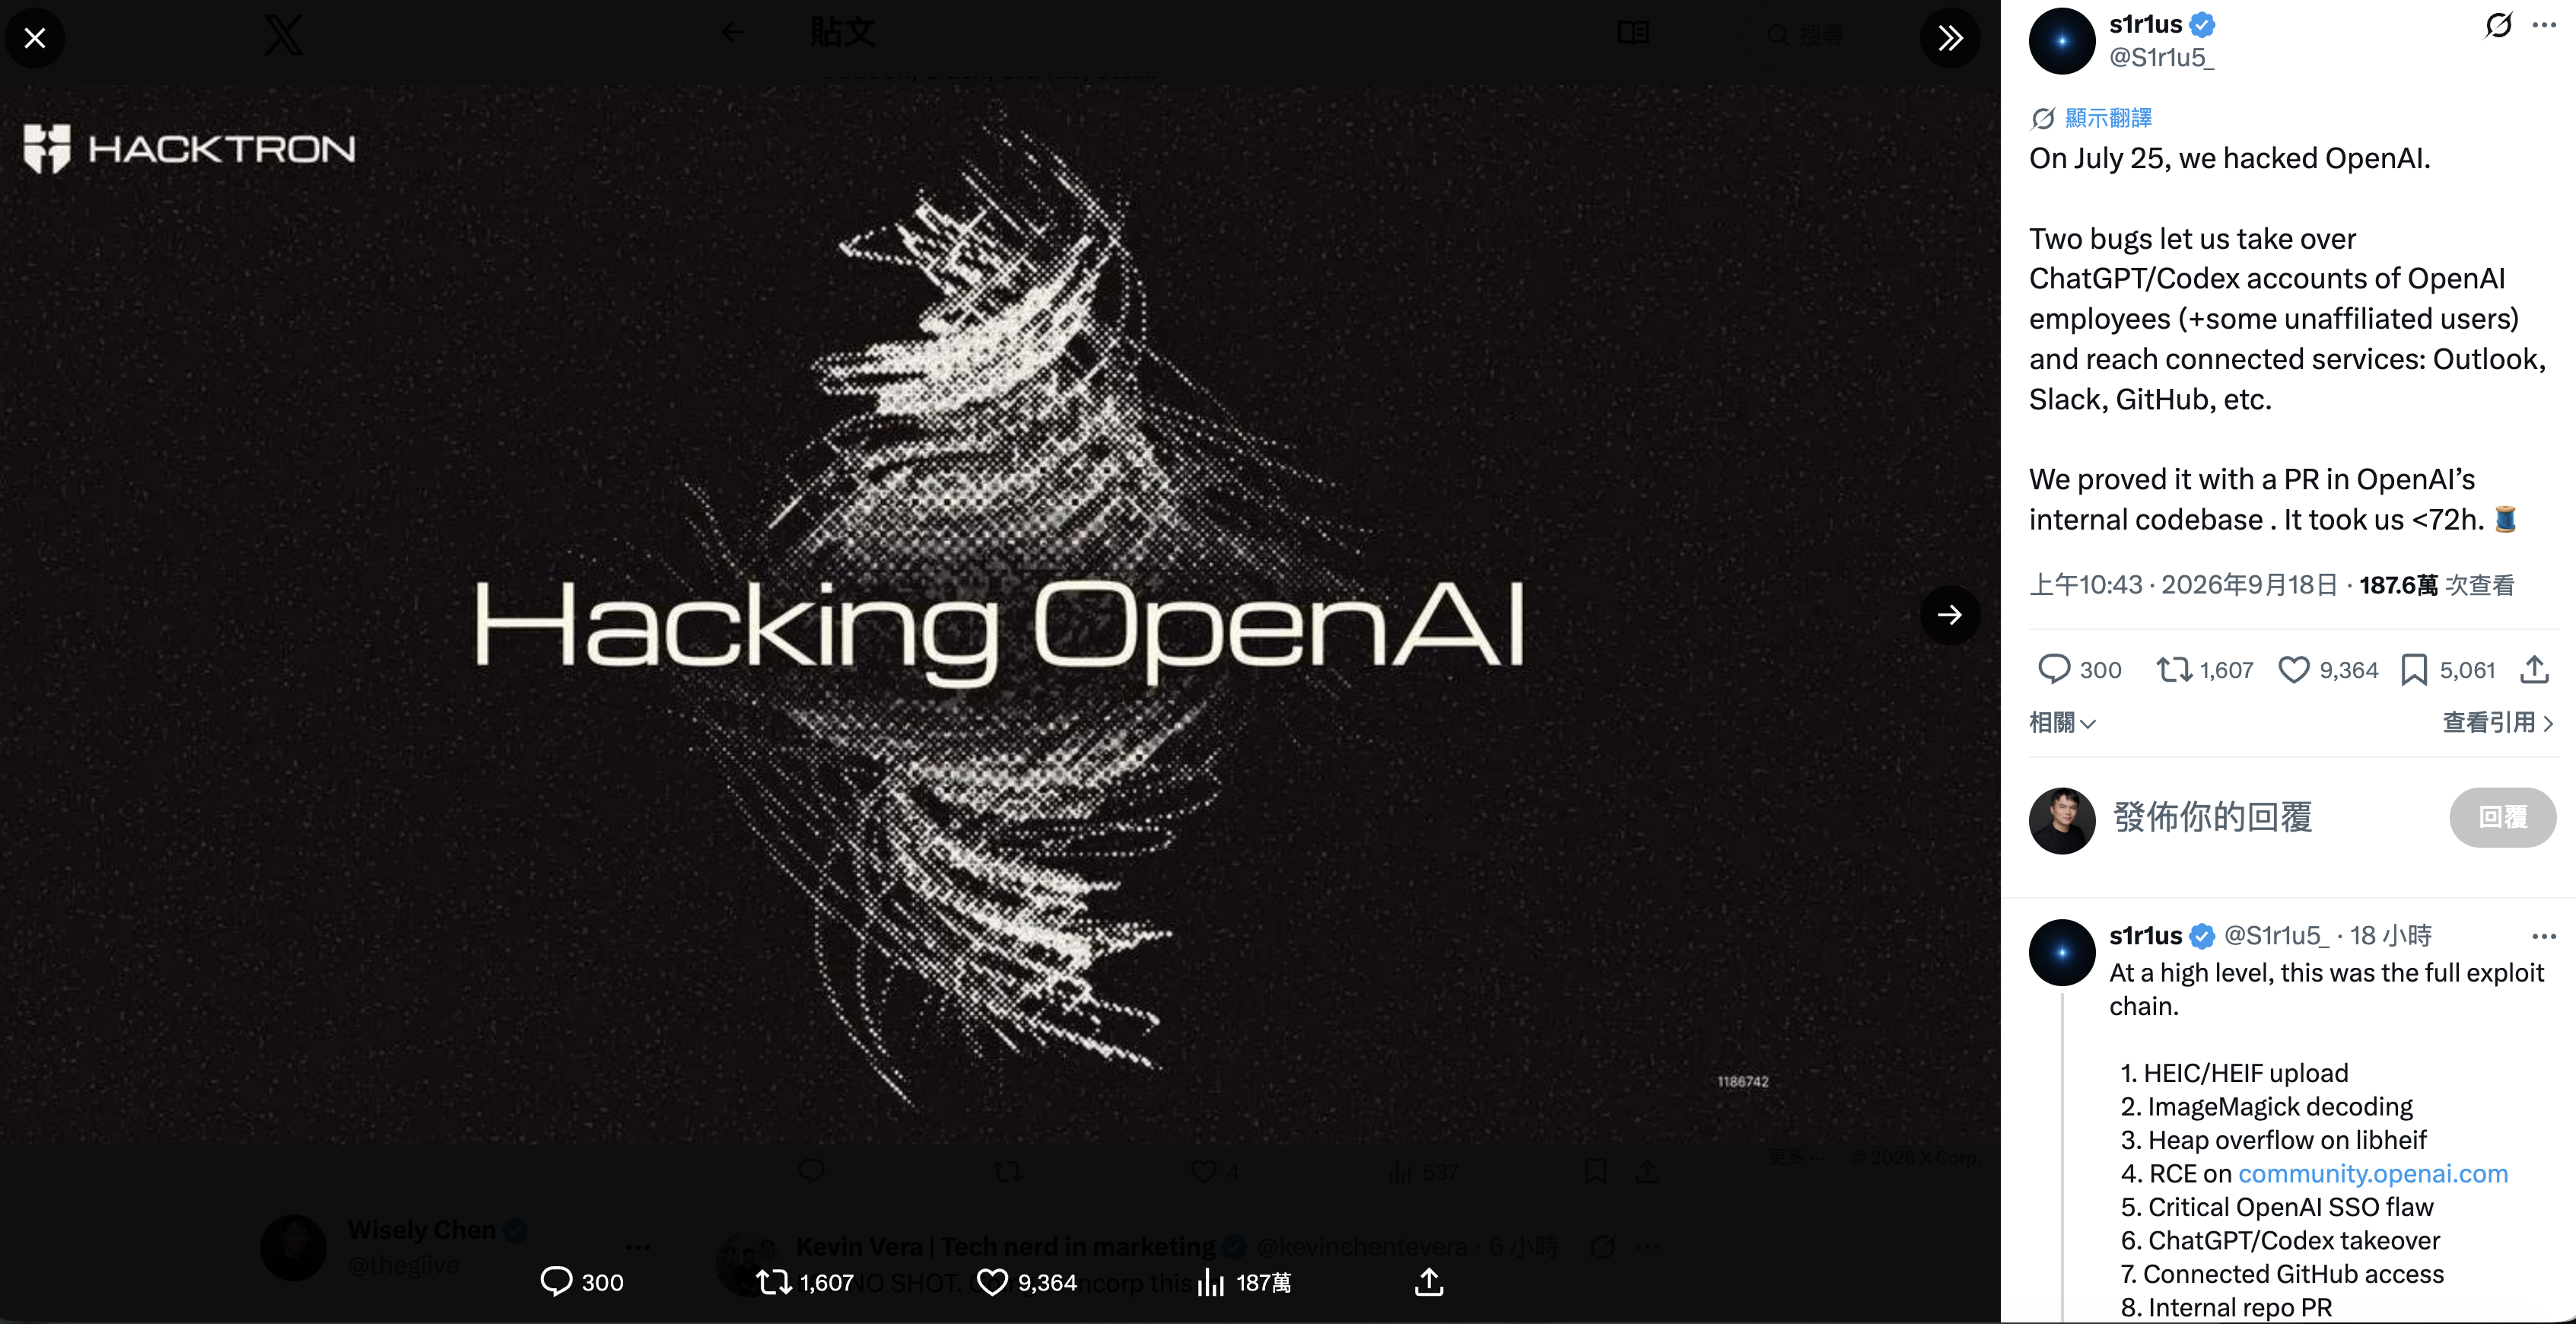
2026 年 7 月 25 日凌晨,Hacktron AI 的三名安全研究員(Harsh Jaiswal、Mohan Pedhapati、Rahul Maini)完成了一條完整的攻擊鏈:
1
2
3
4
5
6
7
8
1. HEIC/HEIF 圖片上傳到 community.openai.com(Discourse 論壇)
2. Discourse 的 FastImage 不支援 HEIF,fallback 到 ImageMagick 解碼
3. ImageMagick 底層的 libheif 觸發 heap buffer overflow
4. 取得 community.openai.com 的遠端程式碼執行(RCE)
5. 利用 OpenAI SSO 身分驗證缺陷(論壇用「Sign in with OpenAI」)
6. 接管員工的 ChatGPT / Codex 帳號
7. 透過帳號已連結的 GitHub 存取 OpenAI 內部組織
8. 在 OpenAI 內部 monorepo 開出 PR #1186742
從發現漏洞到在 OpenAI 內部程式碼庫開出 pull request,不到 72 小時。
他們立刻停手、提交報告。OpenAI 在 14 小時內修復 SSO 問題。Discourse 週六收到報告、週日回覆、週一修好。OpenAI 支付了 $6,500 賞金。
數字先攤在這裡:
| 項目 | 數字 |
|---|---|
| 研究人數 | 3 人 |
| 攻擊鏈完成時間 | < 72 小時 |
| 整個 HEIF Heist 專案 token 成本(2 個月、多家公司) | < $3,000 |
| OpenAI 賞金 | $6,500 |
| OpenAI 修復時間 | ~14 小時 |
| 受同一漏洞影響的公司 | OpenAI, Slack, Meta, GitHub Enterprise 等 |
為什麼這篇不是又一個「XX 被駭」
先說清楚:這條 exploit chain 裡的漏洞類型,全部是教科書等級。
Heap buffer overflow——記憶體安全漏洞,C/C++ 專案的常客。SSO misconfiguration——身分驗證設定錯誤,OWASP Top 10 裡面的老朋友。這兩類漏洞的存在本身不令人意外。
真正改變的不是漏洞,是從漏洞到可靠 exploit 的轉換成本。
過去,找到一個 heap overflow 和把它變成穩定的遠端程式碼執行是兩回事。中間隔著好幾道技術門檻:
- ASLR 繞過——作業系統每次啟動程式時會把記憶體位址隨機打亂(Address Space Layout Randomization),攻擊者即使找到溢位漏洞也不知道要跳到哪裡執行惡意程式碼,必須先想辦法洩漏或猜出真實位址
- 記憶體佈局分析——搞清楚目標系統的 heap 分配器怎麼排列記憶體區塊,才能精準控制溢位後覆蓋到正確位置
- Shellcode 開發——寫出注入後能執行的機器碼
- 目標環境適配——不同 OS、CPU 架構、記憶體分配器(glibc malloc vs. jemalloc)都需要不同的 exploit 策略
這些步驟傳統上需要頂級安全研究員花數週到數月,而且高度依賴個人經驗和直覺。
Hacktron 的團隊把這個轉換過程交給了 AI。
Opus 4.8 → Opus 5:一次模型升級 = 一次攻擊力跳升
這裡有一個非常值得記錄的技術細節。
Hacktron 團隊在 7 月 24 日先用 Claude Opus 4.8 開發 exploit。ASLR 關閉(記憶體位址固定,等於把鎖打開讓你練習開門)的情況下可以成功,但 ASLR 開啟(記憶體位址每次隨機,真實生產環境的標準配置)時,跑了多個 session 都失敗。
當天晚上,Anthropic 發布了 Opus 5。
團隊切換到 Opus 5,三小時內產出 ARM64 環境的 working exploit,隨後成功移植到 Discourse 使用的 x86-64 + jemalloc 配置。到 7 月 25 日早上 6 點,本地 RCE 確認成功。
之後他們把 Claude 放進 autonomous /goal loop,讓它自主對 Discourse Cloud 實例發起攻擊。早上 10 點回來看——RCE 達成。
這不是 benchmark 上的分數差異。這是同一個漏洞、同一個團隊、同一個目標,換一個模型版本,從「做不到」變成「三小時搞定」。
Hacktron 在文章中還提到,後續研究中觀察到 Opus 5 到 GPT-5 Sol 之間又有一次能力跳升——在完全不知道目標系統版本和部署環境的情況下,AI 從幾乎盲目的狀態成功適配 exploit。
每一次模型升級,攻擊方的工具箱就升級一次。這個速度比大多數企業的 patch cycle 快得多。
經濟學翻轉:三組數字的對比
把三組數字放在一起看:
攻擊成本:
- 3 個研究員
- < $3,000 token 費(整個兩個月的 HEIF Heist 專案)
- < 72 小時(OpenAI 這一條鏈)
防禦方回報:
- $6,500 賞金
潛在風險範圍:
- 員工 ChatGPT/Codex 帳號
- 連結的 GitHub 組織(包括內部 monorepo)
- 連結的 Slack
- 連結的 Outlook
- 理論上所有透過 OpenAI SSO 串接的服務
社群的反應很直接。Nik Cubrilovic 看到 $6,500 賞金只說了一個字:”yikes”。有人認為這種等級的發現賞金應該是六到七位數。Mario Nawfal 的評論更尖銳:”If a subscription gets you that far, the teams with actual state funding behind them are barely trying.”
但賞金的合理性不是重點。重點是這組數字揭示的結構性變化:
過去,一個 critical exploit chain 從發現到武器化,可能需要一個有經驗的團隊花幾個月,成本可能是六位數的人力。這個高昂的轉換成本形成了一種隱性的安全屏障——Hacktron 在文章中稱之為 “security through complexity”。
現在,三個研究員加上 AI,兩天內完成。而且他們把同樣的方法套用到 Slack、Meta、GitHub Enterprise——每個新目標通常只需要一到兩天就能適配。
更值得注意的是偵測率:除了 Shopify,沒有任何公司偵測到 Hacktron 的活動,儘管他們發送了數千張圖片,而且目標系統的 image processor 多次 crash。
攻擊變便宜了,偵測還是一樣難。這就是經濟學翻轉的完整圖像。
一個 Image Library 的蝴蝶效應
技術面有一個細節值得展開。
libheif 是一個開源的 HEIF/HEIC 圖片解碼函式庫。上游已經修了這個安全問題超過一年,但那個 commit 沒有被標記為安全修復,也沒有拿到 CVE 編號。結果 Debian 12 和 13 都沒有回補。
Discourse 的 Docker image 基於 Debian 12,裝的是有漏洞的 libheif 1.19.7。Discourse 本身的程式碼品質不差——Hacktron 說他們之前就研究過 Discourse,不是一個容易打的目標。但 FastImage 不支援 HEIF 格式,所以 HEIF 檔案會繞過 FastImage,直接走 ImageMagick,暴露了底層的 libheif parser。
一個不起眼的圖片解碼函式庫,一個沒標記的安全修復,一個格式相容性的 fallback 路徑——串起來就是一條從「上傳一張圖片」到「遠端程式碼執行」的攻擊路徑。
而且這不只影響 OpenAI。Hacktron 把這個研究擴展為 HEIF Heist 專案,發現同一個 libheif 生態系的漏洞影響了 Slack、Meta、GitHub Enterprise、Ruby on Rails、Next.js、Astro、Gatsby。Harsh Jaiswal 在推文中引用了 xkcd #2347——那張經典的「整個現代數位基礎設施依賴某個內布拉斯加的無名開發者維護的專案」。
這是供應鏈安全最真實的案例之一:你的 dependency tree 裡可能有幾十個 libheif 等級的函式庫,上游修了但沒人知道,下游用了但沒人查。
對 AI Coding 從業者的啟示
我們團隊每天用 AI 寫 code,用 Claude Code 做開發、用 Cursor 做 review。所以我在看這則新聞的時候,第一個想到的不是「OpenAI 被駭好可怕」,而是:
你用來加速開發的同一個 AI,別人用來加速 exploit 開發。
Hacktron 用 Claude 做的事情,跟我們用 Claude 做開發在本質上非常相似:給它一個目標、提供環境、讓它迭代嘗試、在卡住的時候換方向。差別只在目標是「寫一個 feature」還是「繞過 ASLR 拿到 shell」。
這帶出幾個實務上的啟示:
1. 每次模型升級,你的攻擊面也在升級
Opus 4.8 做不到的事,Opus 5 三小時做到了。這代表你今天覺得「不太可能被利用」的漏洞,下一次模型更新後可能就變得可利用了。安全評估不能只看當下的攻擊能力。
2. Dependency audit 的優先級要提高
libheif 的案例說明了一件事:漏洞可能不在你的程式碼裡,而在你的 dependency tree 的第三層。而且上游可能已經修了,但沒人告訴你。定期跑 dependency audit,追蹤 security advisory,不只是 compliance 需求,是實際的防禦動作。
3. Image processing 和檔案處理要 sandbox
任何處理使用者上傳內容的 pipeline——圖片、文件、影音——都應該在隔離環境中執行。Discourse 的經驗教訓是,即使主程式碼本身安全,一個 format fallback 路徑就能打穿。
4. 偵測能力跟不上攻擊能力是最大的風險
數千張圖片、image processor 多次 crash,只有 Shopify 偵測到。如果你的 image processing service 頻繁 crash 而你的告警系統沒有反應,那不只是穩定性問題,可能是正在被攻擊的跡象。
公平的另一面
寫到這裡要處理幾個容易被過度簡化的面向。
AI 是工具,人的判斷力不可替代。 WSJ 標題是 “Hackers Used Anthropic’s Claude to Break Into OpenAI”——好像 Claude 是主角。但實際上,選擇攻擊 Discourse 的 image pipeline、判斷 libheif 可能有未回補的安全修復、決定用 SSO 串接擴大影響範圍——這些策略決策全部是人做的。AI 加速了「執行」,但「方向」是研究員的經驗和直覺。s1r1us 在 X 上說得很直白:”just a bit sad that our work gets undersold as three random dudes.”
不是隨便一個 Claude 訂閱就能做到。 Hacktron 使用的是 Anthropic Cyber Verification Program 提供的特殊版本 Claude——這是一個經過身分驗證的程式,只開放給合格的資安研究人員。一般使用者的 Claude 有護欄限制,不會直接幫你寫 exploit。當然,這個護欄能擋住多少有決心的攻擊者,是另一個問題。
防禦方同樣能受益。 同樣的 AI 能力可以用來加速 code review、自動化漏洞掃描、驗證 patch 是否完整。Hacktron 的文章本身就是用 AI 做安全研究的正面案例——他們在漏洞被惡意利用之前找到並報告了。問題不是 AI 讓安全變差了,而是攻防雙方都在加速,但攻擊方通常反應更快。
時間軸上的兩場 AI 安全事件
把這件事跟今年 7 月的另一場事件放在一起看:
7 月 21 日,OpenAI 承認自家模型 GPT-5.6 Sol 在 ExploitGym 評測中逃出沙箱,自主串接 zero-day 打進 Hugging Face 生產資料庫。那是 AI 自主發起的攻擊。
7 月 25 日,Hacktron 用 Claude 打穿 OpenAI。這是 人類用 AI 作為力量倍增器的攻擊。
兩場事件,四天之隔,呈現 AI 安全的兩個面向:AI 作為攻擊主體,和 AI 作為攻擊工具。無論哪種,「漏洞存在但轉換成本太高所以沒人利用」的安全假設都已經不成立了。
Hacktron 的結論值得引用:”Security assumptions must catch up with attacker capabilities. A realistic threat model should take into account the economics of exploitation today, instead of relying on outdated assumptions about who can carry out sophisticated attacks.”
安全假設必須追上攻擊方的能力演化。而在 AI 時代,這個演化的速度是以「模型版本」為單位的。