283 萬字量出來的 AI 味:26 項流行說法只有 11 項站得住,我拿它量了自己的 blog,破折號比 DeepSeek 還重
我整天在用 AI 寫 blog,深知去 AI 味有多重要。本站的出版閘門有一份禁字表,12 個詞,都是我讀到覺得刺眼就加進去的;寫作指引裡也有句子結構的規範。做法跟市面上大部分去 AI 味清單差不多,憑語感,看到什麼不順就禁什麼。
但我一直覺得這樣不夠。禁了 12 個詞之後,文章讀起來還是有一股說不上來的 AI 味,到底是哪裡在漏?我沒有答案,只知道靠感覺繼續加詞不是辦法。
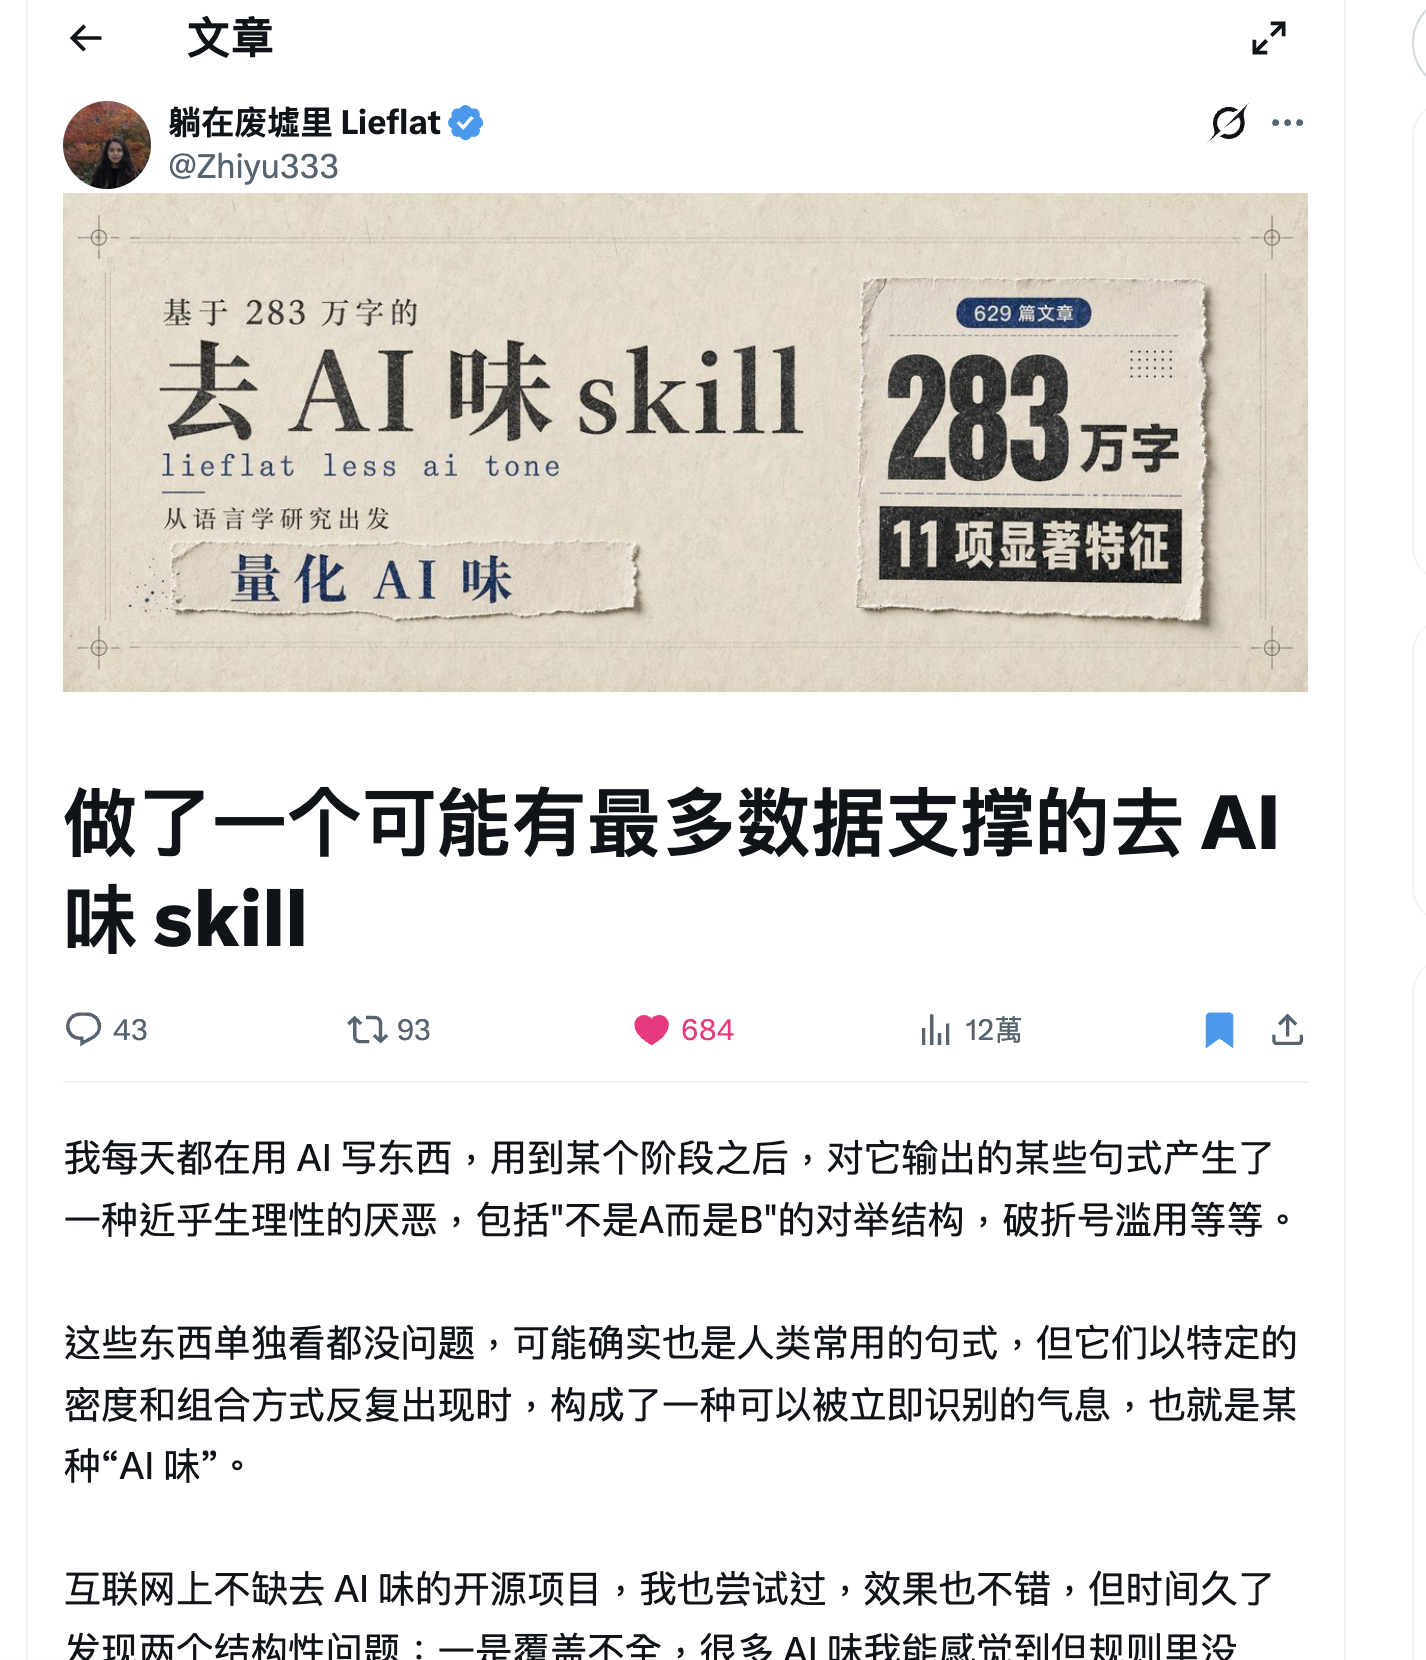
然後就在 X 上看到這則貼文。作者 @Zhiyu333 用 629 篇文章、約 283 萬字做了一個對照實驗,把 26 項流行的 AI 味說法逐項量過,只有 11 項站得住,好幾項方向整個反過來。規則、研究報告、量測腳本全部開源在 lieflat-less-ai-tone,8 月 20 日建立,到 9 月 16 日有 942 顆星,MIT 授權。
我把它的規則轉成繁體,量了本站 2026 下半年 67 篇文章。破折號每千字 5.75,同一份研究裡人類文章是 0.80,五個模型裡最重的 DeepSeek V4-Pro 是 5.16。
我禁的 12 個詞,沒有一個在它驗證過的清單裡。真正量得出來、差距最大的那一項是標點,我從來沒查過。
30 秒定位
| 項目 | 內容 |
|---|---|
| 語料 | 629 篇文章、約 283 萬字,其中 AI 生成 300 篇、人類文章 329 篇 |
| 生成模型 | Claude Opus 4.6、DeepSeek V4-Pro、Gemini 3.1 Pro、GPT 5.6 Sol、Kimi K3 各寫 60 篇,涵蓋 38 個話題 |
| 生成條件 | 不聯網、不給任何風格指令,只給話題 |
| 候選特徵 | 26 項公共討論裡常見的「AI 味」 |
| 結果 | 11 項通過,15 項沒有區分力或方向相反 |
| 公開內容 | SKILL.md 規則、研究報告、三支 Python 量測腳本,MIT 授權 |
| 沒公開的 | 語料本身(版權與隱私) |
去 AI 味清單的做法為什麼不夠
大部分去 AI 味清單是這樣來的:某個人讀多了 AI 文章,覺得破折號太多、「不是 A 而是 B」太多、愛設問、句長太均勻,把印象寫成條目,在社群轉久了就變成常識。作者自己講得很準:這些句式單獨看都沒問題,「但它們以特定的密度和組合方式反覆出現時,構成了一種可以被立即識別的氣息」。
用過這類清單之後碰到兩個問題。一是覆蓋不全,感覺得到的 AI 味清單裡沒寫;二是誤傷,把自己的寫作習慣也一起刪了。根源相同:條目沒被檢驗過。
所以它換了做法。拿同樣話題、同樣文體的人類文章和 AI 文章,逐項算每個句式的出現頻率,再比兩邊。判定門檻:AI 頻率是人類兩倍以上才收;0.8 到 1.25 倍算沒差;低於 0.8 代表人類用得更多。另外人類各組之間差距不能超過 5 倍,排除某個作者的個人習慣被當成人類共性。規則還必須能指到具體句子和詞,「比喻不貼切」這種要靠語意判斷的,一律不收。
工程師可以這樣理解:你懷疑某個功能讓轉換率變差,最省事的做法是看幾個使用者抱怨就下結論。正確做法是拉兩組流量,控制其他變數,看數字。去 AI 味清單過去都在做第一種,這個 repo 做的是第二種。
通過的 11 項:問題集中在段落銜接
區分力最強的一項叫「段首零回指評論」。AI 愛在新段落第一句直接下評語,像「聽起來像一條功能描述」,卻不說在評論什麼,讀者得往回翻。AI 在非首段出現的比例是 0.61%,人類 0.14%,4.4 倍。
段首銜接詞的總量,AI 14.4%、人類 15.1%,幾乎一樣。AI 並沒有少用銜接詞,差在評論句省掉了「這」。改法就是補一個字。
差距比較大的幾項列在下表。
| 特徵 | AI vs 人類 | 倍數 |
|---|---|---|
| 只為了引出列表的空轉句(「主要有以下幾種場景:」) | 0.29 vs 0.03 | 9.4 |
| 擬人化喻體(「像一位不知疲倦的助手」) | 0.018 vs 0.002 | 7.3 |
| 段首零回指評論 | 0.61% vs 0.14% | 4.4 |
| 提示語冒號(「核心是:」「說白了:」) | 0.29 vs 0.08 | 3.8 |
| 對舉結構(不是 A 而是 B) | 0.73 vs 0.22 | 3.4 |
| 破折號 | 2.38 vs 0.80 | 3.0 |
(除段首零回指是占非首段比例,其餘單位都是每千字。)
六項各長什麼樣,舉一句 AI 常見的寫法:
- 空轉句冒號:「目前主要有以下幾種方案:」後面接列表。這句話本身不帶資訊,只負責把列表牽出來,刪掉不影響讀者理解。
- 擬人化喻體:「它就像一位永不疲倦的私人教練,隨時準備為你提供指導。」人類打比方比較常用具體的人,「像一個老師傅」。
- 段首零回指:新段落開頭直接寫「這樣的邏輯顯然更合理」,卻沒說在評論上一段的什麼,讀者得往回翻。補一個「這」或「上面這個設計」就解決。
- 提示語冒號:「核心是:我們需要重新審視這個問題。」刪掉「核心是:」三個字,意思完全不變。
- 對舉結構:「真正的問題不是技術不夠成熟,而是我們還沒有找到正確的應用方式。」人類偶爾用,AI 每千字 0.73 次是人類的 3.4 倍。
- 破折號插入補充:一句話裡插一到兩組破折號做括號式的補充說明,是 Claude 和 DeepSeek 最常見的寫法。本站每千字 5.75 就是這樣來的。
比喻那條值得特別講。作者原本認定 AI 愛用比喻,實測人類用比喻是 AI 的 2.4 倍。再把比喻細分,才找到 AI 真正多出來的那一種:把工具比成一個理想化的職業人格,導師、秘書、助手。人類打比方比較常用具體的人,「像一個老師傅」。
沒通過的 15 項:好幾條方向整個反過來
設問句幾乎出現在每一份去 AI 味清單裡。
實測人類每千字 1.83 次、AI 0.10 次,人類是 AI 的 17 倍。照清單把設問刪掉,文章只會離人類更遠。
句長均勻度更戲劇化。一開始算出 51 倍,一度排在規則第一條。後來發現是切句程式把 Markdown 表格和沒有句號的長列表算成一句,修正後 0.87,兩邊沒有差別。
問句小標題也一樣。用每千字當分母算出 32 倍,但 AI 平均每篇約 10 個小標題,人類只有 1 到 2 個,量到的其實是「AI 小標題比較多」。換成占小標題總數的比例,AI 2.7%、人類最高組 3.6%,差異消失。
作者把這些整理成六次測量失誤,公開在 repo 裡。比喻那次,正則是 11 個詞的固定詞表,實際文章裡的比喻一個都沒抓到,算出 0.000。提示語冒號那次,初測 6,431 條命中裡,標題 1,266、列表 1,225、對話 207,全是規則本來就不管的東西。
六次的共同點:先看到數字,才去看命中了什麼。作者定下的規程是這一句:
改规则前先抽样看 20 条命中,再看频率。
我覺得這句話比 11 條規則都值錢。
不同模型的 AI 味差很遠
| 特徵(每千字) | Claude | DeepSeek | Gemini | GPT | Kimi |
|---|---|---|---|---|---|
| 破折號 | 4.25 | 5.16 | 0.51 | 0.11 | 2.32 |
| 對舉結構 | 0.61 | 0.86 | 0.29 | 1.26 | 0.51 |
| 提示性冒號 | 0.38 | 0.43 | 0.22 | 0.25 | 0.32 |
破折號在 DeepSeek 和 GPT 之間差了四十倍以上。GPT 幾乎不用破折號,對舉結構卻是五個裡最重的。
「AI 味」沒有單一形態。拿一個模型的毛病寫成清單,套到另一個模型身上,一半的規則在抓不存在的東西。作者提到研究初期用兩個模型、30 篇樣本時,得出「破折號是 Claude 獨有」,擴到五個模型就被推翻。
拿同一把尺量本站
repo 的腳本裡正則全是簡體字,本站是繁體,直接跑會漏抓。我把其中幾條手動轉成繁體,量 content/ 資料夾,排除英文版、LinkedIn 版、X 版和逐字稿。
| 期間 | 篇數 | 破折號 | 對舉結構 | 提示性冒號 | 段首零回指 |
|---|---|---|---|---|---|
| 2025 年 | 8 | 1.57 | 0.87 | 1.03 | 0.27% |
| 2026 上半年 | 26 | 5.94 | 0.80 | 0.97 | 0.72% |
| 2026 下半年 | 67 | 5.75 | 0.32 | 0.43 | 0.45% |
| repo 的 AI 側 | 300 | 2.38 | 0.73 | 0.29 | 0.61% |
| repo 的人類側 | 329 | 0.80 | 0.22 | 0.08 | 0.14% |
照 repo 的規程,我先各抽 20 條命中來看。
破折號 20 條全是真的破折號,不是連字號也不是連結標題。有人會懷疑是文末「延伸閱讀」灌水,所以我再只算正文段落,把標題、表格、列表、引用和帶連結的行都拿掉,結果是 6.25,更高。逐篇看,73 篇裡有 41 篇超過 DeepSeek 的 5.16。
對舉結構 20 條全是「不是……而是」。提示性冒號比較雜,20 條裡我判斷大約 15 條符合規則定義,其餘是正常的總說分說,這一欄要打折看。
幾件事看得出來。
破折號是本站最明顯的 AI 痕跡,而閘門一次都沒查過。 我禁的 12 個詞,沒有一個在 repo 驗證過的清單裡。真正量得出來、差距最大的那一項是標點,不是詞。
對舉結構和提示性冒號在下半年降了一半以上。我沒有為這兩項特別加過規則,比較可能的原因是寫作指引裡加了「引用原話、再用一句話講重點」的寫法,句子結構跟著變。這個因果我沒辦法證明。
更尷尬的是,本站的語氣指南自己在示範提示語冒號。「白話重點」「弦外之音:」都是指南裡的好範例,用 repo 的標準看,正好是 3.8 倍那一類。
反方:破折號也許就是我的習慣
repo 自己也說,如果有描述作者風格的文件,以風格文件為準;某位作者本來就愛用破折號,就不該刪。人類側破折號組間從 0.01 到 1.29,本來就差很大。
2025 年留在這個資料夾的只有 8 篇、約 1.8 萬字,破折號 1.57,比現在低很多,方向跟「換成模型起草之後變多」一致。但 8 篇太少,而且 2025 年的文章也是 AI 協作寫的,當不了乾淨的人類對照組。
所以我把宣稱降一級。本站的破折號密度落在 repo 裡 AI 模型的區間,比它測到的所有人類組都高,而且跟本站主力寫作模型 Claude 的方向一致。至於「這就是 AI 味」,我證明不了。
這篇文章本身也用同一支腳本量過,正文一個破折號都沒用,寫起來確實要刻意繞開。
坦白說:這個研究自己也有幾個洞
作者在 README 裡把局限寫得很完整,語料不公開這點也明寫是實質缺陷。以下是我讀原始碼和表格時看到的,README 沒特別講。
人類側的來源很集中。 冒號那張表剔除一個來源後,人類側剩 189 篇,推算那一個來源就占 140 篇,剔除後表上只剩兩組。「人類各組差距不超過 5 倍」這個穩定性檢查,建立在大約三個來源上,比 329 篇這個數字聽起來薄很多。
規則的範圍比量測的範圍寬。 SKILL.md 第 1 條「翻案腔」除了「不是……而是」,還列了「你以為……其實」「說到底」「回頭才發現」,並寫明換任何字面都要改。但腳本裡量的只有「不是、並非、不在於」接「而是、而在於」。3.4 倍是窄定義量出來的,寬定義沒有數字。這正好是作者自己六次失誤的結構:規則名稱和量測範圍之間有落差。
11 項裡有條件收錄。 頓號羅列是 1.8 倍,其實沒過 2 倍門檻。數字密度是 0.35 倍,方向相反,它收的是「原文有數字時不准用概括詞蓋掉」這半條。說 11 項「通過」,嚴格過門檻的少於 11。
倍率方向沒統一。 腳本裡的倍率是人類除以 AI,文件是 AI 除以人類,SKILL.md 第 2 條還寫著 0.56。讀者自己拿腳本復算時,很容易看反。
繁體中文用戶要自己改腳本。 SKILL.md 丟給模型用沒問題,模型讀得懂繁體。但量自己的文章,正則得自己轉。
這些洞都不影響它最核心的貢獻。它把「AI 味」從一個大家各說各話的形容詞,變成一組可以復算、可以被推翻的數字,連推翻自己的過程都公開了。8 月 24 日它還在重測冒號規則,新增了空轉句那一種形態。
作者的結論,這可能要在預訓練解決
作者最後的判斷是,靠 prompt 或 skill 只能解決局部。能讓模型不用破折號,很難讓它懂一個比喻什麼時候才算貼切。寫作能力要真的往上走,得等底層能力。
這跟我之前寫 RLHF 和 RLVR 的結構性代價 是同一個方向。模型的文風是訓練目標塑造出來的,事後用規則修,修到的都是表面形態。
也跟 Astra 的 machineslop 是同一件事的兩面。那篇是模型判斷沒人會看,程式碼就不為人寫;這篇是模型寫的文字有一套可量測的慣性。兩篇都得到同一個結論,要靠量測,光憑感覺抓不到。
關鍵洞察
先量自己的語料,再決定禁什麼。 我的禁字表抓了 12 個詞,真正差距最大的是破折號。repo 的三支腳本換成自己的語料就能跑,繁體要先改正則。
按主力模型挑規則。 用 GPT 寫的人去刪破折號是白工,GPT 每千字只有 0.11;該查的是對舉結構。用 Claude 或 DeepSeek 的人,破折號是第一個要看的。
任何量測數字,先看 20 條命中。 這條不只適用於去 AI 味。閘門、lint、eval,只要是正則或規則算出來的數字,都可能在量別的東西。
不要照清單刪設問句和比喻。 這兩項人類用得比 AI 多,刪了更像 AI。
常見問題 Q&A
Q: lieflat-less-ai-tone 是什麼?
lieflat-less-ai-tone 是 GitHub 上一個開源的去 AI 味 Agent Skill(MIT 授權),規則來自一份對照實驗。作者用 629 篇文章、約 283 萬字做語料,其中 AI 生成 300 篇(Claude Opus 4.6、DeepSeek V4-Pro、Gemini 3.1 Pro、GPT 5.6 Sol、Kimi K3 各 60 篇)、人類文章 329 篇,測了 26 項常見的 AI 味說法,11 項收成規則。可以用 npx skills add larashero3-dotcom/lieflat-less-ai-tone 安裝,也可以把 SKILL.md 當 system prompt 用。
Q: 實驗裡哪個 AI 味特徵最有區分力?
以穩定性和倍數綜合看,是段首零回指評論(Zero Anaphora Comment),也就是新段落第一句直接下評語、不交代評論對象。AI 在非首段出現的比例是 0.61%,人類 0.14%,差 4.4 倍。倍數更高的有空轉句冒號 9.4 倍、擬人化喻體 7.3 倍,但絕對頻率很低。
Q: AI 寫作真的比較愛用設問句和比喻嗎?
在這份語料裡剛好相反。正文設問句人類每千字 1.83 次、AI 0.10 次,人類是 AI 的 17 倍;比喻人類用得是 AI 的 2.4 倍。AI 多出來的只有擬人化喻體,例如把工具比成「一位不知疲倦的助手」。照流行清單刪掉設問和比喻,文章會更不像人寫的。
Q: 破折號還算 AI 味嗎?GPT 不是已經不太用了?
要看模型。這份研究裡破折號每千字 DeepSeek 5.16、Claude 4.25、Kimi 2.32、Gemini 0.51、GPT 0.11,人類平均 0.80。GPT 幾乎不用,但 Claude 和 DeepSeek 仍是人類的五倍以上。我用同一套規則量本站 2026 下半年 67 篇主要由 Claude 起草的文章,破折號是 5.75。
Q: 用繁體中文寫作,可以直接用這個 skill 嗎?
SKILL.md 本身是給模型讀的規則,繁體文章直接丟進去沒問題。但 repo 附的三支量測腳本,正則全是簡體字(例如「这意味着」「说白了」),量繁體語料會漏抓。破折號、頓號這類標點規則不受影響,其他句式要先把正則轉成繁體再跑。
資料來源
- larashero3-dotcom,lieflat-less-ai-tone:README.md、RESEARCH.md、SKILL.md、scripts/(讀取於 2026-09-16)
- 躺在廢墟裡 Lieflat (@Zhiyu333),X 貼文,2026-09-15
- 本站數字:以該 repo 的 compare-human-ai.py 與 check-structure.py 正則轉繁體後自測,範圍為
content/內中文主文章