頂級 VC 怎麼看 2026 年現在的 AI:AGI 已至,但是落地的落差越來越大
七個案例。Sequoia 平均以 1.1 億美元 post-money 進場;一個月內,資本夥伴進場的平均價格是 34 億美元。
約 31 倍。一個月。
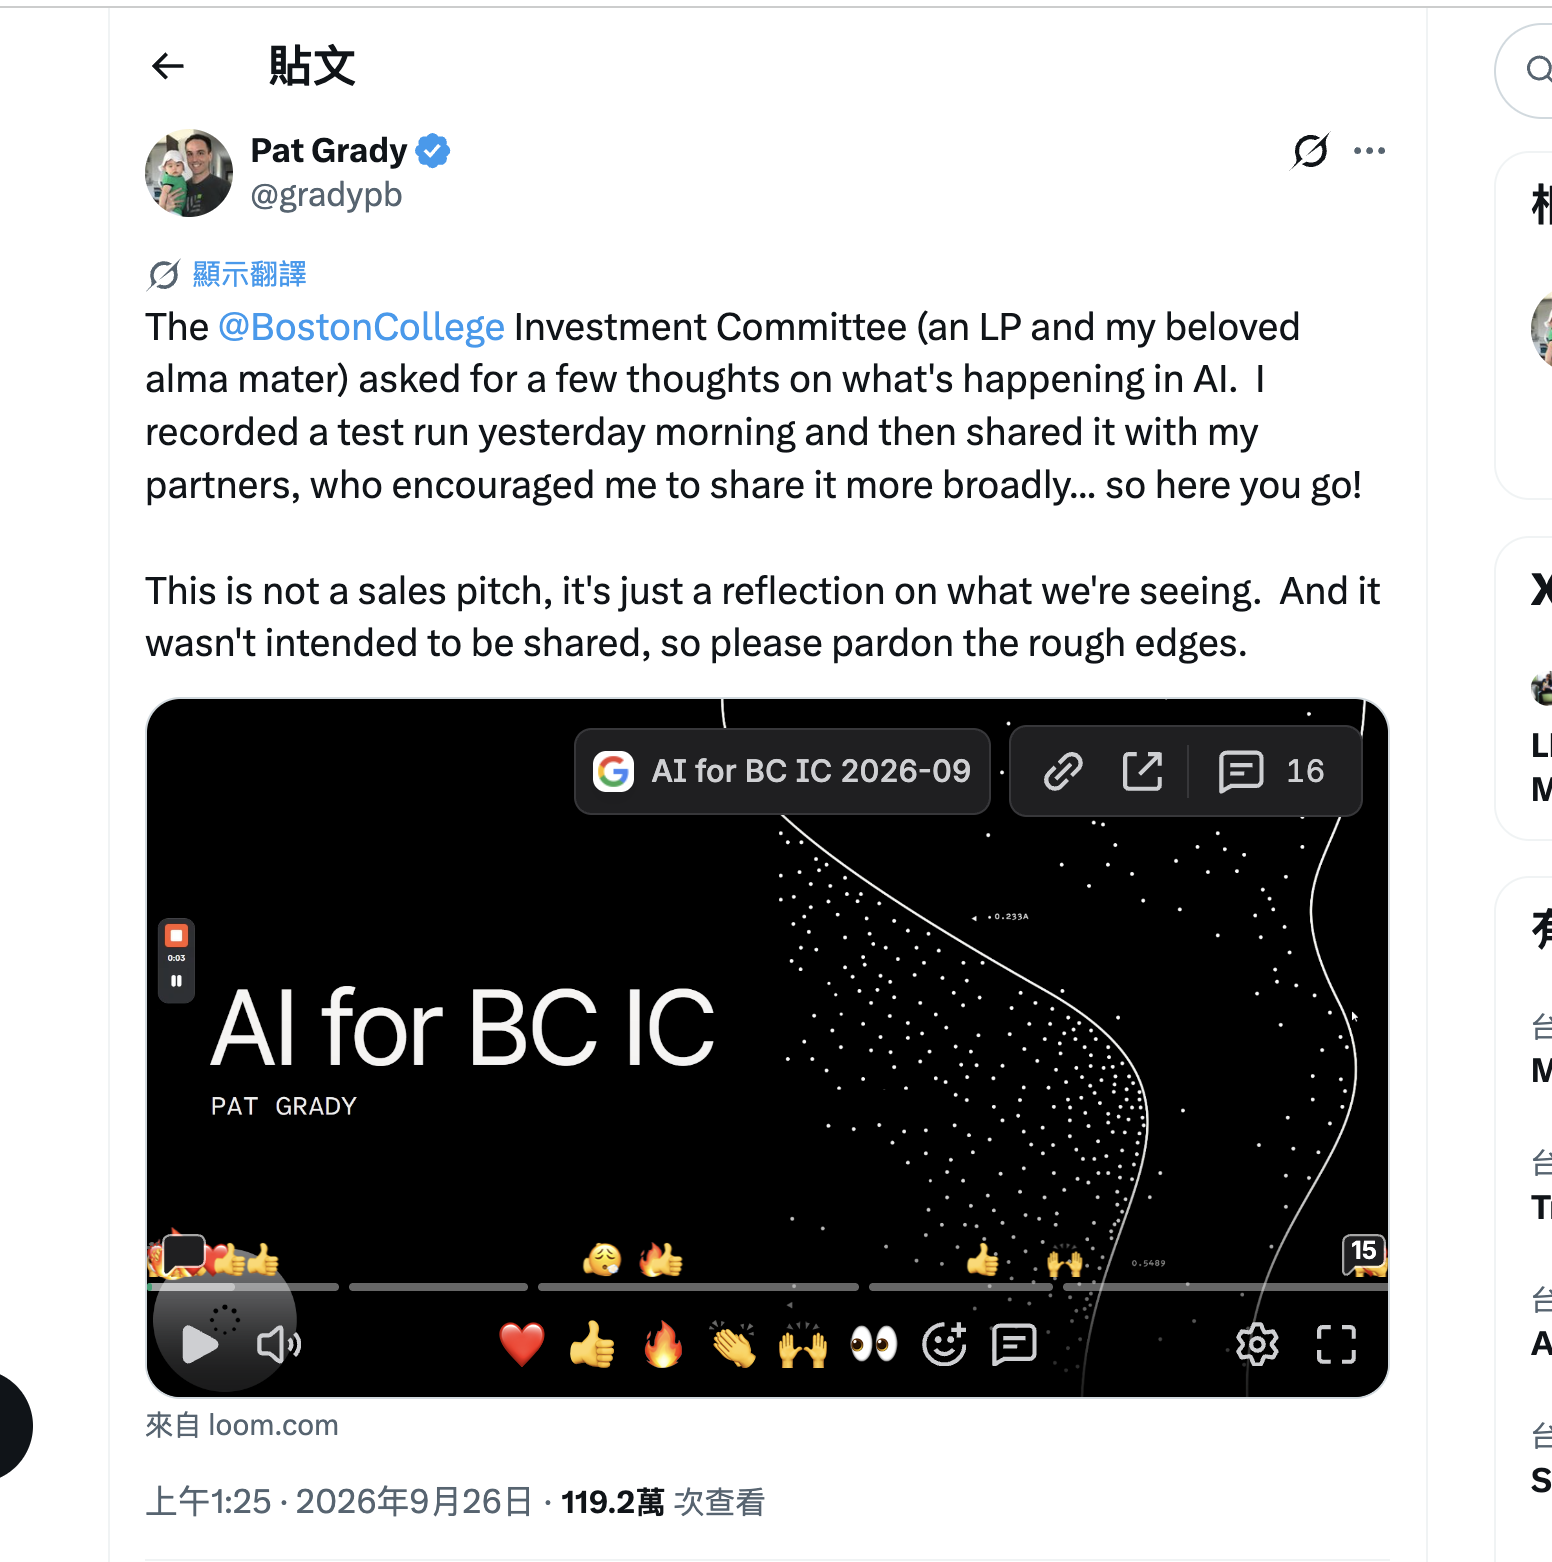
這是 Pat Grady 九月二十四日錄的一支 15 分鐘 Loom 裡,倒數第二張投影片的內容。他是 Sequoia 的負責人之一,這支影片原本是給母校 Boston College 投資委員會看的——Boston College 是 Sequoia 的 LP。錄完給合夥人看,後來公開在 X 上。
他講完那組數字,自己下了結論(繁中翻譯):
這是我們前所未見的事,也充分代表市場的泡沫。
一個 VC 當著出資人的面說泡沫,這件事本身就值得逐張拆開看。
30 秒定位
| 項目 | 內容 |
|---|---|
| 講者 | Pat Grady,Sequoia |
| 對象 | Boston College 投資委員會(Sequoia 的 LP) |
| 錄製日 | 2026-09-24(講者口述) |
| 長度 | 15 分鐘 |
| 結構 | 科技浪潮史 → 三個轉折點 → 好/壞/醜 → 實驗室信念 → 擴散落差 → 應用層 → 營運 → 估值 |
| 最硬的數字 | 七個案例:Sequoia 平均 1.1 億美元進場,一個月內下一輪平均 34 億美元 |
| 不能驗證的數字 | 被點名或未具名公司的營收與成長率,全是口述 |
他怎麼定義「現在」
Pat 的時間軸很乾淨,三個點:
- 2022 年 11 月:預訓練的力量
- 2024 年末 OpenAI 的 o1:推理的力量,系統一和系統二思考
- 去年秋天的 Claude Code 和 Opus 4.5:長時程代理人的力量
前兩個點是連續的進步,第三個他認為是跳躍。今年一月 Sequoia 發了一篇〈2026: This is AGI〉,Pat Grady 和 Sonya Huang 合寫,用的是功能性定義:能自己把事情搞清楚、能規劃、用工具、循環到目標達成,就是 AGI。他說當時大家有點嘲笑他們,到了九月這已經是共識。
他用的類比是「更快的馬」和「汽車」。過去幾年的 AI 是更快的馬,本質還是軟體,只是比較好用。現在是汽車,運送你的方式根本不同。
他舉的證據是兩個消費端產品:Instinct(Noah Shinn 創辦,八月估值 25 億美元,傳出正談 100 億估值)和 Meta 九月上旬推出的 Muse。他的說法是這兩個東西「…從一個 app 變成一名助理」,不是處理任務,是把工作做完。
他拿 Zoom 類比。視訊會議早就存在,但沒人信任它,Zoom 是第一個跨過信任門檻、讓人預設用它開會的產品。AI 替你做事的理論早就有了,跨過信任門檻才是今年的事。
這個框架我同意一半。信任門檻的說法是對的;「汽車已經出現」則是用消費端兩個產品去推整個經濟,中間跳過了企業導入那一大段。這一段他自己後面也承認了。
實驗室的兩個生意:賣 token,和派人去燒 token
實驗室內部信念那段,Pat 用了奧卡姆剃刀:這些人不擅長公共溝通,所以他們講的話聽起來刻意或矛盾時,大概就是在陳述真實意見。AGI 到了、接下來追 ASI、模型過去一年大部分時間在建造自己(RSI,遞迴式自我改進)、對齊是真問題——所以才有九月十二日 Dario Amodei 那篇〈We Must Pace the Frontier〉。
這段都是轉述別人,我比較在意的是商業層那兩句。
第一句:token 競爭很激烈,大量消耗 API 的公司數量有限,實驗室一直削價搶。
第二句:實驗室設了「部署小隊」,讓一整批顧問進入財星 500 大企業,打造會消耗 token 的客製化應用。
第二句要重讀一次。
本 blog 寫過好幾篇 FDE(Forward Deployed Engineer,駐場工程師),核心論點是複雜領域的 AI 導入要靠人駐場,不是靠 SaaS 自動化。Pat 這段話證實了這件事——連模型實驗室都得派人進企業,產品本身不會自己擴散。
但他同時說出了動機:部署小隊是 token 競爭的另一種手段。 駐場的人要對誰負責,決定了他會替你做出什麼。一個 KPI 是「企業問題有沒有解決」的 FDE,和一個 KPI 是「客戶月消耗多少 token」的 FDE,在同一個需求面前會給出不同的架構。前者會問「這個判斷需不需要大模型」,後者不太會問。
擴散落差:他整支影片真正的論點
模型能力與實際採用之間有巨大落差;我們稱之為「擴散落差」(diffusion gap)。
這是整支影片的承重牆,也是他給 LP 的投資邏輯:實驗室的能力已經到了,企業還沒用上,中間那段距離就是應用層新創的機會。
他列的機會清單:
- 高價值知識工作:程式設計、資安、醫療、金融服務、會計,每個主要領域會出現一家巨型公司
- 新的記錄系統(systems of record):雲端時代的 ServiceNow、Workday、Salesforce,這次轉型會有新的一批
- 前沿科學:他點名 Chai(Chai Discovery)。Chai-2 在完全從頭設計抗體上做到 16% 命中率,官方說比過去的計算方法高 100 倍以上
- 新型實驗室:不需要另一家通用型,需要垂直領域或新架構的,他舉 Jev
這張清單跟前面的「汽車已經出現」其實互相拉扯。如果汽車已經到了,擴散落差應該很小;擴散落差大,代表多數企業還在騎馬。他在前半段說 AGI 到了,後半段說大家還沒用上,兩句都成立,但後一句才是他要募資的理由。
那些成長數字,我只能驗證一半
投影片上的成長數字,Pat 邊講邊說「其實,我們之後會改這幾張投影片」:
- Instinct:日成長率仍持續超過 10%
- 某家高價值知識工作公司:去年底營收約 2 億,今年約 7 億
- 另一家同類公司:200 萬到 5,000 萬
- Jev:過去七天從零成長到一億美元營收
後三個都沒有公開數字可以對。Jev 可以,因為 Jev 的定價是公開的:每百萬輸入 token 0.042 美元,輸出不收費。
拿這個價格反推,七天一億美元營收需要約 2,380 兆個輸入 token,平均每天約 340 兆。
這個量級我找不到任何公開的對照可以讓它成立。公開報導能查到的是估值:傳出以 100 億美元估值洽談 10 億美元以上的新一輪,營收沒有揭露。
幾種可能:他講的是年化 run-rate、是合約承諾金額、是 Whisper 轉錄把某個詞聽錯了,或者單純口誤。我沒辦法判斷是哪一個。但這件事有一個直接的含義:投影片上唯一能用公開定價去核對的營收數字,核對不過。 其他未具名的數字,你只能選擇相信或不相信。
「Own your intelligence」:Sequoia 兩個月內第二次講
營運段有一個趨勢叫「擁有你自己的智慧」(own your intelligence)。
八月 Sonya Huang 在 Sequoia 活動上講 not your weights, not your product,那次的理由是領域性能:開源基線夠高了,在你的資料上 post-train 可能比 API 更強。
Pat 這次換了理由。他明說不是因為怕基礎模型,也不是 GDPR:
…只是因為基礎模型只佔據「價格—效能」帕累托前緣上的幾個點。
這個說法比八月那次更精確,也更難反駁。前沿模型是曲線上最右上角那幾個點——最強、最貴。你的工作負載分散在整條曲線上,大部分工作不需要最強的點。Jev 本身是這個論點的例子:多選判斷這種工作,放到一個不寫字的專用模型上。
八月那篇我寫過 VC 推這個論點有位置利益——被投公司自建越多,infra、fine-tuning、data pipeline 那一層的新創越多。這次的帕累托版本把位置利益藏得更好,但它技術上是對的:工作負載該按「需要多少能力」分流,不是全部丟給同一個最強模型。 這條和你買不買 VC 的帳無關,單獨成立。
每四個月重新發明自己
營運段還有兩句我覺得對台灣團隊最實用。
第一句:真正有效的應用層公司,每四個月就得重新發明自己。原因是前面講的技術地板在腳下移動,每移動一次,產品的假設就要重來。
第二句:多數公司採取實驗室式做法,把組織從「最弱環節遊戲」變成「最強環節遊戲」——挑出最強的人、保護他們、放手讓他們推。
然後他提到組織結構更像代理人網路,「情況還沒有 Jack Dorsey 幾個月前那篇貼文講得那麼戲劇化」。那篇是四月 Jack Dorsey 和 Sequoia 的 Roelof Botha 合寫的〈From Hierarchy to Intelligence〉,Block 同時裁掉約 4,000 人。Pat 引用的是自家合夥人參與寫的文章,這點記一下就好。
反方:他當著 LP 說泡沫,這不是很誠實嗎?
這是對我這篇最強的反駁,我先把它講完整。
一個 VC 在給出資人的簡報裡,主動用自家七個真實案例說市場是泡沫。這跟一般 VC 對外講「長期看好、估值合理」完全相反。他在 X 貼文裡自己寫:”This is not a sales pitch, it’s just a reflection on what we’re seeing.”他願意在影片結尾說「最後,我們不知道未來會怎樣」,也願意在壞的一面講 hyperscaler 開始靠舉債支撐資本支出——Epoch AI 估算,hyperscaler 的現金資本支出大約在 2026 年第三季超過營運現金流,這點有第三方數據對得上。把他的泡沫說法讀成話術,是不是太陰謀論?
我的回應是:誠實和位置利益,兩個同時成立。
看那張投影片的結構。1.1 億是「公司建設夥伴」的價格,也就是 Sequoia 的價格。34 億是一個月後「資本夥伴」的價格。泡沫在哪一層?在 34 億那層。Sequoia 在哪一層?在 1.1 億那層。
對一個 LP 來說,這張投影片的讀法不是「市場很危險」,是「市場很危險,但我們在泡沫下面 31 倍的位置進場」。它同時是一個誠實的警告,和一份非常有效的募資簡報。 這兩件事不衝突,所以他可以很誠實地講。
所以我不修正主論點,只把它講精確:他說的泡沫是真的,但那張投影片要回答的問題是「錢該放在哪一層」,不是「現在該不該進場」。
這改變了誰的什麼決策
台灣企業 CTO。
Before:等模型穩定一點再導入;挑一家 API 簽年約;請原廠或代理商派人來做 PoC。
After,依這支影片可以推出三個調整:
- 把「每四個月重評」寫進合約和架構。 如果應用層公司自己都要四個月重新發明一次,企業不該簽一個把模型綁死兩年的架構。模型呼叫要可替換,eval 集要能在換模型時重跑。
- 原廠派來的人,先問他的 KPI。 Pat 已經說了部署小隊是 token 競爭的手段。這不代表他們做得不好,但你要知道他們在架構選擇上天然偏向多用大模型。多選判斷、分類、路由這類工作,要自己問一句「這需不需要前沿模型」。
- 把工作負載攤在價格—效能曲線上。 列出系統裡所有 AI 呼叫,標上每個需要的能力等級。多數會落在不需要最強模型的區間,那一段才是 own your intelligence 真正省錢的地方。
坦白說
這篇的證據基礎比看起來薄。
來源是一支 15 分鐘影片的機器轉錄。 我拿到的是 Whisper 英文轉錄再翻成繁中,沒有英文原稿可核。文中引文都是繁中翻譯,不是他的原話。Instinct、Jev 這些名字是查證後才確認的,轉錄本身不可靠。
多數營收數字無法驗證。 七個估值案例、2 億到 7 億、200 萬到 5,000 萬,全部未具名,只有他自己的口述。唯一能用公開定價核對的 Jev 營收,核對不過。他自己也說會改投影片。
「AGI 已到」是他自己的定義。 那是 Sequoia 一月文章的功能性定義,不是業界共識的技術門檻。他說這已變成共識,這句話本身沒有數據支撐。
我對位置利益的解讀也是推論。 我不知道那七家公司是誰、Sequoia 在第二輪有沒有跟投、LP 的實際回報怎麼算。31 倍是帳面價差,不是實現報酬。
但這支影片做對了一件事:它把「擴散落差」講成一個可以投資的東西。 模型能力和企業採用之間的距離,過去常被當成「導入很難」的抱怨;他把它定義成一個機會的大小。對做 FDE、做企業導入的人來說,這個框架比任何一個成長數字都有用。
關鍵洞察
一、看到泡沫說法,先問說話的人在哪一層。 1.1 億和 34 億之間的差距,對 Sequoia 是價差,對 34 億那層的投資人是風險。同一張投影片,你在哪一層決定它是警告還是機會。
二、原廠部署小隊來了,先問 KPI。 Pat 已經公開說他們是 token 競爭的手段。他們能幫你導入,但「這個判斷需不需要大模型」這個問題,要你自己問。
三、把所有 AI 呼叫攤在價格—效能曲線上。 這是 own your intelligence 在技術上唯一站得住的版本,跟你買不買 VC 的帳無關。
四、架構要能每四個月換一次地板。 模型呼叫可替換、eval 可重跑。這是應用層公司的生存條件,對企業內部系統也一樣。
常見問題 Q&A
Q: Pat Grady 這支 AI 現況影片的核心論點是什麼?
Sequoia 的 Pat Grady 在 2026 年 9 月 24 日為 Boston College 投資委員會錄了一支 15 分鐘影片。核心論點是:長時程代理人(long-horizon agents)的出現代表 AGI 已經到了,但模型能力和企業實際採用之間存在巨大的「擴散落差」(Diffusion Gap),這段落差正是應用層新創的機會。他同時用七個真實案例指出估值泡沫:Sequoia 平均以 1.1 億美元進場,一個月內下一輪平均 34 億美元。
Q: 什麼是擴散落差(Diffusion Gap)?
擴散落差是 Pat Grady 用來描述「AI 模型已經能做到的事」和「企業與個人實際在用的事」之間的距離。實驗室端的能力已經能解數學定理、做長時程代理人,但多數企業還沒有真正導入。Sequoia 把這段距離視為應用層公司的市場大小,並預期高價值知識工作的每個主要領域(程式、資安、醫療、金融、會計)會各自出現一家巨型公司。
Q: 什麼是「擁有自己的智慧」(Own Your Intelligence),跟直接用 API 差在哪?
Pat Grady 的說法是:前沿基礎模型只佔據價格—效能帕累托前緣(Pareto Frontier)上的少數幾個點,即最強、最貴的那一段。企業的工作負載分散在整條曲線上,多數位置用自行後訓練的開源模型比直接用前沿模型的現成 API 更合適。這跟 Sequoia 的 Sonya Huang 八月講的 not your weights, not your product 是同一個方向,但理由從「領域性能」換成「成本曲線覆蓋」。
Q: 實驗室的「部署小隊」和 FDE 有什麼不同?
Pat Grady 描述實驗室派出一整批顧問進入財星 500 大企業,打造會消耗 token 的客製化應用,並明說這是 token 競爭的一種手段。形式上它和 FDE(Forward Deployed Engineer,駐場工程師)一樣是派人駐場,差別在 KPI:以解決企業問題為目標的 FDE 會優先問「這件事需不需要大模型」,以 token 消耗為目標的部署團隊在架構選擇上天然偏向多用大模型。企業在接受原廠駐場時,應該先釐清對方的績效指標。
Q: 影片裡 Jev 七天一億美元營收的說法可信嗎?
目前無法驗證。Pat Grady 口述 Jev 過去七天從零成長到一億美元營收,但 TypeSafe 沒有公開營收。用 Jev 公開的定價(每百萬輸入 token 0.042 美元,輸出不收費)反推,七天一億美元需要約 2,380 兆個輸入 token,平均每天約 340 兆,這個量級找不到公開對照可以支撐。公開報導能確認的是估值層面:傳出以 100 億美元估值洽談 10 億美元以上的新一輪。可能是年化數字、合約金額、轉錄誤差或口誤。
來源
- Pat Grady 的 X 貼文(內嵌 Loom 影片〈AI for BC IC 2026-09〉):https://x.com/gradypb/status/2103536289438130670
- Sequoia Partner Pat Grady Releases 15-Minute Video on AI Prepared for Boston College Investment Committee(ABAB News)
- 2026: This is AGI(Sequoia Capital)
- Rival AI agents, Instinct and Meta’s Muse, both add the ability to make calls(TechCrunch)
- TypeSafe AI reportedly raising $1B at $10B valuation(Sovereign Magazine)
- Hyperscaler Capex to Exceed Cash Flow by Q3 2026(Epoch AI)
- Dario Amodei — We Must Pace the Frontier
- Chai Discovery Releases All-Atom Foundation Model for Zero-Shot Antibody Design(BiopharmaTrend)
- Block — From Hierarchy to Intelligence
- Jack Dorsey says AI should replace the middle manager after Block cuts 4,000 jobs(CoinDesk)