Musk 把 22 萬顆 GPU 租給對手 Anthropic:這條大新聞,是 Claude 降智、Max Plan 燒光、5 小時變 2 小時的解藥
Musk 把 22 萬顆 GPU 租給對手 Anthropic:這條大新聞,是 Claude 降智、Max Plan 燒光、5 小時變 2 小時的解藥
先講這條 AI 戰國時代最戲劇性的大新聞
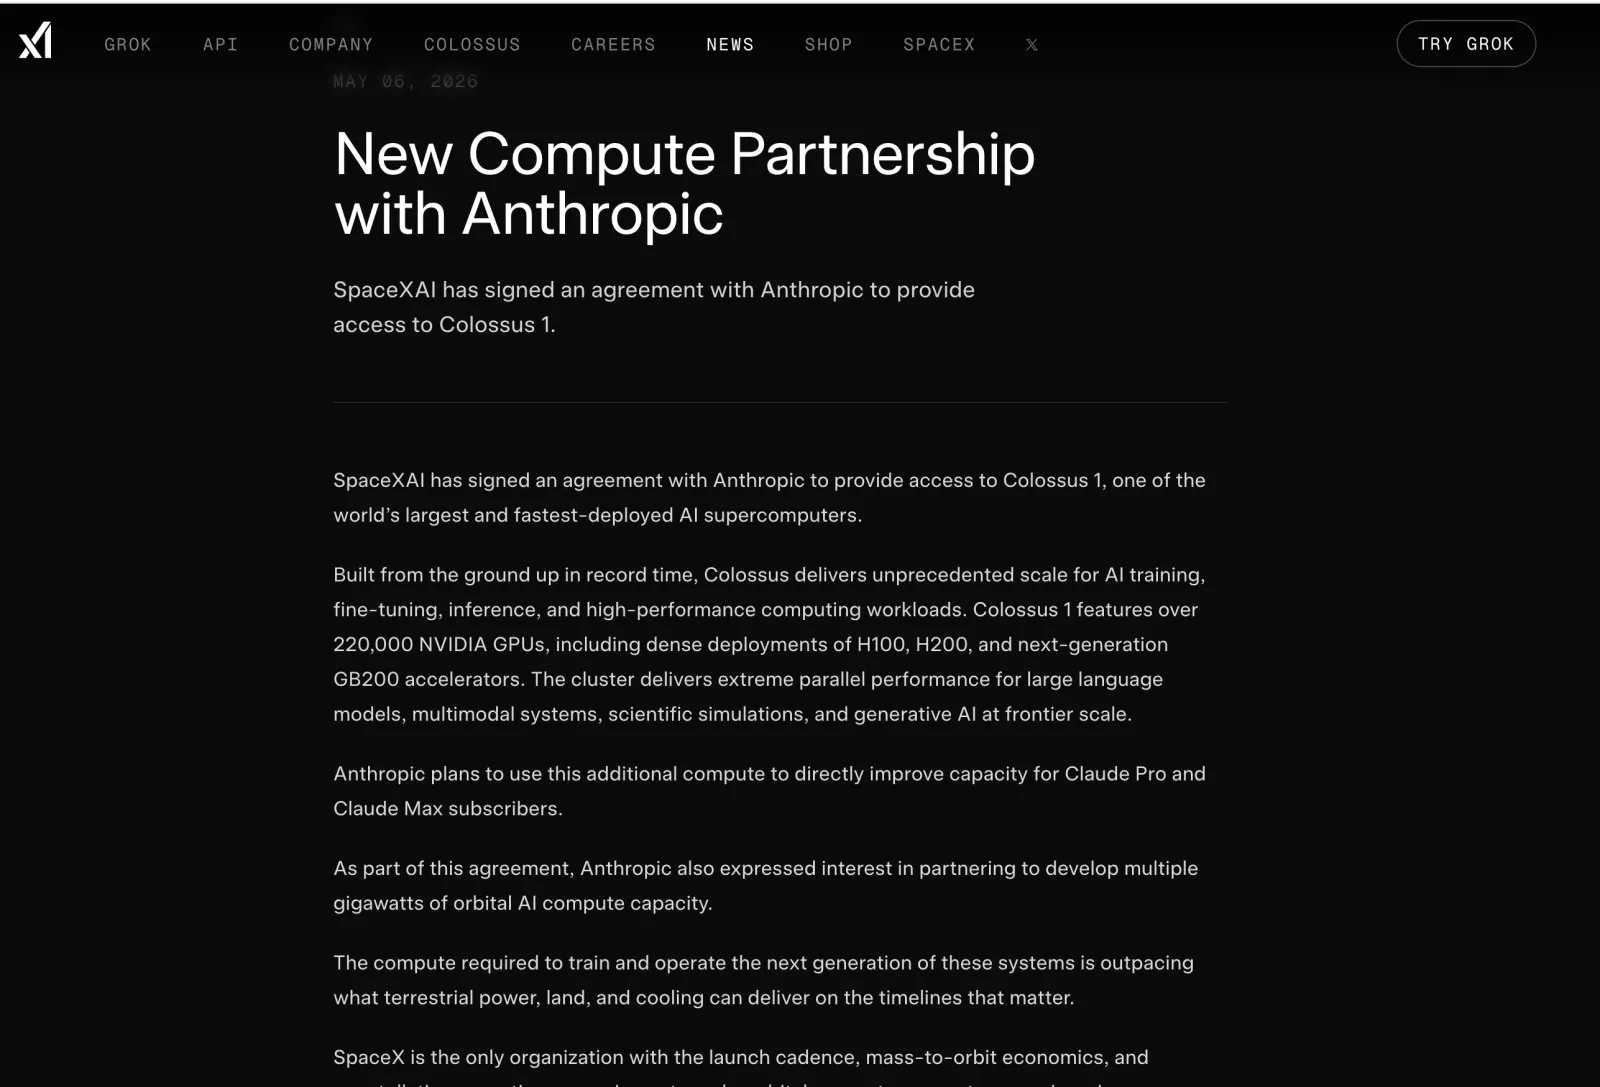
2026/05/06,Anthropic 官方公告:
SpaceX 把 Colossus 1 資料中心的全部算力,整批租給 Anthropic。1 個月內取得 300MW 新容量,超過 22 萬顆 Nvidia GPU(H100、H200、GB200)。
如果你只看數字,會以為這是又一筆「AI 公司簽算力」的常規新聞。
但這條新聞的戲劇性在於三件事:
- Colossus 1 是 Musk 旗下的(xAI 在今年 2 月被 SpaceX 全股票併購,更名 SpaceXAI)
- Anthropic 是 OpenAI 出來的人創的,跟 Musk 在帳面上應該是「敵對陣營」
- Musk 把整個 22 萬顆 GPU 規模的超算,整批租給競爭對手的競爭對手
這在半年前是不可能發生的。但 2026 年 5 月發生了。
而且,這筆交易不只是 AI 大公司的合縱連橫,它直接關係到你最近 Claude Code 用起來「越來越不對勁」的那種體感。
為什麼這是大新聞?因為過去幾個月 Claude 一直在「降智」
過去三個月,如果你是重度 Claude Code 用戶,應該對下面這些事很有感:
1. 5 小時上限突然變 2 小時
Anthropic 技術團隊 Thariq Shihipar 已經承認:
「為了因應 Claude 需求成長,Anthropic 在尖峰時段調整了 Free、Pro 與 Max 訂戶的 5 小時使用上限。」
翻譯成白話:他們偷偷在尖峰時段降額了。 同樣的工作量,以前可以撐滿 5 小時,最近大概 2 小時就達上限。
2. Opus 4.6 thinking 深度被砍 73%
我之前寫過 Opus 4.6 偷偷縮水那篇,用 17,871 個 thinking blocks 的數據做出來的結論:thinking 深度直接被砍 73%。
社群上的反應是這樣的:
「Claude Code Opus 4.6 just forgot its own features.」 — @om_patel5
「People are paying 20x more and getting worse performance.」 — Reddit r/ClaudeAI
Plan Mode 失效、程式碼品質斷崖式下降、推理一致性崩壞、工具呼叫失靈 — 這些都不是個別 bug,是系統性的衰退。
3. StupidMeter 數據:22 個模型只有 1 個是 OK
StupidMeter 24/7 監控 22 個主流模型,最新的 leaderboard:GPT 標 DEGR、Claude 標 WARN、Gemini 標 WARN、Grok 標 WARN、DeepSeek 標 WARN — 只有 GLM 一個 OK。
我之前那篇 LLM 降智不是都市傳說 講的就是這件事:模型品質不再是固定常數,是浮動變數。
4. Max Plan 燒光速度翻倍
訂閱沒漲價,但配額變相縮水。同一個任務丟下去,token 燒光的速度比三個月前快了一倍。
這四個現象,根源是同一件事:算力荒
降智、降額、燒光速度翻倍 — 表面看是四個獨立問題,底層其實是同一件事:
Claude 的需求成長速度,超過了 Anthropic 能取得的算力供給。
當算力不夠,Anthropic 只能做三件事擇一或同時做:
- 限制用戶用量(5 小時變 2 小時)
- 降低單位 token 的算力品質(thinking 深度砍掉、改路由到較弱模型)
- 拒絕新訂閱進來(但這會傷收入)
Anthropic 選了 1 + 2,所以重度用戶體感很差。
而這正是為什麼「Musk 把 22 萬顆 GPU 整批租給 Anthropic」這條新聞,對你我這些 Claude Code 用戶來說是真正有感的:
它不是抽象的「AI 公司算力布局」,它是直接對應到「你下次打開 Claude Code,5 小時上限會回來、降智會緩解」這種具體改善。
Anthropic 自己在公告裡也明確講了:
「這批新增容量將直接改善 Claude Pro 與 Claude Max 訂戶的可用容量。具體做法包括將 Claude Code 每 5 小時使用上限提高一倍,並取消 Pro 與 Max 帳戶在尖峰時段使用 Claude Code 時的降額限制。」
5 小時上限直接加倍。降額取消。Opus API 速率大幅提高。
對重度用戶來說,這是過去三個月最有感的好消息。
等等,Musk 為什麼會把算力租給 Anthropic?
在拆解硬體規格之前,這筆交易最反直覺的地方要先講清楚:Musk 為什麼會點頭?
畢竟,Anthropic 跟 Musk 旗下的 SpaceX/xAI,照理說是敵對陣營才對。
Anthropic 是 OpenAI 出來的人創的,而 Musk 跟 Sam Altman 鬧翻後自己另起爐灶搞了 xAI 跟 Grok,跟 OpenAI 互告了好幾輪。Musk 旗下的算力給 Anthropic 用,比給 OpenAI 用其實更不合直覺。
但仔細看,這筆交易反而非常合邏輯。至少有兩個原因。
1. 敵人的敵人就是朋友
Musk 跟 OpenAI 的恩怨已經不是新聞。從離開 OpenAI 董事會、創立 xAI、提告 OpenAI、到公開喊話要收購 OpenAI,兩邊關係徹底破裂。
在這個格局下,算力租給 Anthropic = 養大 OpenAI 最強的對手。
對 Musk 來說,這是商業上收得到錢、戰略上又能削弱 OpenAI 的兩面贏。錢是 Anthropic 出,傷的是 OpenAI 的市佔。
2. Colossus 的 GPU 利用率,其實沒打滿
這個角度比較少人講,但其實是更關鍵的原因。
xAI 蓋了號稱 10 萬顆 GPU 起跳的 Colossus 1,但攤開來看:
- Grok 的市場接受度沒打開:在企業跟開發者市場,Grok 還沒能跟 ChatGPT、Claude、Gemini 站在同一個量級。
- API 用量撐不起這麼大規模的算力:開發者不會每天都用 Grok 寫程式、做 agent,需求曲線跟 Claude Code 完全是兩件事。
- 訓練週期之間的閒置:模型訓練不是 24/7 都在跑,training job 結束後,這些 GPU 會有大量閒置時間。
所以 Musk 手上其實有一批貴到爆但利用率沒打滿的 GPU。
H100、H200、GB200 的折舊速度極快,再不變現,每個月燒掉的現金流是天文數字。
把整個 Colossus 1「整批」租給 Anthropic 一個月,就是最快的變現方式。
合起來看:這是 AI 戰國時代的合縱連橫
Musk 的算盤其實很清楚:
- 短期:拿 Anthropic 的錢,補 GPU 折舊
- 中期:用算力綁住一個能對抗 OpenAI 的盟友
- 長期:為「軌道 AI 算力」這種更大盤的合作鋪路(SpaceX 的核心競爭力是發射,不是 GPU)
對 Anthropic 來說也是雙贏:拿到立刻可用的容量、不用等 Amazon 或 Google 慢慢蓋機房、又能順便讓 Musk 跟 OpenAI 的結構性對立再加深一層。
所以這不是單純的算力買賣,是 AI 戰國時代的合縱連橫。
把 Colossus 1 拆開看:300MW、22 萬顆 GPU 到底是什麼規格
回頭看一下這次合作的硬體規格(資料來源:iThome、Anthropic 公告):
| 項目 | 數據 |
|---|---|
| 新增容量 | 300MW(1 個月內取得) |
| GPU 數量 | 超過 22 萬顆 Nvidia GPU |
| 硬體型號 | H100、H200、新一代 GB200 |
| Claude Code 5 小時上限 | 直接加倍 |
| Pro/Max 尖峰降額 | 取消 |
| Claude Opus API 速率 | 大幅提高 |
300MW 是什麼概念?大約等同於一座中型核電廠機組的輸出,或者一個 30 萬人小城市的尖峰用電量。
GB200 是 Nvidia 2024 底剛量產的 Blackwell 架構,單卡比 H100 快 2.5 倍,是目前訓練前沿模型的主力規格。22 萬顆裡有相當比例是 GB200,意味著 Anthropic 不只拿到「更多」算力,是拿到「更新世代」的算力。
這也回答了一個關鍵問題:為什麼是 1 個月內就能上線。
因為 Colossus 1 是 xAI 早就蓋好、原本要訓練 Grok 用的成熟資料中心。Anthropic 要的不是「再蓋一座」,是「直接接管現成的整座」。對比 Amazon 5GW 要等到 2026 年底、Google 5GW 要等 2027 年才陸續上線,這筆 300MW 是唯一一筆「立即可用」的容量。
為什麼 Claude Code 特別吃算力?
Anthropic 在公告裡有一句話特別值得注意:
「Claude Code 會長時間處理多步驟開發任務,因此特別消耗 Token 與算力,也成為 Claude 容量壓力的主要來源之一。」
這是 Anthropic 第一次官方承認:Claude Code 是吃算力的大戶,而且是壓力來源主要之一。
為什麼?因為 Claude Code 不是傳統的 chat。它是一個 agent:
- 一個任務會丟出長 context(整個 codebase、PRD、log)
- 會做多輪 tool use(grep、read、edit、bash 來回幾十次)
- 中間會反覆讀寫檔案(每次都吃 token)
- 跑完還要驗證、debug、再跑一輪
我自己用 Claude Code 寫文章、寫程式、做 Linux ops,一個半小時的 session 燒掉幾百萬 token 是常態。
Agent 不是聊天機器人,agent 是算力黑洞。
真正驚人的不是 22 萬顆 GPU,是 Anthropic 的算力組合拳
如果你只看「SpaceX 22 萬顆 GPU」這個數字,會以為這是一次性事件。
但把 Anthropic 近期的算力協議攤開來看,會發現他們其實在打一場散兵游勇式的算力總動員戰:
| 合作對象 | 規模 | 啟用時間 |
|---|---|---|
| SpaceX | 300MW / 22 萬顆 GPU | 1 個月內 |
| Amazon | 最高 5GW | 近 1GW 在 2026 年底前上線 |
| Google + Broadcom | 5GW | 2027 年起 |
| Microsoft + Nvidia | 300 億美元 Azure 容量 | — |
| Fluidstack | 500 億美元美國 AI 基礎設施 | — |
加起來是多 GW 等級的算力布局。
更有意思的是 Anthropic 還順手丟了一句話:
「Anthropic 也表達了與 SpaceX 合作開發多 GW 等級軌道 AI 算力的興趣。」
軌道 AI 算力。也就是把 GPU 送到太空。
我看到這句的時候笑了。但仔細想想,散熱用太空真空、電力用太陽能,其實在物理上是合理的解法。只是這代表 Anthropic 已經開始認真考慮地球上的電網跟水冷不夠用了。
(補一個 caveat:太空算力目前只是「expressed interest」,還沒簽合約。但連這個都被官方寫進公告,本身就是一個訊號。)
再等等,Google 為什麼要投 Anthropic 400 億?
講完 Musk 那筆,順便把 Google 的算盤也攤開,因為這個故事更精彩。
2026/04/24,Google 宣布投資 Anthropic 最高 400 億美元。
但魔鬼在金流的方向。
| 流向 | 金額 | 說明 |
|---|---|---|
| Google → Anthropic | $400 億 | $100 億立即入股 + $300 億里程碑撥付 |
| Anthropic → Google | $2,000 億 | 5 年內購買 Google Cloud + TPU 算力的承諾 |
Google 投 1 塊,收回 5 塊,還順便拿到 Anthropic 股權。
這在華爾街已經被吵翻天,叫「循環投資」(circular investment) — 投資人把錢丟給新創,新創再把錢拿回來買投資人的服務,等於左手換右手把營收做大。
但這個「循環」對 Google 來說,是教科書級的兩面下注。
Google 為什麼要投競爭對手?
Google 自己有 Gemini。Gemini 跟 Claude 是直接競爭的關係。
Google 投 Anthropic 看起來矛盾,但算盤其實精得不得了:
- Anthropic 贏 → Google 拿股權回報(入股估值 $3,800 億,隱含估值逼近 $1 兆)
- Gemini 贏 → Google 自己賺
- 誰都沒贏 → Anthropic 是 TPU 的壓艙石客戶,幫 Google 消化 1,850 億美元資本支出的產能
媒體用一句話總結 Google 的邏輯:「輸不起就買進來。」
TPU 從「賭 Gemini 起飛」變成「合約鎖定 Anthropic」
這才是這筆交易最深的一層。
Google 過去蓋了一堆 TPU,最大焦慮就是「自家 Gemini 用量撐不起這麼大規模」。TPU 不像 Nvidia GPU 有現成生態,賣不出去就只能自己用、養蚊子。
投了 Anthropic 之後,Anthropic 簽了 5 年 5GW 的 TPU 合約。
意思是:未來 5 年,TPU 的產能不用再賭 Gemini 起不起飛,因為合約綁死了,Anthropic 必須用。
對 Google 來說,這等於把「賭一個產品」轉成「鎖一個客戶」。風險直接降一階。
Anthropic 拿到的不只是錢,是陣營化
Anthropic 也不是被 Google 吃豆腐。把整個算力陣營攤開看:
| 合作對象 | 投資金額 | 算力綁定 |
|---|---|---|
| Amazon | $250 億 | $1,000 億 Trainium 10 年合約 |
| $400 億 | $2,000 億 TPU 5 年合約 | |
| Microsoft | — | $300 億 Azure 容量 |
| Nvidia / Fluidstack | — | $500 億美國 AI 基建 |
| SpaceX | — | Colossus 1 整批租用 + 軌道意向 |
Anthropic 把所有「原本會自己做模型」的雲端對手,全部綁成股東兼供應商。
OpenAI 還在等自家「星際之門」($5,000 億) 慢慢落地,Anthropic 已經把矽谷四大雲跟 Musk 都變盟友了。
媒體因此把這個格局重新定義為:從「三強爭霸」變成「Anthropic 陣營 vs OpenAI」。
對開發者來說,這意味著一件很實際的事:Claude Code 的算力供給,是被四大雲 + SpaceX 共同擔保的。短期內你不用擔心斷貨。
不只是 GPU:Anthropic 的硬體多元化策略
這次公告裡還有一個容易被忽略的細節:
「Claude 會同時使用 AWS Trainium、Google TPU 與 Nvidia GPU 等 AI 硬體。」
這跟其他 AI 公司很不一樣。
OpenAI 重度押 Nvidia,Google 自己用 TPU 為主,xAI 主要用 Nvidia。Anthropic 是少數真的把三條路都踩的:
- Trainium:拿 Amazon 的便宜
- TPU:拿 Google 的高效率
- Nvidia GPU:拿生態相容性
對工程團隊來說,這代表 Claude 模型必須在三套不同硬體上都能跑。這是個很硬的工程挑戰,但也是個很硬的護城河 — 不會被任一家硬體商綁架。
對我們這些下游使用者來說,意義是:Anthropic 在算力供給上的彈性比同業高,斷貨風險比較小。
對 AI Coding 開發者的三個實際影響
1. Claude Code 重度使用的成本壓力會緩解
5 小時上限加倍 + 取消尖峰降額,對於每天用 Claude Code 6-8 小時的開發者來說,意味著工作流不再被頻繁打斷。
對企業的 ATPM 流程來說,這代表 PRD 迭代、code review、QA 驗證可以連續進行,不用因為「額度燒完」中斷思路。
2. Claude Opus API 的速率提高,對 agent 應用是利多
很多人在做 multi-agent system、agent handover 這類應用時,會撞到 Opus 的 rate limit。
API 速率大幅提高,意味著我們可以做更密集的 agent 編排,而不用一直在 retry/exponential backoff 裡打滾。
這對 agent 落地 是非常有感的。
3. 算力競爭已從「誰有 GPU」進化到「誰能組合多元算力」
過去兩年,大家比的是「能不能搶到 H100」。
現在比的是:「誰能同時調度 AWS Trainium + Google TPU + Nvidia GPU + SpaceX 機房,還能讓模型在這些異質硬體上都跑得好」。
這是另一個維度的競爭。
坦白說:22 萬顆 GPU 真的夠嗎?
我必須老實說,這次的容量擴充未必能撐很久。
理由是:
-
Claude Code 的需求成長太快:根據 Anthropic 自己的說法,Claude Code 已經是「容量壓力的主要來源之一」。300MW 對應到全球 Pro + Max + Enterprise 用戶,平攤下來其實不算誇張。
-
agent 的 token 消耗還在膨脹:當大家開始用 sub-agent、multi-step planning、self-correction,每個任務的 token 使用量還會繼續往上走。
-
新用戶持續湧入:Claude Code 還在快速成長期。容量加倍,但用戶可能也加倍。
所以這個「上限加倍」的甜蜜期,可能撐 3-6 個月就會再次面臨壓力。
但這也說明了為什麼 Anthropic 同時在簽 5GW + 5GW + 30 億 + 500 億的協議 — 他們很清楚這是一場長期戰,22 萬顆 GPU 只是先擋一陣。
最後一句話
如果你是 Claude Code 重度用戶,這幾週的體驗會明顯變好。
但如果你以為算力問題已經解決了,那就太天真了。
真正的訊號是:Anthropic 正在用「散兵游勇式」的算力組合拳,去撐起 Claude Code 這個 agent 工具的需求成長。
這場戰爭剛開始打。下一個十年,AI Coding 工具的競爭力,不只看模型多強,還看算力供給有多穩、多便宜、多有彈性。
22 萬顆 GPU 不是終點,是一個逗號。
延伸閱讀
降智系列(這次合作要解決的問題)
- Opus 4.6 偷偷縮水、Max Plan 燒光速度翻倍:為什麼 Open Source Agent 架構是企業唯一可行方案
- LLM 亂降智不是都市傳說:有人開始用數據追蹤了,企業 IT 該怎麼辦?