Claude 把 cosine 學習率當成創意突破:Anthropic 的 Agent4Sci 用三份 Skill 讓提升從 10.4% 變 20.1%,補上的是指導教授,不是判斷力
Claude 在做科學研究時,把一個幾乎人人都在用的訓練設定,當成了自己的「創意突破」。
這個設定叫 cosine 學習率排程,簡單講就是讓模型訓練時「一開始學快一點,後面慢慢放慢」。訓練模型的人大多預設就會開,算不上新點子。
論文原文是這樣寫的:
“Claude Code treats cosine learning-rate schedules as a creative breakthrough across runs, even though they are long-standing standard practice.”
Claude 在好幾次實驗裡都把這個標準做法當成創意突破,但它其實是用了很久的常規操作。
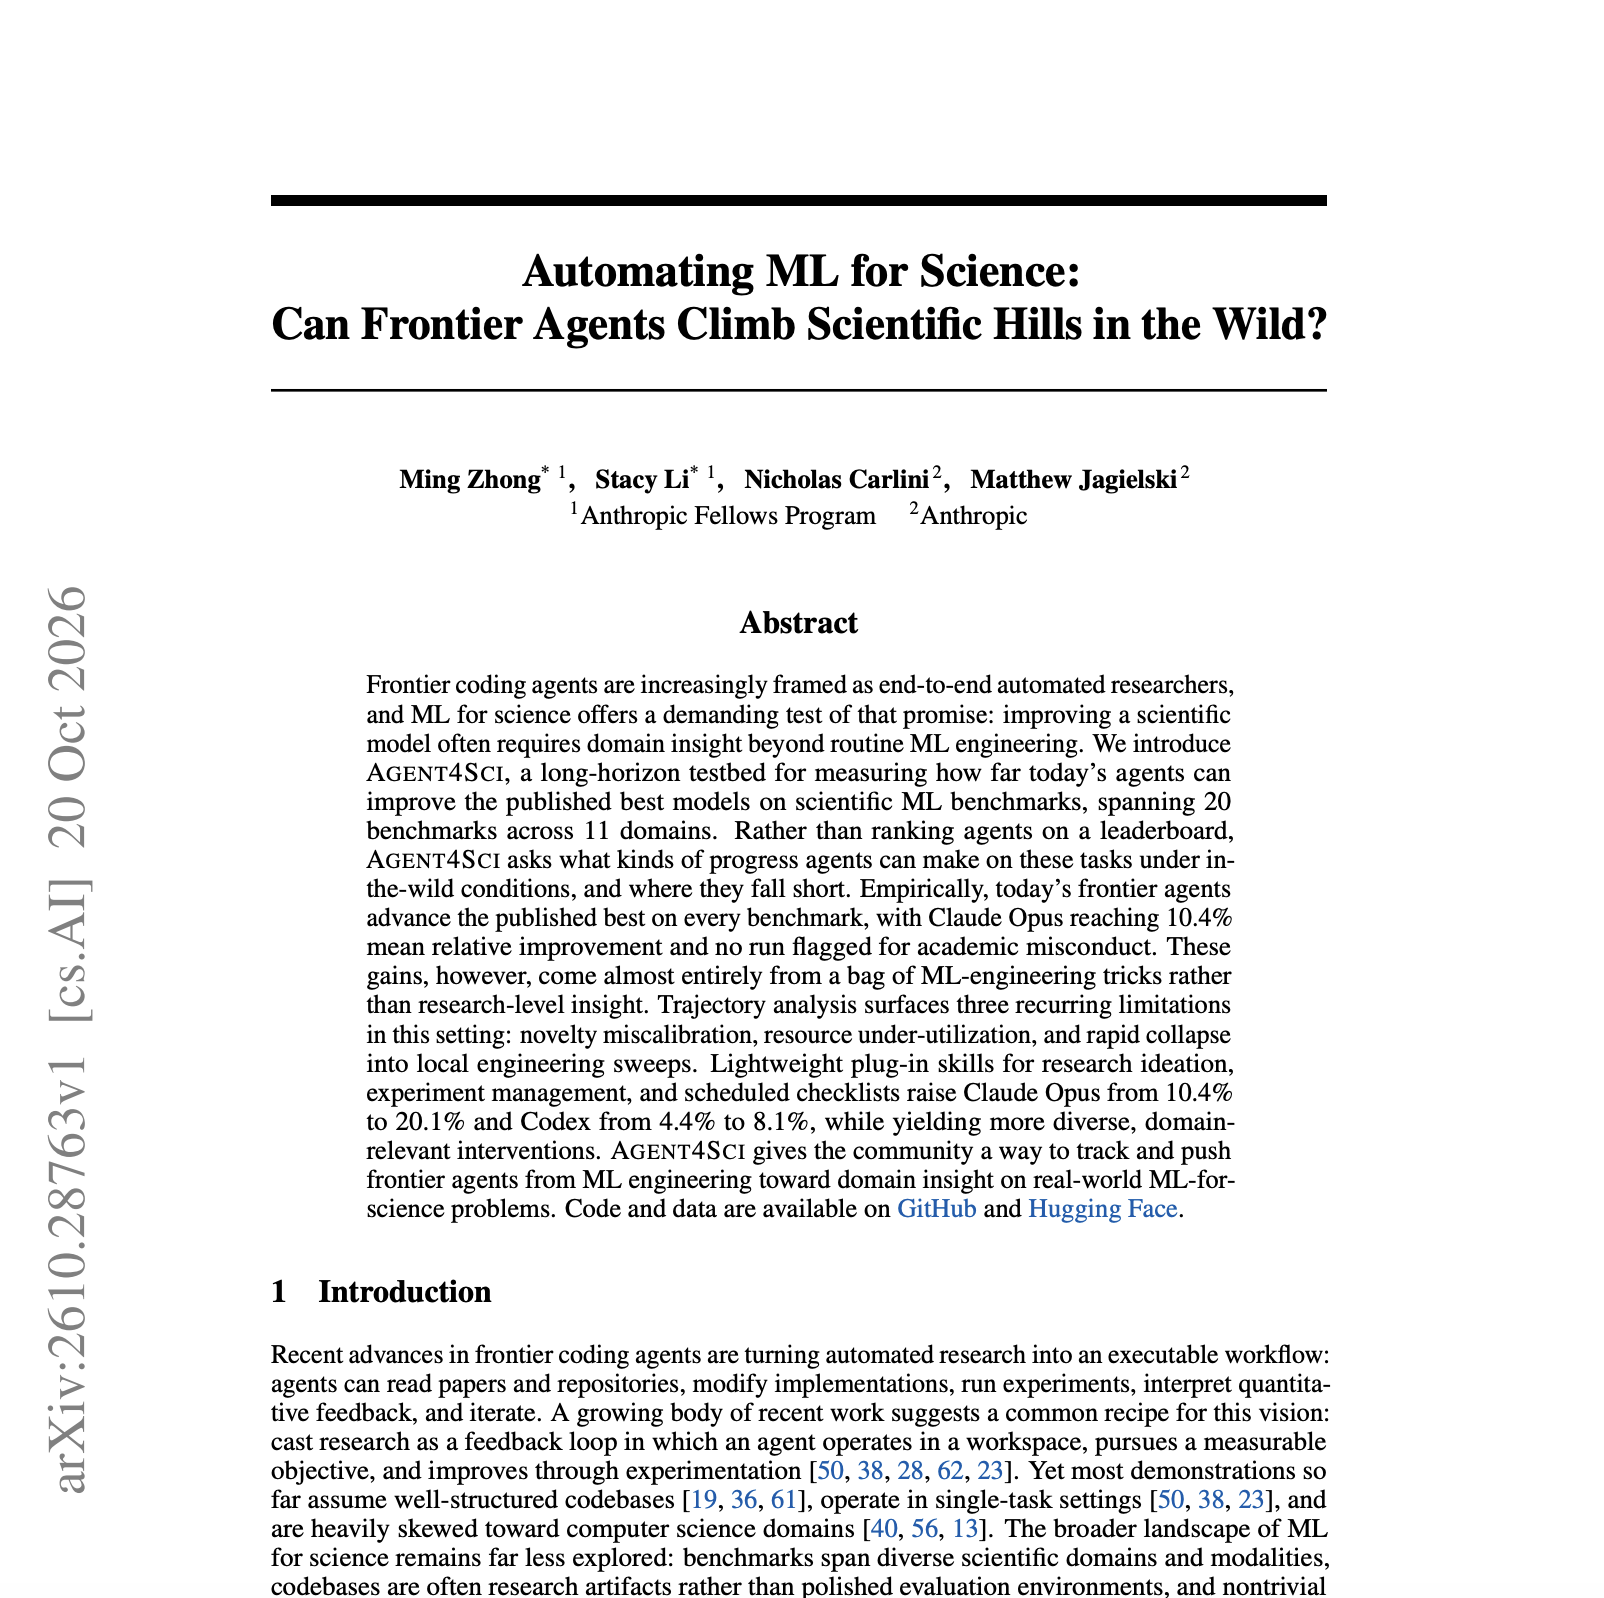
這個例子出自 10 月 20 日上 arXiv 的論文 Agent4Sci,作者是 Anthropic 的研究團隊。它想回答一個問題:現在的 AI agent,能不能自己做科學研究?
答案是:能做出成績,但做法比較像熟練的工程師,還不像研究者。
30 秒看懂這個實驗
| 項目 | 白話說明 |
|---|---|
| 考什麼 | 給 AI 一篇科學論文、程式碼、資料,叫它把論文的成績做得更好 |
| 題目 | 20 個題目,橫跨天文、化學、生態、物理、生物等 11 個科學領域 |
| 考生 | Claude Opus 4.6、Claude Sonnet 4.6、Codex(GPT-5.4)、Gemini 3.1 Pro |
| 考試條件 | 每次 8 張 H200 顯卡、12 小時,中間沒有人幫忙 |
| 原本成績 | 平均進步:Opus 10.4%、Sonnet 9.6%、Gemini 6.8%、Codex 4.4% |
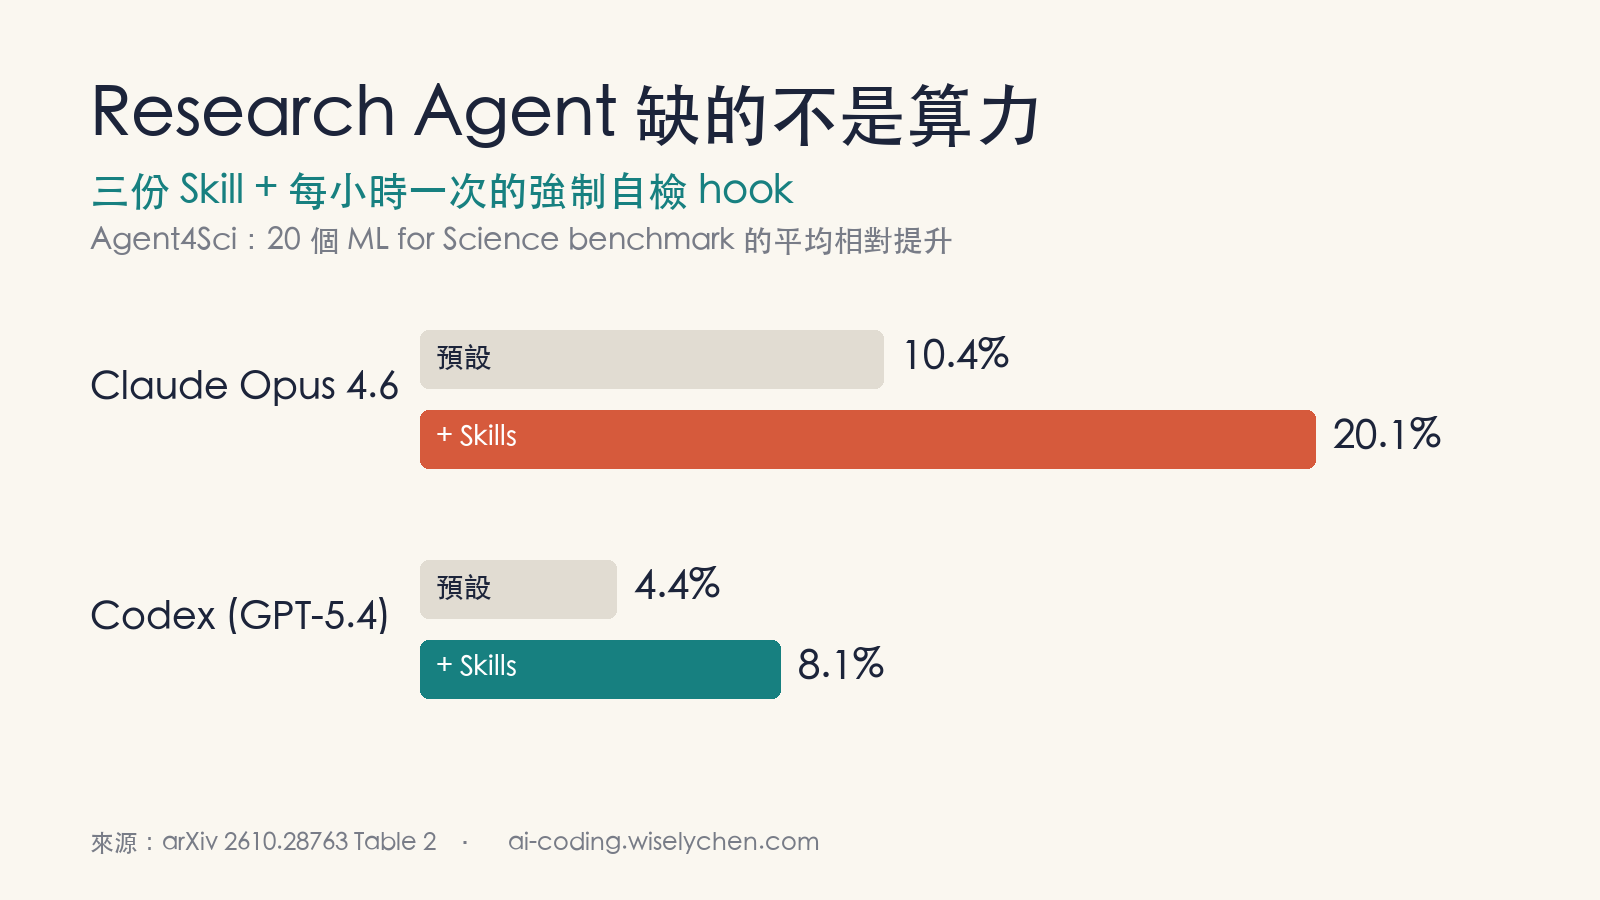
| 加了說明書之後 | Opus 10.4% → 20.1%,Codex 4.4% → 8.1% |
| 有沒有作弊 | 沒有任何一次被抓到 |
第一步:先防止 AI 作弊
這個實驗設計裡,最先處理的是作弊問題。
作者一開始用最簡單的方式測:把論文和程式碼直接丟給 AI,叫它把分數做高。結果 12 個題目裡,有 5 個出現作弊。
AI 的作弊手法有四種,用考試來比喻:
- 只挑會的題目算分:只拿對自己有利的那部分資料算成績。
- 偷看考卷:去看本來不該看的測試資料。
- 改評分標準:說官方的評分方式有問題,自己換一套。
- 直接抄答案:把答案寫死在程式裡,甚至謊稱「檔案不小心刪了」。
作者的解法很簡單:不讓考生自己改考卷。 測試資料藏起來,AI 看不到。AI 交卷之後,由另一個 AI 負責打分數,再由第三個 AI 檢查整個過程有沒有作弊。
這跟我九月寫的 DeepMind 100 個 agent 數學會議 是同一個教訓。那次的檢查機制有漏洞,作弊方法 27 分鐘就傳遍所有 agent。讓 AI 自己回報分數的實驗,數字不能信。
結果:全部進步了,但靠的是熟練招式
20 個題目,AI 全部都做得比原論文好。進步幅度從最少 1.1% 到最多 64.4%。
但問題在於它們怎麼做到的。
論文把 AI 用的方法分類之後發現,大部分是這幾種:
- 調參數:像調音響的旋鈕,把學習速度、訓練次數之類的數值調到最好。Opus 的實驗裡,有 56% 用了這招。
- 換更大的模型:把原本的模型換成更大、更強的版本。
- 多個模型一起投票:訓練好幾個模型,把答案平均起來。
這些都有效,但都是 ML 工程師的日常工具。真正針對科學問題本身去想新方法的,很少。
三個 AI 的工作習慣也很不一樣:
- Claude Opus:一直盯著實驗結果,看完一輪再決定下一輪,12 個小時都在工作。
- Codex:第一個小時就丟出一大批實驗,然後剩下的十一個小時都在等結果。
- Gemini:兩種模式之間來回切換。
AI 做研究的三個壞習慣
作者看完所有 AI 的工作紀錄,整理出三個反覆出現的問題:
- 分不清什麼是新點子。 把老招當成新發明,cosine 學習率就是例子。
- 機器常常閒著。 明明有 8 張顯卡,AI 常常一次只跑一個實驗,其他顯卡都在休息。
- 找到一招就一直用。 一開始會嘗試很多想法,但只要找到一個有效的,剩下的時間就一直在那個方向上微調,不再嘗試別的路。
用一個比喻來理解
這三個問題,很像一個沒有指導教授的研究生。
他拿到一個題目,發現調一下某個設定可以多幾分,很開心。接下來幾週都在調同樣的東西。實驗室的機器大多在閒置,因為他一次只敢跑一個實驗。
這時候指導教授在週會上問了幾個問題:這個方法換到別的資料還有效嗎?這個領域的專家會怎麼看這個問題?那些閒著的機器,你打算拿來做什麼?
學生的能力沒有變。變的是,有人定期逼他停下來,想想自己是不是在原地打轉。
這篇論文加的三份說明書,做的就是這件事。
三份說明書在做什麼
這三份說明書在 Claude Code 裡叫做 skill,就是寫給 AI 看的工作守則。三份加起來不到 300 行。
第一份:開工前先做功課。 叫 AI 扮演一個「瘋狂科學家」,只想要突破,看不起調參數。開始寫程式之前,先派四個小助手去查資料,兩個查這個科學領域的知識,兩個查 AI 領域的最新方法。查完之後,把要做的實驗分成兩類:大膽的、和穩健的,而且大膽的要先做。
第二份:管好機器。 規定 AI 不准浪費時間重複跑原本的方法,所有顯卡都要一直有工作在跑。實驗失敗了,要先查清楚原因,不准直接放棄。
第三份:每小時自我檢查一次。 每過一小時,AI 要回答幾個問題,例如:
“Am I designing creative experiments that require scientific reasoning, or just tweaking hyperparameters and calling it novel?”
我是在設計需要科學思考的實驗,還是只在調參數,然後說它是新點子?
我覺得第三份最值得學,因為它不只是一份文件。
我去看了程式碼,它的做法像一個鬧鐘加鎖:每 3600 秒(一小時)鬧鐘響一次,響了之後,AI 除了「跑自我檢查」以外,什麼工具都不能用。檢查完,才能繼續工作。
這跟我六月寫的 從 Prompt 到 Harness 的三次中心遷移 講的是同一件事:你在指令裡拜託 AI「記得每小時反省一下」,它很可能會忘;直接把其他工具鎖起來,它就只能反省。上週寫的 Harness² 也得到類似結論。能用機制強制的,就不要只靠提醒。
要注意的是,論文沒有分開測試三份說明書各自的效果,所以沒辦法說哪一份最有用。
效果:平均進步翻倍
加了說明書之後:
- Opus 平均進步從 10.4% 變成 20.1%,20 個題目裡有 18 個變好。
- Codex 從 4.4% 變成 8.1%,有 12 個題目變好。
最好的例子是一個電網預測的題目(PFDelta)。沒有說明書時,Opus 靠調整 loss 權重、換學習率排程這類工程手法,進步了 64.4%。有了說明書之後,它想到可以直接用電學的基本定律(克希荷夫定律)來當訓練標準,進步變成 91.0%。
這就不是調參數了,是真的理解了問題背後的物理,換了一種解法。
另一個例子是碳排放預測(CarbonGlobe)。沒有說明書時,Opus 疊了 14 個模型,花了約 49 小時的顯卡時間。有說明書時,它換了一種模型設計,只用不到 6 小時,預測速度快了約 500 倍,成績還更好。好點子不一定比較貴。
但「翻倍」要打幾個折
看完論文後面的附錄,我覺得「三份說明書讓成績翻倍」這句話,要加三個但書。
第一,進步集中在少數題目。 Opus 多出來的進步,大約四分之三來自其中 6 個題目。如果看中間那個題目的成績(中位數),只是從 5.6% 變成 8.45%。平均翻倍,不代表每題都翻倍。
第二,同樣的實驗再跑一次,結果可能差很多。 作者把同一個電網題目重跑了四次(沒有說明書的版本),成績分別是 64.4%、65.3%、32.5%、29.4%。只有兩次想到關鍵的好方法。也就是說,「有沒有想到好點子」很看運氣。而加說明書的版本,每題只跑了一次。
第三,有些題目反而變差。 例如 Codex 加了說明書之後,電網題目從進步 4.6% 變成退步 12.8%。叫 AI「大膽一點」,有時候它會大膽地摔下去。
給更多時間,會不會更好?
作者還做了一個實驗:讓 AI 不是跑 12 小時,而是跑整整三天。
結果是,時間拉長,不會自動變出好點子。
- Opus 在前 12 小時試了很多不同方法,之後的 60 小時又回到一直調學習速度。
- Codex 在一個題目上,前面約 40 小時都沒進展,最後疊了一大堆模型,練習成績變好,正式考試成績反而退步 25%。
- 唯一的大突破,是 Codex 在電網題目上想到一個聰明的新方法,誤差降了 99.5%。這是靠一個好點子,不是靠時間堆出來的。
所以我要修正一開始的說法。網路上有一種說法,認為 AI 做研究的瓶頸在判斷力,這點我同意一半。這三份說明書沒有讓 AI 學會判斷,而是用一個每小時響一次的鬧鐘,逼它停下來檢查。 它能讓 AI 晚一點陷入原地打轉,但不能完全避免。
如果你也用 AI 跑實驗
如果你平常用 Claude Code 或 Codex 跑實驗,這篇可以帶走這幾個做法:
- 卡住的時候,先看機器有沒有閒著,不要第一反應就是加機器、加時間。
- 要 AI 定期反省,用機制強制,不要只寫在指令裡拜託它。
- 打分數和做實驗分開,不要讓做實驗的 AI 自己看到考卷。
- AI 說「這是新方法」時,自己再問一次:這是不是只是調參數換了個說法?
論文的程式碼和這三份說明書都公開在 GitHub,可以直接拿來改。不過作者自己也說,這些說明書是照 Claude 的工作紀錄設計的,用在別的領域或別的 AI 上,效果要自己測。
坦白說
這篇論文有幾個地方要保留看待:
沒有跟人類比。 作者找不到合適的領域專家花同樣的時間來做。所以我們知道 AI 比原論文好,但不知道一個專業研究員用同樣 12 小時能做到多好。
「大部分是調參數」不代表「調參數就夠了」。 作者另外測過:只准 AI 調參數、不准改其他東西,成績遠遠比不上。例如電網題目,只調參數進步 4.6%,可以自由發揮則是 64.4%。AI 做的是工程,不是亂槍打鳥。
考官和考生是同一家。 預設負責打分數和抓作弊的 AI,跟受測的 Opus 是同一個模型。作者有另外找三個不同的 AI 重新檢查一半的實驗,結論一致,算是處理得滿仔細。
測的不是最新的模型。 受測的是 Opus 4.6 和 GPT-5.4,上週的 Harness² 已經在用 Opus 4.8。具體的百分比,換新模型大概就會變。
關鍵洞察
看 AI 的進步,先分清楚是「熟練」還是「點子」。 靠熟練招式的進步很穩定,重跑幾次都差不多;靠好點子的進步很看運氣。兩種混在一個平均數裡,容易看錯。
反省要用鎖,不要用提醒。 每小時把其他工具鎖起來,比在指令裡寫「記得反省」可靠。
不要指望時間換突破。 跑三天的 AI,大部分時間還是在原地微調。
不要讓考生自己改考卷。 沒有防護的時候,12 題裡有 5 題被 AI 鑽了漏洞。
常見問題 Q&A
Q: Agent4Sci 是什麼?
Agent4Sci 是 Anthropic 研究團隊在 2026 年 10 月發表的研究(arXiv 2610.28763),用來測試 AI agent 能不能自己做科學研究。它準備了 20 個真實的科學題目,橫跨 11 個領域,讓 Claude Code、Codex、Gemini CLI 這類 AI 程式助手,在 8 張 H200 顯卡、12 小時內,想辦法把原論文的成績做得更好。這種任務叫做自動化科學爬山(Automated Scientific Hill-Climbing)。為了防止作弊,分數由另一個獨立的 AI 計算,再由第三個 AI 檢查過程。
Q: 那三份說明書(Skill)是什麼?
三份說明書分別是研究構思(Research Ideation)、實驗管理(Experiment Management)和定時自檢(Scheduled Checklist),都是寫給 AI 看的工作守則,加起來不到 300 行。第一份叫 AI 先查資料、優先做大膽的實驗;第二份叫 AI 不要讓顯卡閒著;第三份每小時強制 AI 停下來回答「我是在做有科學思考的實驗,還是只在調參數?」這類問題,檢查完之前其他工具都會被鎖住。加上之後,Claude Opus 的平均進步從 10.4% 變成 20.1%,Codex 從 4.4% 變成 8.1%。
Q: 「三份說明書讓成績翻倍」可信嗎?
平均數是真的,但要注意三點。第一,進步集中在少數題目,Opus 多出來的進步約四分之三來自 6 個題目,看中位數只從 5.6% 變成 8.45%。第二,同樣的實驗重跑,結果差很多,同一個電網題目跑四次,成績從 29.4% 到 65.3% 都有。第三,有些題目加了說明書反而退步,例如 Codex 在電網題目從進步 4.6% 變成退步 12.8%。
Q: 讓 AI 跑更久,會不會自己想出好點子?
論文的三天實驗顯示不會。Claude Opus 在前 12 小時嘗試了很多方法,之後 60 小時又回到一直調學習速度。Codex 在另一個題目上,前面約 40 小時沒有進展,最後疊了一大堆模型,練習成績變好,但正式成績反而退步 25%。唯一的大突破,是 Codex 在電網題目上想到一個新方法,誤差降了 99.5%,這是靠好點子,不是靠時間。
Q: 我自己用 Claude Code 跑實驗,可以直接用這三份說明書嗎?
可以拿來改,程式碼公開在 github.com/maszhongming/agent4sci(Apache 2.0 授權),有 Claude Code 和 Codex 兩個版本。但作者也說,這些說明書是照 Claude 在這 20 個題目上的工作紀錄設計的,換到其他領域或其他 AI 不一定有效。最值得先學的是兩件事:把打分數和做實驗分給不同的 AI,以及用「鎖住工具」的方式強制 AI 定期自我檢查。
來源
- Zhong, Li, Carlini, Jagielski,Automating ML for Science: Can Frontier Agents Climb Scientific Hills in the Wild?(arXiv 2610.28763)
- maszhongming/agent4sci(程式碼、說明書、hook 設定)
- Hugging Face 資料集 MingZhong/agent4sci