LFM3 的 2B 路線:企業地端小模型何時值得搬
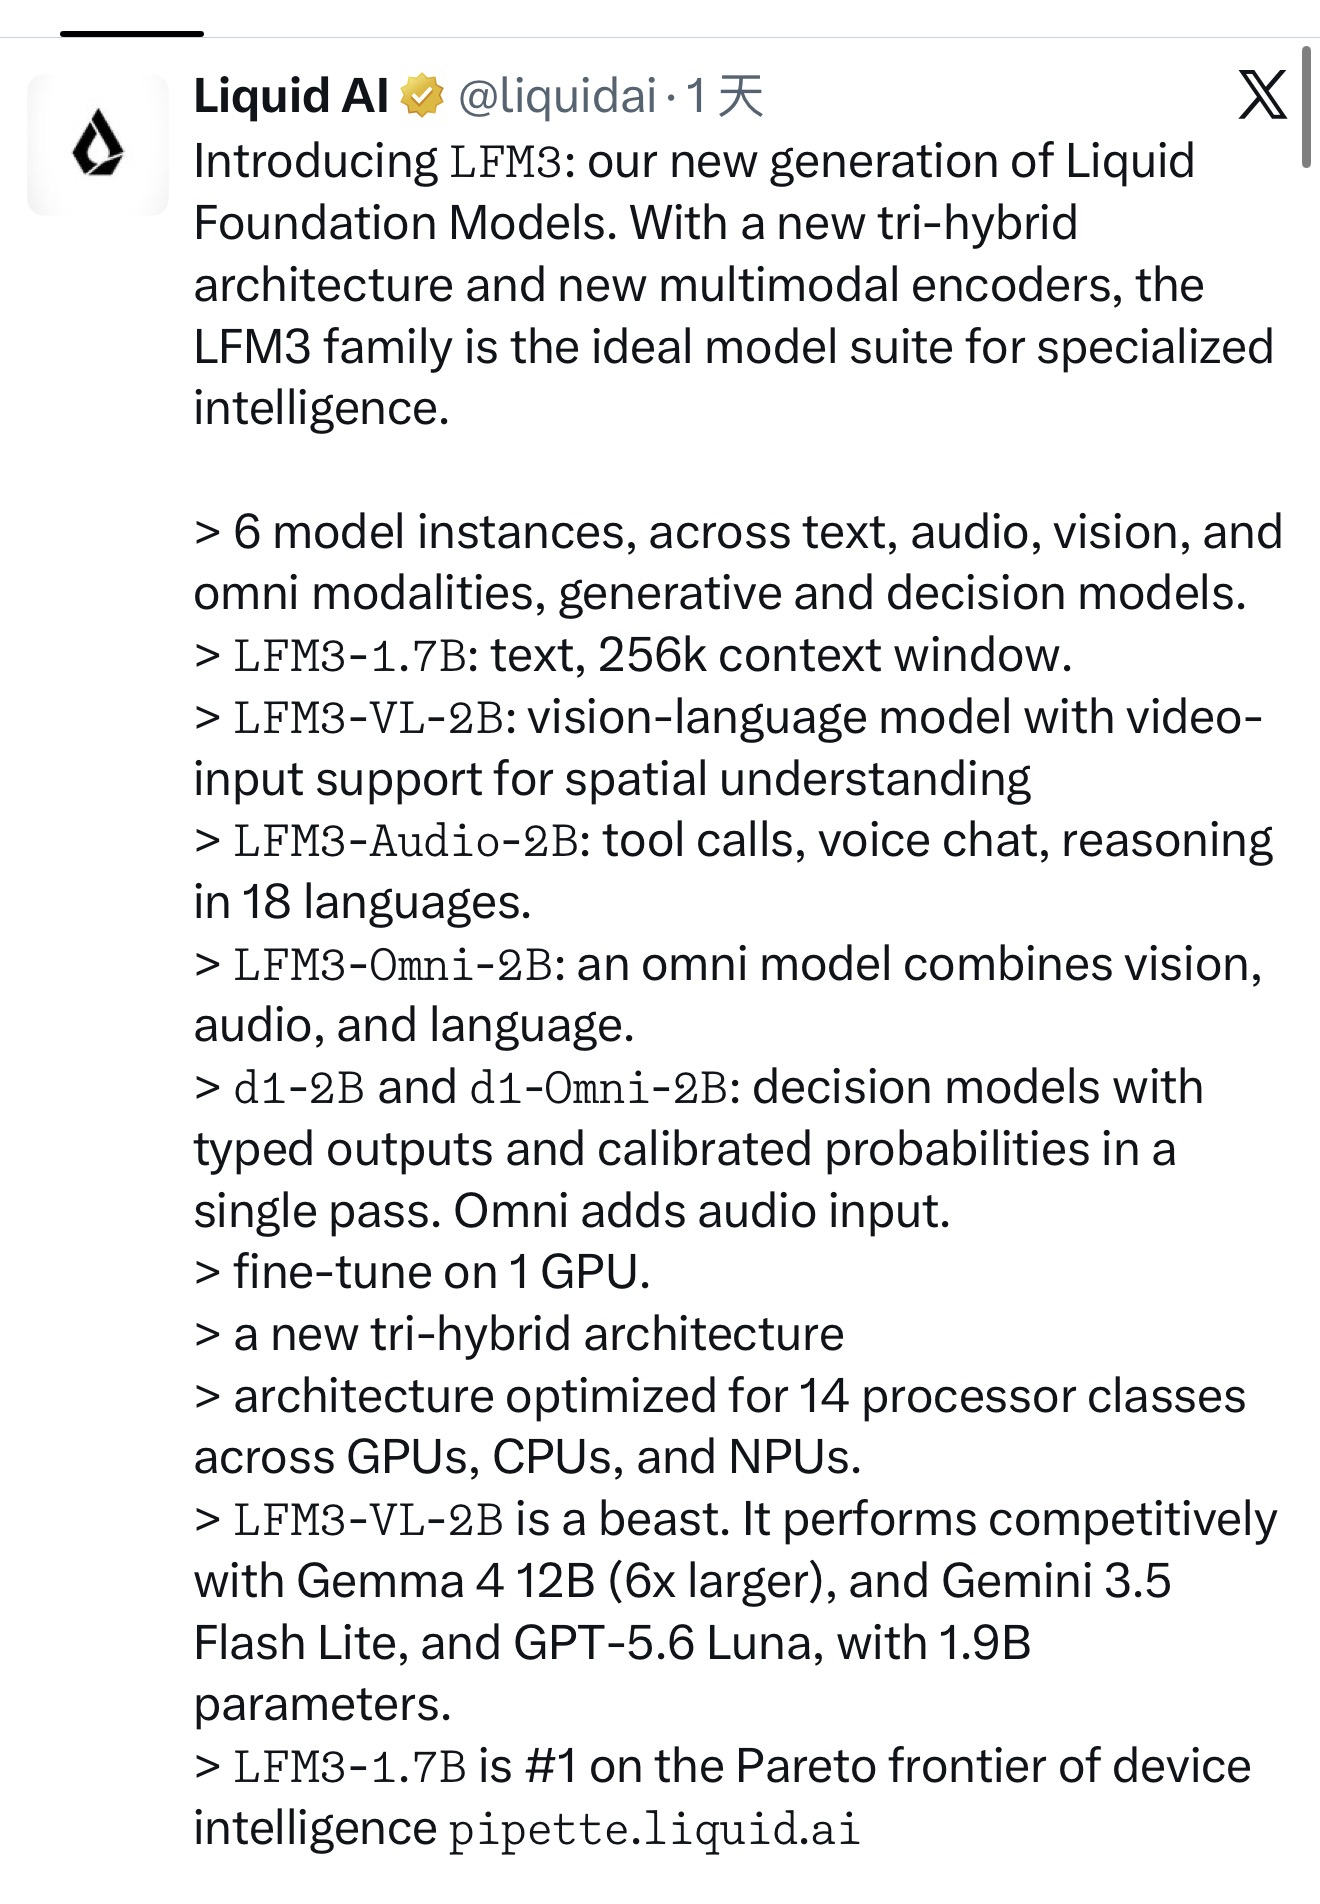
Liquid AI 這次的整條產品線,沒有一顆放在資料中心當明星的通用旗艦模型:六個模型全部壓在 2B 參數級,文字模型 4-bit 之後約 1 GB。
對多數企業,這個大小不值得期待。但對想讓 AI 少碰雲端 API 的企業,它可能是少有的選擇:把 AI 拉回自己的機器上,從租 token 變成養一個小專家。
這篇要回答的不是「LFM3 強不強」,而是企業為什麼該在意 2B 以下、能跑在裝置上的專用模型,什麼場景用、什麼場景別用。
前提先講清楚:我在 2026 年 10 月 29 日於 RTX 5090 32 GB 上,以 BF16 實測了 d1-2B、LFM3-VL-2B、LFM3-Audio-2B、d1-Omni-2B 四個模型(結果見下方專節)。LFM3-1.7B 與 LFM3-Omni-2B 本輪沒有測。官方宣稱、模型卡規格、我的實測、外部資料與我的推論,全部分開寫。
先說結論
- LFM3 的賣點不是「又一個小模型」,而是一組可以各自微調的小模型:六個模型共用同一個底座,官方說每一個都能在單張 GPU 上微調。
- 最值得台灣企業看的是 d1-2B、d1-Omni-2B 這類決策模型。它們不寫文章,只回傳分類、抽取結果與校準過的機率,適合接進既有的表單、審核、通報流程。
- 實測顯示:決策分類中英都穩,差距出現在中文語音問答——訂單號 7391 被聽成 731,接上思考模式也沒修正。數字類欄位要靠人工覆核或欄位核對。
- 但限制也很硬:授權有營收門檻、寫程式是短板、量化之後的表現還沒有人公開驗,繁中也沒有分數。
LFM3 是什麼
Liquid AI 的 blog 這樣描述:新的 tri-hybrid 架構、22T token 的預訓練,最後 3.5T token 是針對 agent 資料的中途訓練,把 context 拉到 256K。
架構上,24 層裡有 13 層捲積、5 層滑動視窗注意力(視窗 256 token)、6 層全域注意力;捲積核從 LFM2 的 3 放大到 7。設計目的很明確:長 context 不要變慢。官方宣稱,同樣參數量下,裝置端短 prompt 與 LFM2-1.2B 打平,到了 8K token context 快約 25%。
架構搜尋是在 14 種 device 與 backend 組合上做的:Samsung Galaxy S26 Ultra、OnePlus 15、Raspberry Pi 5、Apple M4 Max 與 Ryzen AI 筆電、Arm 與 x86 雲端 CPU,再加 GPU 和 Qualcomm Hexagon NPU。這份清單比任何榜單都更能說明 Liquid AI 想做什麼:不是要跟 GPT 搶聊天視窗,而是要被裝進別人的機器與流程裡。
| 模型 | 這是什麼 | 關鍵規格(官方資料) | 我認為企業該怎麼看 |
|---|---|---|---|
| LFM3-1.7B | 文字模型 | 1.73B;256K context;輸出 16 種語言(含 zh) | 地端助手的「大腦」:讀信、整理會議、呼叫工具 |
| LFM3-VL-2B | 視覺語言模型 | 1.92B=1.73B 語言模型+164M 視覺編碼器+25M 投影器;可輸入影片,取樣 2 fps | 看圖、看畫面、看影片:巡檢、文件判讀、客服截圖 |
| LFM3-Audio-2B | 語音模型 | 32K context;語音涵蓋 18 種語言 | 語音助理、電話品管:要注意 context 較短 |
| LFM3-Omni-2B | 全模態模型 | 2.17B;文字、圖片、影片、音訊都能進,回文字或語音 | 有機會把 ASR、VLM、LLM、TTS 收進同一個模型(還沒驗證) |
| d1-2B | 決策模型 | 1.92B;128K context;單一 forward pass 不回傳生成文字 | 接進現有流程的判斷層:分類、抽取、稽核 |
| d1-Omni-2B | 含語音的決策模型 | 2.17B;可以聽聲音做判斷 | 來電、語音留言、音訊事件的即時分流 |
規格取自官方 blog 與 Hugging Face 模型卡,最後一欄是我的判讀,不是官方建議。
待補圖:LFM3 六個模型與共用底座的分支關係圖(依官方 blog 敘述重繪,不要使用官方宣傳圖)。
企業場景:什麼該搬、什麼別搬
判斷的方法很簡單:看工作是否題目固定、答案可驗、量大、資料敏感。全部符合才搬;只符合一項,先別搬。
值得搬的:
- 客服與工單的分流、標記、急迫程度判斷。d1-2B 的模型卡說它回傳校準過的機率、單一 forward pass,適合直接接 API。
- 發票、表單、合約的欄位抽取。同一張卡寫它可以抽取文字、數字、日期並回傳位置。
- 工廠、門市、工地的固定題目影像巡檢(裂縫、異物、制服、安全帽)。
- 內部助手的輕量任務:讀信、排行事曆、整理會議紀要。
- 語音留言與來電分類:d1-Omni-2B 的定位就是這個。
別搬的:
- 寫程式與大型重構。模型卡自己寫「It is not recommended for agentic coding or complex multi-step reasoning due to its small size.」,官方 blog 也說「Larger models still win on agentic coding and knowledge, where size matters most」。這一類工作,小模型換不掉。
- 需要深度知識的問答。Liquid AI 自己的表格裡,GPQA Diamond 是 63.37,Qwen3.5-9B 是 80.40;除非接上檢索與工具,否則問專業知識很容易答得流暢但出錯。
- 長篇文件與長時間對話。LFM3-1.7B 有 256K context,但知識與推理跟不上;VL 是 128K,Audio 只有 32K,不是同一回事。
- 合規要求指名雲端服務的場景。把資料搬回自己的機器反而是反方向,這是流程問題,不是技術問題。
為什麼值得搬的那幾類會成立,理由分成三個。
一、決策模型:把 AI 接進既有流程,而不是再加一個聊天視窗。 d1-2B 不是聊天模型,模型卡直接寫「It is not a chat model.」。給它一段情境和一串問題,它在同一個 forward pass 裡回一堆答案,每個答案帶校準過的機率,不生成文字。企業要的通常不是會講話的 AI,而是能掛在流程上做判斷的零件。
d1-Omni-2B 多了語音。官方說用語音問同一組問題時,精度幾乎不掉:業務分流那項,書面 83.4、口說 78.2。過去這類工作要串 ASR 與 LLM 兩段,現在可以收進一個 2.17B 的模型。
二、多模態小模型:把推論推進到攝影機與筆電。 LFM3-VL-2B 官方宣稱,在 62 個視覺 benchmark 上領先同尺寸模型至少 7.4 分,打平參數量是它 6 倍的 Gemma 4 12B,贏過 Gemini 3.5 Flash Lite,離 GPT-5.6 Luna 差 2 分。這是 Liquid AI 的宣稱,我還沒驗證,也沒有第三方復現。
官方的微調案例值得看清楚:拿 3,000 張公開的風機葉片照片微調,花數小時、用一張 A100,同一批題目上分類準確率到 67%,偵測 F1 從 0.003 提到 0.11(GPT-6 Luna 是 0.01)。小模型的價值在這裡:它可以在你家固定的題目上被重新訓練。
三、單卡微調:改變的是導入的商業模式。 如果微調要一整組 GPU 才做得動,只有大客戶做得到;如果一張 GPU 加幾小時就夠,中小企業也能談。我在 On-Prem 小模型爆發時代來了 那篇提過三步分流:先用雲端跑通場景;把高頻 workload(分類、抽取、摘要、對話路由,該文估計佔 70-80% Token 消耗)搬到地端小模型;機敏 workload 直接地端。d1-2B 這種決策模型,正好站在第二步。
對照表:LFM3-1.7B 對 Qwen3.5-9B
Liquid AI 的榜單挑了幾個對手,但台灣企業更現實的比較對象,是你現在已經在跑、或正在評估的模型。底下兩欄數字都取自 Liquid AI 的 blog 表格,沒有第三方復現。
| 面向 | LFM3-1.7B | Qwen3.5-9B | 對企業的意思 |
|---|---|---|---|
| 參數量 | 1.73B | 9.7B | 9.7 ÷ 1.73 ≈ 5.6,硬體門檻差一個等級 |
| EnterpriseOps-Gym(企業流程類 agent) | 28.20 | 28.97 | 幾乎打平,流程填單這種工作,小的不一定輸 |
| SWE-bench Verified(寫程式) | 43.40 | 51.20 | 51.20 − 43.40 = 7.8,小模型寫程式確實吃虧 |
| Terminal-Bench 2.1 | 12.92 | 17.98 | 17.98 − 12.92 = 5.06,長命令列任務更吃虧 |
| GPQA Diamond(知識問答) | 63.37 | 80.40 | 80.40 − 63.37 = 17.03,這是最現實的差距 |
| 4-bit 後約幾 GB | 約 1 GB(官方宣稱) | 官方表格沒有列 | 一台舊筆電、一台小盒子裝得下的檔次不同 |
重點不是誰贏,而是分工:LFM3-1.7B 在流程型工作上接近 9B 模型,在知識型與程式型工作上明顯落後。LFM3 的用法是分工,不是取代。
這也接得上我過去的在地實測。在 DGX Spark 測試實錄 裡,單人最快的 DeepSeek 是 62.34 tok/s,8 人同時用時首字中位要 21.76 秒;Qwen 單人最慢(40.22),8 人時反而 146.76、首字 3.64 秒。在 Strata 跑 Qwen3.8-Flash-Next 裡,結論是瓶頸從 VRAM 移到 DRAM:RAM 決定能不能跑,VRAM 決定跑多快。1 GB 的模型把記憶體門檻壓得很低,代價是知識與程式能力。所以問題換成:你要不要一個只要 1 GB、但知識與程式能力明顯落後的模型?
我的實測:RTX 5090 32 GB、BF16
2026 年 10 月 29 日,我在 RTX 5090 32 GB 上用 BF16 跑了四個專用模型,各模型分別執行。測試素材是小量已知答案的圖片、繁中截圖與中英合成語音,不等同正式準確率,也沒有涵蓋真人口音、嘈雜環境或即時串流。
| 面向 | 實測結果 | 速度與限制 |
|---|---|---|
| 文字決策:d1-2B | 12 個中英客服案例,分流與退款判斷皆符合預期。直接輸出分類與機率,無須生成長篇文字 | 暖機後,同一請求完成兩項判斷平均約 11 毫秒;較複雜退款規則題答對 5/6 |
| 視覺理解:LFM3-VL-2B | 正確讀取圖表數值、計算季度差額、辨識形狀與位置;發票編號、公司、總額及日期皆正確,也能閱讀繁中截圖 | 四項任務約 2.5–8.4 秒,包含思考;繁中回答仍有簡體混用與局部語義誤解 |
| 語音處理:LFM3-Audio-2B | 中英轉錄保留主要資訊,能辨識提示音,也能產生中英文語音 | 17.34 秒中文錄音約 0.51 秒完成轉錄;約 1.36 秒產生 6.56 秒中文語音 |
| 聲音決策:d1-Omni-2B | 直接從英文錄音判斷退款並分到帳務,從中文錄音分到配送,不必先串接外部轉錄模型 | 兩份錄音約 26.5/32.4 毫秒;提示音精確計數只答對 2/4,估計區間則均涵蓋真值 |
四個模型在本輪的 PyTorch 峰值記憶體配置約 3.69–4.17 GiB,不含其他服務、CUDA context 與保留記憶體。這組數字說明一件事:約 2B 的專用模型,用一張消費級顯卡就能同時佔住好幾個,地端部署的資源門檻比多數人想的低。
中英文差距:語音問答比分類更明顯
決策分類看不出明顯落差。 中英客服案例都符合預期;純語音轉錄也能保留主要資訊,包括中文訂單號 7391。
語音問答則英文較穩。 英文能正確回答訂單號「7391」與「下午 3 點」;中文把「7391」漏成「731」,開啟思考後仍未修正,直接回答模式還會重抄錄音。同一份中文素材,Whisper 能辨識出正確編號。
中文生成仍需額外驗證。 視覺回答會混用簡體;中文合成語音中的「訂單編號」未被 Whisper 正確還原,英文合成語音回轉錄則符合原文。這是自動交叉驗證結果,還不能當作人工確認的發音或音質結論。
企業應用判讀
優先值得驗證的場景,是客服分流、固定選項決策、圖表與文件閱讀。
中文語音若涉及訂單號、金額、日期與時間,必須加入關鍵欄位核對與人工覆核。7391 變 731 這種錯,系統不會告訴你它沒把握——這正是我在上一節講的「小模型安靜地犯錯」。這個案例比任何 benchmark 都具體。
增加高品質中文資料、針對語音問答與數字辨識微調,可能改善弱點,但本次尚未驗證訓練成效。也不能把差距直接歸因於公司國籍或尚未公開的 LFM3 語言資料比例。
如果要驗證,我會這樣測
- 用自己的 50 到 100 題做 baseline,不要追官方 benchmark。題目要包含錯字、缺欄位、簡體字、客戶自創的縮寫。同一批題目同時跑 LFM3、現在的雲端模型、現在的地端模型。
- 繁中分開測。模型卡寫了 16 種輸出語言,包含中文(zh),但沒有繁中、更沒有台灣用語的分數。「合約審閱」「資安事件通報」「請款單」各測一輪,看它會不會默默轉成簡體。
- 量化後先測工具呼叫。Bonsai 27B 的紀錄可以參考:從 FP16 原版壓到 1-bit 三元版本,TauBench 從 82.9 掉到 61.3,掉最多的是指令遵循與工具呼叫。LFM3 在裝置端是用 llama.cpp 的 Q4_0 測,Q4 之後掉多少,要靠自己測(Bonsai 的數字整理在 LLM WIKI 的
bonsai-27b-qwen36-compression-local-inference-democratization,原始來源是 PrismML 的發布與第三方評測)。 - 測併發與延遲,不要只測單筆速度,要看你的尖峰同時有幾個人用(見上面 DGX Spark 的數字)。另外也要測微調之後:拿 2,000 到 3,000 筆自家歷史資料做 SFT,用保留集看有沒有真的提升。
坦白說
授權不是 Apache 2.0 這類寬鬆授權,大公司商用有門檻。 LFM3 用的是 LFM Open License v1.0,條文把「Threshold」定義為年營收 1,000 萬美元以上,超過門檻的法人,商業使用「not licensed under this Agreement」。台灣不少中大型企業與上市櫃公司都在這條線之上,我讀到的授權條文裡,沒有寫超過門檻後怎麼取得授權。這要先送法務與採購,不要等 POC 做完才卡在合約。
官方宣稱還沒有人驗。 打平 Gemma 4 12B、Pareto #1、MacPaw 的 LLM Efficiency Lead Ivan Petrukha 說「64% task success versus 48%」,都是發布當天的官方與合作方說法。Pipette 是 Liquid AI 與 Artificial Analysis 合作的裝置端基準平台,合格條件是量化後含 8K KV cache 塞進 8 GB 記憶體;官方部落格也寫「On-device, we measure metrics with llama.cpp at Q4_0 and a 32K-token context.」。條件合理,但那是量測條件,不是你的使用條件。
決策模型的邊界很窄,而且小模型會安靜地犯錯。 d1-2B 的模型卡說知識型問題要靠大模型,超過大約 64K token 的 state 之後開始不穩,它不是聊天模型、也不產生逐字對談。更麻煩的是,小模型答錯時,答得一樣流暢、一樣自信。這種錯要靠驗收流程抓,不是靠模型自己。這輪實測就抓到一例:中文語音問答把訂單號 7391 聽成 731,而且它答得很順。我仍未看到繁中、台灣在地場景的公開第三方評測,本文的 5090 實測是目前第一手資料。
五個可以立刻做的動作
- 先下載 LFM3 的權重跑起來,挑大約 30 個公司過去一週真的發生過的問題去問它。要注意工具鏈還沒完全跟上:截至 10 月 29 日,Ollama 0.40.12 內建的 llama.cpp 仍不認得
lfm3架構,mlx-lm 也不支援,得上游自行編譯(llama.cpp 已有src/models/lfm3.cpp)。這一步不用買任何東西,目的是建立第一手體感。 - 挑一個題目固定、量大、資料敏感的流程,用 d1-2B 跑 500 筆歷史資料,算準確率與校準,跟現行做法比。
- 把授權丟給法務與採購,這一題比 POC 優先:公司年營收是否超過門檻、超過之後怎麼授權、微調後的權重能不能交付客戶。
- 建立繁中測試集,用台灣用語,至少 50 題,涵蓋合約、請款、客訴、資安通報。這份測試集不會因為模型換代而作廢。
- 設計「小模型 + 大模型」的分流規則:高頻、固定、機敏的交給裝置端,需要知識、寫程式、長文的交給雲端或更大的地端模型。分流的方向,我在 On-Prem 小模型爆發時代來了 寫過:地端不能完全取代雲端,deep reasoning、複雜 agent、長 context 仍是雲端的強項,重點是分流。上線前的架構配置,可以看 企業級地端 LLM 系統架構藍圖。想知道地端能解掉哪些以前做不到的需求,可以先看 地端模型的三個新用途。
我的判斷
LFM3 重要,不是因為它有多強,而是它把「企業專屬小模型」做成一條可以直接下單的產品線。過去要做專屬模型,資料要夠、GPU 要夠、模型要夠小、部署要夠簡單,四件事同時成立的成本很高;Liquid AI 把它們包成六個模型、同一個底座、單張 GPU 微調、跑在十幾種處理器上。
但最後決定能不能落地的,不是 benchmark,是授權、繁中與驗收流程。這三件事官方部落格都沒有替你做完。
所以 Liquid AI 是不是真的讓 LFM3 站上裝置端智能的 Pareto 第一名,等有人用同一個硬體、同一個量化、同一批題目跑過再說。在那之前,我把它當成一個值得花半天試裝的選項,而不是一份可以直接交出去的簡報。
顧問服務
如果貴公司正在評估把哪些 AI 工作搬到地端或裝置端,我可以做一次導入評估,從場景盤點、模型選型到驗收方式一起看。待補:企業導入評估表單
參考資料
- Liquid AI,Introducing LFM3: Every Modality for Specialized Intelligence,2026-10-27
- Liquid AI,@liquidai 發布貼文,2026-10-27
- Hugging Face,LiquidAI/LFM3-1.7B、LFM3-VL-2B、LFM3-Audio-2B、LFM3-Omni-2B
- Hugging Face,LiquidAI/d1-2B、LiquidAI/d1-Omni-2B
- Liquid AI,LFM Open License v1.0
- Liquid AI,Pipette: on-device AI benchmarking by Liquid AI
- Artificial Analysis,Benchmarking pocket-scale inference
- 本文作者過去的實測與觀察:Strata 跑 Qwen3.8-Flash-Next、DGX Spark 測試實錄