Opus 5.5 出了:一句話做出兩支影片,厲害的不是生成,是驗收
「你可以把我昨天寫的 jev 變成教學影片」。
今天早上我在 Claude Code 桌面版丟給 Opus 5.5 的,就這一句。沒給檔名,沒說長度,也沒說要什麼風格。我的 blog 有兩篇 Jev 文章,9/22 一篇、9/24 一篇,它看檔案時間挑了 9/24 那篇。
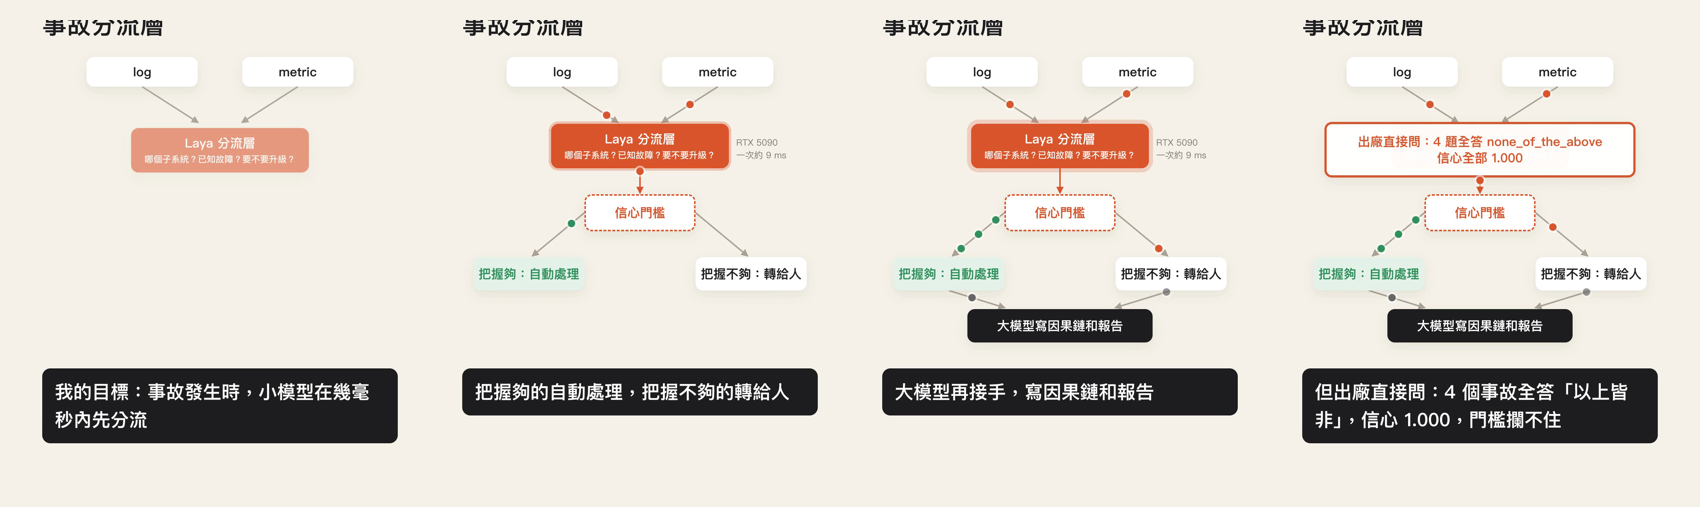
14 分鐘後我拿到一支 10 分鐘的教學片,再 19 分鐘拿到一支 3 分鐘、每一頁都有動態架構圖的直式短版。兩支影片的原始碼加起來 6 個檔案、1,262 行,全是它寫的。
30 秒定位
| 教學版 | 直式短版 | |
|---|---|---|
| 規格 | 1920x1080,9 分 59 秒 | 1080x1920,3 分鐘,30fps |
| 內容 | 16 頁、147 句字幕 | 10 頁,每頁一張動態架構圖 |
| 做法 | HTML 截圖+逐句語音+ffmpeg | HTML/CSS 動畫,Chrome 逐格截 5400 格 |
| 耗時 | 14 分鐘 | 不到 19 分鐘 |
先盤點,再選路
它沒有直接開始寫程式,先跑了一輪環境盤點:有 ffmpeg、有 Chrome、有 PIL;沒有 OpenAI key,不能用外部語音合成;沒有 playwright,不能用瀏覽器自動化錄動畫。macOS 有內建的台灣中文語音「美佳」。
然後就用這些現成的東西組 pipeline,一個套件都沒裝。
中間撞了兩次牆,都沒有叫我裝東西:
- 本機 ffmpeg 沒有字幕濾鏡(libass),改用 Python 把字幕畫進每一格畫面
- 要逐格截動畫,發現 Node 26 內建 WebSocket,就直接接 Chrome DevTools Protocol,寫了一個 68 行的截圖程式,沒裝 puppeteer
它選路線的依據是這台機器上實際有什麼,不是它記得通常怎麼做。
它會聽自己的配音
寫講稿之前,先合成 10 個專有名詞,丟給 5090 上的 Whisper 聽回來:
- Qwen 被聽成「Quin」→ 旁白改唸「千問」,字幕照樣顯示 Qwen
- 「參數」被聽成「猜數」→ 換個唸法
唸給耳朵聽的文字和給眼睛看的文字,它拆成兩份處理。
影片做完,再抽 3 個時間點(100 秒、330 秒、520 秒)回聽,跟畫面字幕比對一致才交件。
它會看自己的畫面
投影片做完,它拼縮圖牆自己檢查。教學版抓到「結束」框被擠成直排,改了才輸出。
直式短版更嚴重。架構圖元素多,前後跑了三輪截圖修正:第一輪箭頭壓到標籤、兩欄標題撞在一起;第二輪修好的箭頭又壓到另一行;第三輪淡化的文字跟新標題疊在一起。每一輪都是改完、重新截圖、再看一次。
最後還比對相隔 0.3 秒的兩格畫面,確認動畫真的有在動,不是一張靜態圖放 3 分鐘。
假數字全部標「示意」
教學影片需要例子,它加了幾組它編的數字——天氣機率、工單分數、Jev 的把握度。畫面上全部標了「示意」。原文的數字 0.362、0.921、5.7 倍,一個都沒改。
我的 blog 最在意的就是數字是真的。一個會為了教學效果編數字、又不標出來的工具,我不敢用。
坦白說
旁白用的是 macOS 標準語音,機器感明顯。教學版第一版 10.7 分鐘比預估的長,調快語速後才是 9 分 59 秒。直式短版的排版錯了三輪。每一個問題都是它自己抓到的,但也代表第一版是有問題的。
我的指令本身也有漏洞。第二次下指令時我打成「给我制作一个 的视频」,中間漏了一個字,它沒有停下來問。
這只是一篇文章、一個早上的樣本。影片還沒上架,「做得出來」和「有人想看」是兩件事。
關鍵洞察
- 看 AI 會不會做一件事,先看它有沒有驗收的管道。 這次的關鍵不是生成,是 Whisper 回聽和截圖檢查。你的 agent 環境裡有沒有「讓它看見自己錯誤」的工具,比換模型更重要。
- 讓 AI 產出原始碼,不要只產出成品。 這次產出的是影片的原始碼,改一句話重跑就能重新輸出。成品只能用一次。
- 值錢的還是你的原始內容。 做影片的流程十幾分鐘就寫好了,查證過的文章和實驗數據,AI 替你生不出來。
常見問題 Q&A
Q: Opus 5.5 可以直接把一篇部落格文章做成影片嗎?
可以,但它不是呼叫影片生成服務,而是自己寫程式組出製作流程(pipeline)。這次 Opus 5.5 在 Claude Code 裡,用本機的 ffmpeg、Chrome 無頭模式(Headless Chrome)和 macOS 台灣中文語音,把一篇技術文章做成 9 分 59 秒的教學片(14 分鐘完成)和 3 分鐘的直式動態架構圖短版(19 分鐘完成),6 個檔案共 1,262 行程式碼,一個外部套件都沒裝。
Q: AI 做的影片,怎麼確認內容沒有出錯?
這次用了兩種驗收:語音用 Whisper 語音轉文字(Speech-to-Text)轉回文字比對字幕,畫面用截圖拼縮圖牆逐頁檢查。Opus 5.5 在生成前先測 10 個專有名詞的發音,發現 Qwen 會被唸成「Quin」就改唸「千問」;成品完成後再抽時間點回聽。直式短版的架構圖跑了三輪截圖修正才沒有元素重疊。
Q: 什麼情況下不適合用 AI 這樣做影片?
如果只做一支、很在意美術品質,熟悉剪映或 Canva 的人手動做可能一樣快、效果更好。AI 寫程式產影片的優勢在它變成可修改的原始碼(Source Code),改一行重跑就能重新輸出,適合持續把文章轉影片的人。另外 macOS 標準語音機器感明顯,聲音品質是目前的主要限制。